Daten auswerten und visualisieren: Diagramme, Mittelwerte und Streuung
https://bildung.social/@oerinformatik/
https://oer-informatik.de/datenauswertung-statistik
Datenauswertung, deskriptive Statistik, Diagramm, Mittelwert, Median, Standardabweichung, Varianz, Häufigkeit, Auslastung, Datenvisualisierung, SQL, Tabellenkalkulation
tl/dr; (ca. 19 min Lesezeit): Aus Zahlen werden erst durch Auswertung und Darstellung Entscheidungen. Der Artikel zeigt, wie Du absolute und relative Häufigkeiten und Anteile aus mehreren Gruppen richtig berechnest, Mittelwert, Median und Modus bestimmst und die Streuung mit Spannweite, Varianz und Standardabweichung beschreibst. Du berechnest Auslastungen aus Nutzungsdaten, ermittelst die Kennzahlen mit SQL und Tabellenkalkulation, wählst das passende Diagramm samt Achsen, Legende und ggf. zweiter y-Achse und leitest aus Daten begründete Erkenntnisse ab, ohne in typische Fallen wie „Korrelation gleich Ursache“ zu tappen [AI-Assisted]. (Zuletzt geändert am 27.10.2026)
Dieser Artikel gehört zu den Artikeln über Datenanalyse: Daten auswerten und visualisieren / Prognosen mit linearer Regression / Grundlagen des maschinellen Lernens / Übungsaufgaben: Daten auswerten und visualisieren
Schon fit in diesem Thema? Nutze die Kann-Liste und die Leitfragen unter dem Artikel als Checkliste, ob Du die relevanten Kompetenzen bereits hast.
Als Grundlagen kann ich nach Durchlesen des Artikels…
… absolute und relative Häufigkeiten berechnen und Anteile aus mehreren Gruppen richtig zusammenführen.
… arithmetisches Mittel, Median und Modus berechnen, ihre Bedeutung beschreiben und begründen, welches Lagemaß bei Ausreißern aussagekräftiger ist.
… Spannweite, Varianz und Standardabweichung berechnen und die Standardabweichung interpretieren.
… aus Nutzungsdaten durchschnittliche und maximale Auslastungen ermitteln und beurteilen.
… für eine Fragestellung ein geeignetes Diagramm auswählen und mit Titel, beschrifteten Achsen und Legende entwerfen.
… aus Tabellen und Diagrammen statistische Erkenntnisse beschreiben und für eine Planung nutzen.
Darüber hinaus kann ich als Expertenwissen…
… Standardabweichung der Grundgesamtheit und der Stichprobe unterscheiden und Kennzahlen mit SQL-Aggregatfunktionen und Tabellenkalkulationsfunktionen berechnen.
… erläutern, wann eine zweite y-Achse nötig ist, und Lesefallen in Diagrammen erkennen.
… Zusammenhänge zwischen Datenreihen (auch zeitverzögert) herstellen, Ursachen begründet ableiten und Korrelation von Kausalität unterscheiden.
Ein Unternehmen plant ein neues Zutrittssystem, ein Rechenzentrum wundert sich über schwankenden Stromverbrauch, eine Werkstatt will wissen, wie lange eine Montage dauert. In allen Fällen liegen Daten vor – aus Datenbanken, Protokollen, Sensoren oder Tabellen. Entscheidungen lassen sich daraus erst ableiten, wenn die Daten verdichtet (Kennzahlen), dargestellt (Diagramme) und interpretiert werden. Dieser Artikel behandelt die dafür nötigen Werkzeuge der beschreibenden (deskriptiven) Statistik.
Vom Datenbestand zur Erkenntnis
Eine Datenauswertung folgt meist diesen Schritten:
Fragestellung klären: Was soll entschieden werden? (z. B. „Wie viele Kontrollspuren braucht jedes Tor?“)
Daten beschaffen und prüfen: Woher kommen die Daten, sind sie vollständig, plausibel und vergleichbar (gleicher Zeitraum, gleiche Einheit)?
Daten aufbereiten: gruppieren, summieren, Anteile umrechnen, Ausreißer markieren.
Kennzahlen berechnen: Häufigkeiten, Mittelwerte, Streuung, Auslastung.
Visualisieren: das passende Diagramm wählen.
Interpretieren: Was bedeuten die Zahlen für die Fragestellung? Welche Grenzen hat die Auswertung?
Merkmale und Skalenniveaus
Welche Kennzahlen sinnvoll sind, hängt von der Art des Merkmals ab:
| Skalenniveau | Eigenschaft | Beispiele | sinnvolle Kennzahlen |
|---|---|---|---|
| nominal | nur Kategorien, keine Reihenfolge | Bestellweg, Personengruppe, Gerätetyp | Häufigkeiten, Anteile, Modus |
| ordinal | Kategorien mit Rangfolge, Abstände nicht interpretierbar | Schulnoten, Zufriedenheit „gut/mittel/schlecht“, Prioritäten | zusätzlich Median |
| metrisch | Zahlen mit sinnvollen Abständen | Dauer in Minuten, Temperatur, Leistung in kW, Anzahl | zusätzlich Mittelwert, Spannweite, Varianz, Standardabweichung |
Ein Mittelwert von Bestellwegen oder von Postleitzahlen ergibt also keinen Sinn, auch wenn ein Programm ihn ausrechnen würde.
Häufigkeiten und Anteile
Die absolute Häufigkeit zählt, wie oft ein Wert vorkommt. Die relative Häufigkeit setzt sie ins Verhältnis zur Gesamtzahl:
h = \frac{\text{absolute Häufigkeit}}{\text{Gesamtzahl}} \cdot 100\,\%
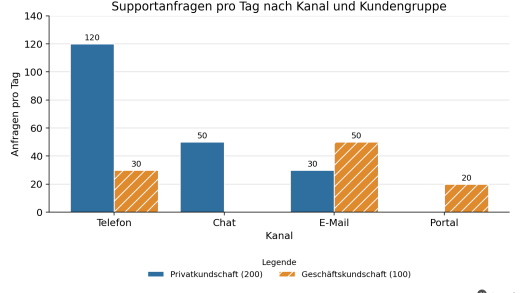
Oft liegen Daten bereits als Anteile je Gruppe vor. Beispiel: Ein IT-Support erhält pro Tag 200 Anfragen von Privatkund*innen (60 % Telefon, 25 % Chat, 15 % E-Mail) und 100 Anfragen von Geschäftskund*innen (30 % Telefon, 50 % E-Mail, 20 % Portal). Wie viele Anfragen kommen insgesamt über das Telefon?
Zuerst rechnest Du die Anteile je Gruppe in absolute Zahlen um, dann addierst Du und rechnest erst zum Schluss wieder in Anteile um:
| Kanal | Privat (200) | Geschäft (100) | Summe | Anteil an allen 300 |
|---|---|---|---|---|
| Telefon | 200 · 60 % = 120 | 100 · 30 % = 30 | 150 | 50,0 % |
| Chat | 200 · 25 % = 50 | 0 | 50 | 16,7 % |
| 200 · 15 % = 30 | 100 · 50 % = 50 | 80 | 26,7 % | |
| Portal | 0 | 100 · 20 % = 20 | 20 | 6,7 % |
| Summe | 200 | 100 | 300 | 100,0 % |
Achtung: Der Telefonanteil ist nicht der Durchschnitt aus 60 % und 30 % (45 %), sondern 50 %, weil die Privatkundschaft doppelt so viele Anfragen stellt. Prozentwerte verschieden großer Gruppen darf man nicht einfach mitteln; sie müssen gewichtet werden. Zur Kontrolle muss die Summe der absoluten Werte die Gesamtzahl und die Summe der Anteile 100 % ergeben (bis auf Rundungsdifferenzen).
Lagemaße: Mittelwert, Median, Modus
Lagemaße beschreiben, wo die „Mitte“ der Daten liegt.
Arithmetisches Mittel (Durchschnitt, \bar{x}): Summe aller Werte geteilt durch ihre Anzahl.
\bar{x} = \frac{x_1 + x_2 + \dots + x_n}{n} = \frac{1}{n}\sum_{i=1}^{n} x_i
Median (Zentralwert): Der Wert in der Mitte der sortierten Reihe. Bei ungerader Anzahl ist es der mittlere Wert, bei gerader Anzahl der Mittelwert der beiden mittleren Werte. Die Hälfte der Werte liegt darunter, die Hälfte darüber.
Modus (Modalwert): der häufigste Wert. Er ist auch für nominale Merkmale bestimmbar.
Gewichtetes Mittel: Haben Werte unterschiedliches Gewicht (z. B. Gruppen unterschiedlicher Größe), wird jeder Wert mit seinem Gewicht multipliziert und durch die Summe der Gewichte geteilt – siehe das Telefon-Beispiel oben.
Ausreißer: Die Antwortzeiten eines Servers betragen in sieben Messungen 42, 38, 45, 40, 41, 39 und 250 ms. Der Mittelwert ist \frac{495\,\text{ms}}{7} \approx 70{,}7\,\text{ms} – höher als sechs der sieben Werte. Der Median der sortierten Reihe 38, 39, 40, 41, 42, 45, 250 ist 41 ms und beschreibt die typische Antwortzeit besser. Der Median ist robust gegen Ausreißer, der Mittelwert nicht. Ausreißer sollten aber nicht einfach gestrichen werden: Sie können ein Messfehler sein oder gerade das Wichtigste (hier vielleicht ein Engpass).
Mittelwert und Erwartungswert: In Aufgaben und Programmen heißt der Mittelwert einer Messreihe manchmal „Erwartungswert“. Streng genommen ist der Erwartungswert \mu eine Eigenschaft einer Wahrscheinlichkeitsverteilung; der Mittelwert \bar{x} einer Messreihe ist seine Schätzung. Haben alle Werte die gleiche Wahrscheinlichkeit \frac{1}{n}, ergibt die Formel \mu = \sum x_i \cdot P(x_i) genau den Mittelwert.
Streuungsmaße: Wie stark weichen die Werte ab?
Zwei Support-Teams bearbeiten im Mittel 20 Tickets pro Tag. Team A: 20, 22, 19, 21, 18. Team B: 10, 30, 15, 28, 17. Der Mittelwert ist gleich, die Planbarkeit völlig verschieden. Streuungsmaße beschreiben diesen Unterschied:
Minimum, Maximum und Spannweite: R = x_{max} - x_{min}. Team A: 22 - 18 = 4, Team B: 30 - 10 = 20. Einfach, aber nur von zwei Werten abhängig.
Varianz \sigma^2: der Mittelwert der quadrierten Abweichungen vom Mittelwert.
\sigma^2 = \frac{1}{n}\sum_{i=1}^{n} (x_i - \bar{x})^2
Standardabweichung \sigma: die Wurzel aus der Varianz. Sie hat dieselbe Einheit wie die Daten und gibt an, wie weit die Werte typischerweise vom Mittelwert abweichen. Je größer sie ist, desto stärker streuen die Werte; bei 0 sind alle Werte gleich.
\sigma = \sqrt{\sigma^2}
Rechenweg für Team B:
| Tag | x_i | x_i - \bar{x} | (x_i - \bar{x})^2 |
|---|---|---|---|
| 1 | 10 | -10 | 100 |
| 2 | 30 | 10 | 100 |
| 3 | 15 | -5 | 25 |
| 4 | 28 | 8 | 64 |
| 5 | 17 | -3 | 9 |
| Summe | 100 | 0 | 298 |
\bar{x} = \frac{100}{5} = 20 \qquad \sigma^2 = \frac{298}{5} = 59{,}6 \qquad \sigma = \sqrt{59{,}6} \approx 7{,}720
Für Team A ergibt sich \sigma = \sqrt{\frac{10}{5}} \approx 1{,}414. Interpretation: Team A arbeitet sehr gleichmäßig, bei Team B schwankt die Tageslast stark – hier braucht die Personalplanung Reserven oder eine Erklärung der Schwankungen.
Grundgesamtheit oder Stichprobe? Die Formel oben teilt durch n und beschreibt die vorliegenden Werte selbst (Grundgesamtheit). Sollen die Werte als Stichprobe eine größere Menge schätzen, teilt man durch n - 1 und schreibt s statt \sigma:
s = \sqrt{\frac{1}{n-1}\sum_{i=1}^{n} (x_i - \bar{x})^2}
Für Team B ergibt sich s = \sqrt{298 / 4} \approx 8{,}631. Bei vielen Werten ist der Unterschied klein. Wichtig ist, in Programmen die richtige Funktion zu wählen (siehe unten). Wird der Mittelwert vor der Rechnung gerundet, entstehen kleine Abweichungen; besser rechnest Du mit dem ungerundeten Mittelwert.
Variationskoeffizient: Wer die Streuung von Reihen mit verschiedenen Mittelwerten oder Einheiten vergleichen will, teilt die Standardabweichung durch den Mittelwert: v = \frac{\sigma}{\bar{x}} (Team A 7 %, Team B 39 %).
Faustregel für glockenförmige Verteilungen: Sind die Werte ungefähr normalverteilt, liegen etwa zwei Drittel (68 %) im Bereich \bar{x} \pm \sigma und etwa 95 % im Bereich \bar{x} \pm 2\sigma.
Quartile und Boxplot: Der Median teilt die sortierten Werte in zwei Hälften. Die Quartile teilen sie in Viertel: Bis zum unteren Quartil Q_1 reicht etwa ein Viertel der Werte, bis zum oberen Quartil Q_3 etwa drei Viertel. Der Interquartilsabstand IQR = Q_3 - Q_1 gibt an, wie breit die mittlere Hälfte der Werte streut; anders als die Spannweite ist er robust gegen Ausreißer. Für die Antwortzeiten 38, 39, 40, 41, 42, 45 und 250 ms ergeben sich (wie mit QUARTILE.INKL berechnet) Q_1 = 39{,}5 ms, der Median 41 ms, Q_3 = 43{,}5 ms und IQR = 4 ms – die Spannweite beträgt dagegen 212 ms. Für Quartile gibt es mehrere Berechnungsverfahren; bei wenigen Werten weichen die Ergebnisse leicht voneinander ab.
Ein Boxplot zeigt diese Kennzahlen auf einen Blick: Die Box reicht von Q_1 bis Q_3, der Strich in der Box markiert den Median. Die Antennen (engl. Whisker) reichen bis zum kleinsten bzw. größten Wert, der höchstens 1{,}5 \cdot IQR von der Box entfernt liegt; Werte außerhalb werden als Ausreißer einzeln eingezeichnet. Mehrere Boxplots nebeneinander eignen sich gut, um Verteilungen zu vergleichen, z. B. die Antwortzeiten mehrerer Server.

Auslastung aus Nutzungsdaten ermitteln
Für Investitionen und Einsatzplanung ist oft die Auslastung von Geräten, Räumen oder Personal gefragt. Vorgehen:
Nutzungszeiten je Gerät aufsummieren (Buchungen, Betriebsstunden).
Geräte nach Typ gruppieren und je Typ die durchschnittliche Nutzung je Gerät (Summe : Anzahl Geräte) und die maximale Nutzung eines Geräts bestimmen.
Den Auslastungsgrad berechnen: \text{Auslastung} = \frac{\text{tatsächliche Nutzungszeit}}{\text{verfügbare Zeit}} \cdot 100\,\%.
Beurteilen: Sind Geräte überlastet (Engpass, Wartezeiten, Ausfallrisiko) oder kaum genutzt (Kosten ohne Nutzen)? Ein Optimierungsvorschlag nennt eine konkrete Maßnahme, z. B. ein Gerät abgeben, Buchungen umverteilen, Nutzungszeiten verlängern oder ein Gerät mit einer anderen Abteilung teilen.
Beispiel: Zwei Beamer eines Schulungszentrums werden an einem Tag 7 h und 2 h genutzt (Öffnungszeit 8 h). Durchschnitt 4,5 h je Gerät (56 %), Maximum 7 h (88 %). Ein Beamer ist fast ausgelastet, der andere kaum: Die Buchungen sollten gleichmäßiger verteilt werden; ein dritter Beamer ist nicht nötig.
Kennzahlen mit SQL und Tabellenkalkulation
Liegen die Daten in einer Datenbank, liefern Aggregatfunktionen die Kennzahlen je Gruppe (siehe Aggregierende Funktionen). Die Funktionsnamen unterscheiden sich je nach Datenbanksystem, vor allem bei Standardabweichung und Median. Beispiel für die Tabelle tickets_pro_tag (team, tag, tickets):
SELECT team,
       COUNT(*)                       AS tage,
       ROUND(AVG(tickets), 2)         AS mittelwert,
       MIN(tickets)                   AS minimum,
       MAX(tickets)                   AS maximum,
       ROUND(STDDEV_POP(tickets), 2)  AS std_grundgesamtheit,
       ROUND(STDDEV_SAMP(tickets), 2) AS std_stichprobe
FROM tickets_pro_tag
GROUP BY team;

-- Median: nur MariaDB (ab 10.3.3) als Fensterfunktion, MySQL kennt kein MEDIAN
SELECT DISTINCT team,
       MEDIAN(tickets) OVER (PARTITION BY team) AS median
FROM tickets_pro_tag;
STDDEV() und STD() sind in MariaDB/MySQL Synonyme für STDDEV_POP() (Teilen durch n).
Ergebnis für das Beispiel: Team A – 5 Tage, Mittelwert 20,00, Minimum 18, Maximum 22, Standardabweichung 1,41 (Stichprobe 1,58), Median 20; Team B – 5 Tage, Mittelwert 20,00, Minimum 10, Maximum 30, Standardabweichung 7,72 (Stichprobe 8,63), Median 17.
In der Tabellenkalkulation stehen dieselben Kennzahlen als Funktionen bereit:
| Kennzahl | deutsche Funktion | englische Funktion |
|---|---|---|
| Anzahl der Zahlen | ANZAHL(B2:B6) |
COUNT(B2:B6) |
| Mittelwert | MITTELWERT(B2:B6) |
AVERAGE(B2:B6) |
| Median | MEDIAN(B2:B6) |
MEDIAN(B2:B6) |
| Modus | MODUS.EINF(B2:B6) |
MODE.SNGL(B2:B6) |
| Minimum, Maximum | MIN(B2:B6), MAX(B2:B6) |
MIN(B2:B6), MAX(B2:B6) |
| Standardabweichung (Grundgesamtheit) | STABW.N(B2:B6) |
STDEV.P(B2:B6) |
| Standardabweichung (Stichprobe) | STABW.S(B2:B6) |
STDEV.S(B2:B6) |
| Varianz (Grundgesamtheit) | VAR.P(B2:B6) |
VAR.P(B2:B6) |
| unteres bzw. oberes Quartil | QUARTILE.INKL(B2:B6;1) bzw. QUARTILE.INKL(B2:B6;3) |
QUARTILE.INC(B2:B6,1) bzw. QUARTILE.INC(B2:B6,3) |
| Mittelwert mit Bedingung | MITTELWERTWENN(A2:A11;"B";B2:B11) |
AVERAGEIF(A2:A11,"B",B2:B11) |
Das passende Diagramm wählen
Ein Diagramm soll eine Aussage schnell sichtbar machen. Welches passt, hängt von der Frage ab:
| Fragestellung | geeignetes Diagramm | Beispiel |
|---|---|---|
| Werte verschiedener Kategorien vergleichen | Säulen- oder Balkendiagramm (Balken bei langen Beschriftungen) | Anfragen je Kanal |
| Kategorien vergleichen, unterteilt nach Gruppen | gruppiertes Säulendiagramm (Gruppen nebeneinander) | Anfragen je Kanal und Kundengruppe |
| Zusammensetzung einer Summe zeigen | gestapeltes Säulendiagramm (absolut oder 100 %) | Anteil der Kundengruppen an jedem Kanal |
| Anteile eines Ganzen (wenige Teile) | Kreis- oder Ringdiagramm | Verteilung aller Anfragen auf vier Kanäle |
| Entwicklung über die Zeit | Liniendiagramm (bei wenigen Zeitpunkten auch Säulen) | Leistungsaufnahme über den Tag, Schädlingsbefall je Monat |
| Zusammenhang zweier metrischer Merkmale | Streudiagramm (Punktwolke) | Eintrittspreis und Gästezahl |
| Verteilung einer Messgröße | Histogramm, Boxplot | Montagezeiten, Antwortzeiten |
Zu einem vollständigen Diagramm gehören:
ein Titel, der sagt, was gezeigt wird (mit Zeitraum),
beschriftete Achsen mit Größe und Einheit (z. B. „Anteil in %“, „Leistung in kW“),
eine Legende, wenn mehrere Datenreihen gezeigt werden, und Muster oder Beschriftungen, die auch ohne Farbe unterscheidbar sind,
bei Säulen und Balken eine y-Achse, die bei 0 beginnt,
ggf. die Datenquelle und die Zahl der zugrunde liegenden Werte.

Für eine Skizze von Hand genügt ein sauberes Achsenkreuz mit Skala, Kategorien, Säulen in passender Höhe (Werte darüberschreiben), Schraffuren statt Farben und einer Legende.
Zwei Datenreihen mit unterschiedlichen Wertebereichen
Sollen zwei Größen mit sehr verschiedenen Wertebereichen in einem Diagramm erscheinen, z. B. Anmeldungen pro Stunde (200–1.200) und Fehlerquote (0,4–2,8 %), wird die kleine Reihe auf einer gemeinsamen y-Achse zur flachen Linie: Ihr Verlauf ist nicht mehr zu erkennen. Abhilfe schafft eine zweite y-Achse (Sekundärachse) rechts mit eigenem Maßstab. Dann gehört an jede Achse die Beschriftung mit Einheit, und die Reihen sollten farblich oder durch Linienart eindeutig ihrer Achse zugeordnet sein. Alternativ lassen sich zwei Diagramme mit gleicher x-Achse untereinander stellen oder die Werte auf einen gemeinsamen Index (z. B. Anteil am Höchstwert in %) umrechnen.

Lesefallen, die Du in fremden Diagrammen erkennen solltest: abgeschnittene y-Achse bei Säulen (kleine Unterschiede wirken riesig), 3D-Effekte und schräge Kreise (verzerren Flächen), zu viele Kreissegmente, ungleiche Zeitabstände auf der x-Achse, zwei y-Achsen, deren Maßstäbe einen Zusammenhang nur vortäuschen.
Daten interpretieren und Zusammenhänge erkennen
Eine statistische Erkenntnis verbindet eine Zahl mit ihrer Bedeutung für die Fragestellung, z. B.: „Über Tor 1 laufen rund zwei Drittel aller Zutritte, vor allem morgens zwischen 6 und 8 Uhr; dort muss das Zutrittssystem die meisten Kontrollspuren haben.“ Gute Aussagen nennen die Größe (absolut und/oder Anteil), den Zeitbezug (Spitzen, Verlauf) und die Folgerung.
Beim Herstellen von Zusammenhängen zwischen Datenreihen hilft:
Gemeinsamer Verlauf: Steigen und fallen zwei Reihen gemeinsam (z. B. CPU-Auslastung und Leistungsaufnahme eines Rechenzentrums), liegt ein Zusammenhang nahe. Mehr Rechenlast bedeutet mehr Stromverbrauch der Prozessoren und mehr Kühlleistung.
Zeitverzögerung: Wirkungen treten oft später ein, z. B. wirkt eine Maßnahme gegen Schädlinge erst einen Monat später auf den Ertrag, eine Lüftung erst nach einigen Minuten auf den CO₂-Wert.
Korrelation ist keine Kausalität: Zwei Reihen können gemeinsam schwanken, weil eine dritte Größe beide beeinflusst (z. B. die Tageszeit). Eine Ursache ist erst begründet, wenn ein plausibler Wirkmechanismus besteht und andere Erklärungen geprüft sind.
Weitere Daten hinzuziehen: Um Ursachen einzugrenzen, werden passende Messgrößen ergänzt, z. B. bei Leistungsschwankungen im Rechenzentrum CPU- und Speicherauslastung, Netzwerkdurchsatz, Festplattenzugriffe, Zahl laufender Jobs und Kühlleistung (siehe Systemüberwachung).
Grenzen nennen: kurzer Zeitraum, wenige Werte, fehlende Einflussgrößen, Rundungen. Prognosen auf Basis solcher Daten, etwa mit einer linearen Regression, sind nur Schätzungen (siehe Prognosen mit linearer Regression).
Typische Fehler
Prozentwerte unterschiedlich großer Gruppen ungewichtet mitteln.
Den Median ohne vorheriges Sortieren bestimmen oder bei gerader Anzahl einen der beiden mittleren Werte nehmen.
Bei der Standardabweichung die Wurzel vergessen (das ist die Varianz) oder die Abweichungen nicht quadrieren (ihre Summe ist immer 0).
In SQL
STDDEVverwenden, ohne zu wissen, ob das System durch n oder n - 1 teilt.Mittelwerte von nominalen Merkmalen berechnen.
Diagramme ohne Achsenbeschriftung, Einheit oder Legende zeichnen; Säulen mit abgeschnittener y-Achse.
Zwei Datenreihen mit verschiedenen Wertebereichen auf einer y-Achse darstellen.
Aus einem gemeinsamen Verlauf ohne Begründung auf eine Ursache schließen.
Leitfragen
- Wie führst Du Anteile aus mehreren Gruppen zu einem Gesamtanteil zusammen?
Anteile je Gruppe mit der Gruppengröße in absolute Zahlen umrechnen, je Kategorie addieren und erst dann durch die Gesamtzahl teilen. Prozentwerte verschieden großer Gruppen nie ungewichtet mitteln; siehe Abschnitt „Häufigkeiten und Anteile“.
- Wann ist der Median aussagekräftiger als der Mittelwert?
Wenn es Ausreißer oder eine schiefe Verteilung gibt: Der Median ist der mittlere Wert der sortierten Reihe und wird von Extremwerten nicht verzerrt, der Mittelwert schon; siehe Abschnitt „Lagemaße“.
- Was sagt die Standardabweichung aus, und wie berechnest Du sie?
Sie gibt an, wie weit die Werte typischerweise vom Mittelwert abweichen; je größer, desto stärker streuen sie. Rechnung: Abweichungen vom Mittelwert quadrieren, Mittelwert der Quadrate bilden (Varianz, Teilen durch n bzw. bei Stichproben n - 1), Wurzel ziehen; siehe Abschnitt „Streuungsmaße“.
- Wie ermittelst und beurteilst Du die Auslastung von Geräten?
Nutzungszeiten je Gerät summieren, je Typ Durchschnitt und Maximum bestimmen, ins Verhältnis zur verfügbaren Zeit setzen und dann beurteilen, ob Engpässe oder ungenutzte Kapazität vorliegen, mit einem konkreten Optimierungsvorschlag; siehe Abschnitt „Auslastung“.
- Welche SQL-Funktionen liefern Mittelwert, Standardabweichung und Median?
AVG(), MIN(), MAX() überall; Standardabweichung je nach System STDDEV_POP()/STDDEV_SAMP() (MariaDB, PostgreSQL, Oracle) bzw. STDEVP()/STDEV() (SQL Server); Median mit MEDIAN() (Oracle, in MariaDB als Fensterfunktion) oder PERCENTILE_CONT(0.5); siehe Abschnitt „Kennzahlen mit SQL und Tabellenkalkulation“.
- Welches Diagramm wählst Du für welche Fragestellung, und was gehört immer dazu?
Vergleich von Kategorien: Säulen/Balken (gruppiert bei Untergruppen), Anteile eines Ganzen: Kreis, Zeitverlauf: Linie, Zusammenhang: Streudiagramm, Verteilung: Histogramm/Boxplot. Immer: Titel, beschriftete Achsen mit Einheit, Legende bei mehreren Reihen, Säulenachse ab 0; siehe Abschnitt „Das passende Diagramm wählen“.
- Wann brauchst Du eine zweite y-Achse?
Wenn zwei Datenreihen sehr unterschiedliche Wertebereiche haben: Auf einer gemeinsamen Achse wird die kleinere zur flachen Linie. Eine zweite Achse mit eigenem Maßstab macht beide Verläufe sichtbar; siehe Abschnitt „Zwei Datenreihen“.
- Wie leitest Du aus Daten begründete Ursachen ab?
Gemeinsame und zeitverzögerte Verläufe suchen, einen plausiblen Wirkmechanismus angeben, Drittgrößen und andere Erklärungen prüfen, weitere Messgrößen hinzuziehen und die Grenzen der Daten nennen. Korrelation allein beweist keine Ursache; siehe Abschnitt „Daten interpretieren“.
Links und weitere Informationen
Tabellenkalkulation: Formeln, Bezüge und Funktionen sicher anwenden
Systemüberwachung: Monitoring-Kennwerte, SNMP, S.M.A.R.T. und Logs
zum Nachschlagen: MariaDB: Aggregate Functions
Hinweis zur Nachnutzung als Open Educational Resource (OER)
Dieser Artikel und seine Texte, Bilder, Grafiken, Code und sonstiger Inhalt sind - sofern nicht anders angegeben - lizenziert unter CC BY 4.0. Nennung gemäß TULLU-Regel bitte wie folgt: “Daten auswerten und visualisieren: Diagramme, Mittelwerte und Streuung” von oer-informatik.de (H. Stein), Lizenz: CC BY 4.0. Der Artikel wurde unter https://oer-informatik.de/datenauswertung-statistik veröffentlicht, die Quelltexte sind in weiterverarbeitbarer Form verfügbar im Repository unter https://gitlab.com/oer-informatik/daten-ki/datenanalyse-ki. Erstellt mit KI-Assistenz; von mir umfassend redaktionell überarbeitet, geprüft und freigegeben. Stand: 27.10.2026.
[Kommentare zum Artikel lesen, schreiben] / [Artikel teilen] / [gitlab-Issue zum Artikel schreiben]