Zeichenketten und Prüfziffern: Algorithmen für Codes, Nummern und Texte
https://bildung.social/@oerinformatik/
https://oer-informatik.de/zeichenketten-pruefziffern
Zeichenketten, Prüfziffer, Pseudocode, Modulo, GTIN, Luhn-Verfahren, IBAN, Leitweg-ID, Lauflängenkodierung, Algorithmen
tl/dr; (ca. 22 min Lesezeit): Barcodes, Sendungsnummern, IBAN, Ticketcodes und komprimierte Bilddaten haben eines gemeinsam: Ein Algorithmus muss Zeichenketten Zeichen für Zeichen lesen, Ziffern in Zahlen umwandeln, Teile zusammensetzen oder prüfen. Der Artikel zeigt die Grundoperationen auf Zeichenketten in Pseudocode, erklärt die verbreiteten Prüfziffernverfahren (gewichtete Summe modulo 10 wie bei GTIN/EAN, Luhn, Modulo 97 wie bei IBAN und Leitweg-ID), das Erzeugen eindeutiger Zufallscodes und die Lauflängenkodierung – jeweils mit den typischen Fehlern [AI-Assisted]. (Zuletzt geändert am 28.10.2026)
Dieser Artikel ist Teil einer Artikelreihe über Algorithmen und Programmentwurf: Algorithmen mit Pseudocode dokumentieren / Übersicht der Programmentwurfsmethoden / Prozedurale Algorithmen mit Arrays / Zeichenketten und Prüfziffern / Übungsaufgaben zu Zeichenketten und Prüfziffern
Schon fit in diesem Thema? Nutze die Kann-Liste und die Leitfragen unter dem Artikel als Checkliste, ob Du die relevanten Kompetenzen bereits hast.
Dieser Artikel baut auf der Kann-Liste des Artikels Prozedurale Algorithmen mit Arrays auf.
Als Algorithmik-Grundlagen kann ich nach Durchlesen des Artikels…
… eine Zeichenkette Zeichen für Zeichen durchlaufen und dabei zwischen Index (ab 0) und Stelle (ab 1) unterscheiden.
… Ziffernzeichen in Zahlen und Zahlen in Zeichenketten umwandeln und das Ergebnis gemischter Ausdrücke aus Text und Zahl vorhersagen.
… eine Zeichenkette nach einer Aufbauvorschrift aus Teilen zusammensetzen oder in Teile zerlegen und dabei führende Nullen und Trennzeichen beachten.
… eine Prüfziffer nach einer vorgegebenen Vorschrift (Gewichtung, Quersumme, Modulo) von Hand berechnen, einen Code damit prüfen, ihn gegebenenfalls berichtigen und das Ergebnis begründen.
… Algorithmen zum Berechnen und Prüfen von Prüfziffern als Pseudocode, Struktogramm oder Programmablaufplan darstellen.
… einen eindeutigen Code aus Zufallszeichen erzeugen und mit einer fußgesteuerten Schleife sicherstellen, dass er noch nicht vergeben ist.
… eine Zeichenkette mit Lauflängenkodierung komprimieren und dekomprimieren und Mehrdeutigkeiten der Kodierung erkennen und beheben.
Darüber hinaus kann ich als Algorithmik-Expertenwissen…
… die Verfahren GS1 (GTIN, SSCC), Luhn und ISO 7064 MOD 97-10 (IBAN, Leitweg-ID) unterscheiden und nennen, welche Eingabefehler sie erkennen.
… den Rest sehr großer Zahlen schrittweise berechnen, ohne die Zahl als Ganzzahl zu speichern.
… begründen, warum eine Prüfziffer vor Tippfehlern, aber nicht vor absichtlicher Fälschung schützt.
… Unterschiede zwischen Zeichen, Zeichencodes und Bytes (Unicode, UTF-8) bei Längenangaben berücksichtigen.
Ein Handscanner liest einen Barcode, eine Kundin tippt ihre IBAN ins Bestellformular, ein Check-in-Terminal scannt den QR-Code eines Tickets: In allen drei Fällen landet eine Zeichenkette (string) im Programm, die mehr ist als Text. Ihre Stellen haben eine Bedeutung, eine Stelle ist häufig eine Prüfziffer, und bevor die Software weiterarbeitet, muss sie prüfen, ob die Eingabe überhaupt stimmen kann.
In der Anwendungsentwicklung tauchen solche Aufgaben regelmäßig als umfangreiche Aufgabe auf: Eine Prüfziffer berechnen, einen Code erzeugen, Daten komprimieren. Die gute Nachricht: Die Vorschrift steht immer in der Aufgabe. Du musst sie nicht auswendig kennen, aber sicher in einen Algorithmus übersetzen können. Dafür brauchst Du die Grundmuster aus dem Artikel Prozedurale Algorithmen mit Arrays und eine Handvoll Operationen auf Zeichenketten.
Zeichenketten in Pseudocode
Eine Zeichenkette ist eine Folge von Zeichen. Algorithmisch kannst Du sie behandeln wie ein Array von Zeichen: Jedes Zeichen hat einen Index, der bei 0 beginnt, und die Länge ist die Anzahl der Zeichen. In Aufgabentexten ist dagegen oft von Stellen die Rede, die bei 1 beginnen („Stelle 1 bis 2: Kennung“). Stelle k hat also den Index k - 1 – diese Umrechnung ist die häufigste Fehlerquelle.
Für Pseudocode gibt es keine Norm. Dieser Artikel ergänzt die Schreibweise aus Algorithmen mit Pseudocode dokumentieren und Prozedurale Algorithmen mit Arrays um folgende Operationen:
| Operation | Schreibweise | Beispiel |
|---|---|---|
| Länge | laenge(text) |
laenge("CSB-Rad") ergibt 7 |
| Zeichen an Index i | text[i] |
"CSB-Rad"[4] ergibt 'R' |
| Teilzeichenkette | teilText(text, start, anzahl) |
teilText("CSB-Rad", 0, 3) ergibt "CSB" |
| Verketten | text1 & text2 |
"BC" & "27" ergibt "BC27" |
| Zahl in Text | zuText(zahl) |
zuText(42) ergibt "42" |
| Text in Zahl | zuZahl(text) |
zuZahl("042") ergibt 42 |
| Wert eines Zeichens | ziffernwert(zeichen) |
'7' ergibt 7; 'A' bzw. 'a' ergibt 10, …, 'Z' ergibt 35 |
| Zeichenart | istZiffer(zeichen), istBuchstabe(zeichen) |
istZiffer('7') ergibt wahr |
| Suche | position(text, zeichen) |
erster Index oder -1, wenn nicht enthalten |
| Zufall | zufallszahl(von, bis) |
ganze Zahl von von bis einschließlich bis |
| Menge | vergeben.enthaelt(code), vergeben.hinzufuegen(code) |
prüft bzw. ergänzt eine Menge ohne Duplikate (Java Set, Python set) |
Einzelne Zeichen stehen in einfachen Anführungszeichen ('A'), Zeichenketten in doppelten ("A"). Für fußgesteuerte Schleifen schreibt dieser Artikel wiederhole … solange bedingung: Der Rumpf läuft mindestens einmal und wird wiederholt, solange die Bedingung wahr ist.
Die Codebeispiele kannst Du in vier Notationen anzeigen; vorausgewählt ist das deutsche Pseudo-Pascal, in JANA und Pseudo-Python wird mit + verkettet. Die Notationen sind im Artikel Algorithmen mit Pseudocode dokumentieren beschrieben.
In Aufgaben heißen diese Funktionen oft anders (Länge von, toString, Zeichen an der Stelle i von, + statt & für die Verkettung). Übernimm immer die Namen der Aufgabenstellung. Gibt die Aufgabe eine Funktion vor, wird sie in der Lösung fast sicher gebraucht.
In vielen Programmiersprachen (Java, C#, Python) sind Zeichenketten unveränderlich (immutable): code := code & "7" erzeugt eine neue Zeichenkette. In Pseudocode spielt das keine Rolle; in echten Programmen nimmst Du zum Zusammensetzen in Schleifen einen StringBuilder (Java, C#) oder sammelst Teile in einer Liste und fügst sie am Ende mit join zusammen (Python).
Zeichen und Zahlen umwandeln
Zeichencodes
Der Rechner speichert jedes Zeichen als Zahl, den Zeichencode. Die Ziffern '0' bis '9' haben in ASCII und Unicode die aufeinanderfolgenden Codes 48 bis 57, die Großbuchstaben 'A' bis 'Z' die Codes 65 bis 90. Deshalb funktioniert in fast allen Sprachen der Trick
int ziffer = zeichen - '0';        // '7' (Code 55) - '0' (Code 48) = 7
int wert   = zeichen - 'A' + 10;   // 'A' -> 10, 'B' -> 11, ... 'Z' -> 35
In Pseudocode schreibst Du dafür einfach ziffernwert(zeichen). Wichtig ist der Unterschied: Das Zeichen '7' ist nicht die Zahl 7. Wer summe := summe + text[i] schreibt, addiert in Java den Zeichencode 55 – oder verkettet in anderen Sprachen Texte.
Für Fortgeschrittene: Die Länge einer Zeichenkette in Zeichen ist nicht immer ihre Länge in Bytes. In UTF-8 belegt 'Ö' zwei Bytes, ein Emoji vier. Ein Etikettendrucker, der 18 Bytes je Zeile verarbeitet, schneidet „Fatma Öztürk“ (12 Zeichen, 14 Bytes) deshalb früher ab als erwartet.
Zahl in Text: führende Nullen
zuText(5) ergibt "5", nicht "05". Verlangt eine Aufbauvorschrift eine feste Stellenzahl (Jahrgang zweistellig, Fachnummer zweistellig), musst Du auffüllen:
Funktion zweistellig(zahl: integer): string
    wenn zahl < 10 dann
        Rückgabe "0" & zuText(zahl)
    sonst
        Rückgabe zuText(zahl)
    Ende wenn
Ende zweistelligUmgekehrt verliert zuZahl("0571") die führende Null: Nummern, mit denen man nicht rechnet (Postleitzahlen, Artikelnummern, Telefonnummern), speicherst Du deshalb als Zeichenkette.
Gemischte Ausdrücke
Viele Sprachen erlauben "Text" + zahl; die Zahl wird dann in Text umgewandelt. In Java und C# wird der Ausdruck von links nach rechts ausgewertet:
| Ausdruck (Java) | Ergebnis | Warum |
|---|---|---|
"Slot " + 2 |
"Slot 2" |
Text + Zahl ergibt Text |
"Slot " + 2 + 1 |
"Slot 21" |
erst "Slot 2", dann + 1 als Text |
"Slot " + (2 + 1) |
"Slot 3" |
Klammer zuerst, dann Text |
2 + 1 + " Slots" |
"3 Slots" |
erst Zahl + Zahl, dann Text |
Python verweigert "Slot " + 2 mit einem TypeError; dort schreibst Du "Slot " + str(2) oder einen f-String.
Zeichenketten zerlegen und zusammensetzen
Codes folgen fast immer einer Aufbauvorschrift: Jede Stelle oder Gruppe von Stellen hat eine Bedeutung. Ein Beispiel ist die Sendungsnummer eines Paketetiketts nach GS1-Standard:
| Stelle | Inhalt | Beispiel |
|---|---|---|
| 1–2 | Datenbezeichner (application identifier) 00 = „es folgt eine SSCC“ |
00 |
| 3–19 | 17 Ziffern Nummer der Versandeinheit | 34012345000009876 |
| 20 | Prüfziffer | 2 |
Zerlegen heißt, aus den Stellen die Indizes zu berechnen: Die SSCC beginnt bei Stelle 3, also Index 2, und ist 18 Zeichen lang – teilText(scan, 2, 18). Die Prüfziffer ist das letzte Zeichen: scan[laenge(scan) - 1].
Zusammensetzen ist Verketten in der richtigen Reihenfolge, oft mit Trennzeichen. Liegen die Teile in einem Array, brauchst Du eine Schleife, die das Trennzeichen nur zwischen die Teile setzt:
Funktion verbinde(teile: string[], trenner: string): string
    ergebnis: string := teile[0]
    zähle i von 1 bis laenge(teile) - 1
        ergebnis := ergebnis & trenner & teile[i]
    Ende zähle
    Rückgabe ergebnis
Ende verbindeHäufig ist das Zusammensetzen der letzte Schritt einer Suche: Erst wird in einem zweidimensionalen Array die passende Zeile gesucht (zum Beispiel der Lagerplatz mit dem höchsten Bestand eines Artikels), dann wird aus ihren Spalten ein Code wie R07-E2-F05 gebaut. Denk dabei an den Fall, dass gar keine Zeile passt: Dann gibt die Funktion eine leere Zeichenkette oder einen vereinbarten Wert zurück, statt auf Index -1 zuzugreifen.
Prüfziffern: wozu?
Menschen vertippen sich. Die häufigsten Fehler beim Abtippen oder Vorlesen von Nummern sind:
Einzelfehler: eine Ziffer falsch (
4statt9),Nachbarvertauschung: zwei benachbarte Ziffern vertauscht (
58statt85),seltener Sprung- und Zwillingsfehler (
131statt133,112statt122).
Eine Prüfziffer ist eine zusätzliche Stelle, die aus den übrigen Stellen berechnet wird. Ändert sich eine Stelle, passt die Prüfziffer (meist) nicht mehr, und das Programm erkennt den Fehler sofort – ohne Datenbankabfrage. Fast alle Verfahren arbeiten gleich:
Jede Stelle wird mit einem Gewicht multipliziert, das von ihrer Position abhängt (sonst würden Vertauschungen nicht auffallen).
Die Produkte werden addiert (manchmal vorher ihre Quersumme gebildet).
Aus der Summe wird per Modulo (Rest der ganzzahligen Division) die Prüfziffer bestimmt.
Prüfen bedeutet dann: Prüfziffer aus den übrigen Stellen neu berechnen und mit der vorhandenen vergleichen. Die vorhandene Prüfziffer fließt dabei nicht in die Summe ein – die Schleife endet also eine Stelle früher.
Gewichtete Summe modulo 10 (GTIN/EAN, SSCC)
Die Barcodes im Handel (GTIN-13, früher EAN) und die Sendungsnummern (SSCC) verwenden das Verfahren von GS1:
Die Ziffern werden von rechts beginnend abwechselnd mit 3 und 1 gewichtet: Die Ziffer direkt links neben der Prüfziffer erhält das Gewicht 3.
Die Produkte werden addiert.
Die Prüfziffer ergänzt die Summe zum nächsten Vielfachen von 10:
pz = (10 - summe mod 10) mod 10. Das äußeremod 10sorgt dafür, dass bei einer Summe wie 60 die Prüfziffer 0 herauskommt und nicht 10.
Beispiel für die interne Artikelnummer 200004700103 (GTIN, die mit 2 beginnen, sind für den internen Gebrauch reserviert):
| Index | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Ziffer | 2 | 0 | 0 | 0 | 0 | 4 | 7 | 0 | 0 | 1 | 0 | 3 |
| Gewicht | 1 | 3 | 1 | 3 | 1 | 3 | 1 | 3 | 1 | 3 | 1 | 3 |
| Produkt | 2 | 0 | 0 | 0 | 0 | 12 | 7 | 0 | 0 | 3 | 0 | 9 |
Summe 33, 33 mod 10 = 3, Prüfziffer 10 - 3 = 7. Die vollständige Nummer lautet 2000047001037.
Weil die Gewichtung rechts beginnt, hängt das Gewicht einer Stelle von der Gesamtlänge ab. Eine Funktion, die für GTIN-13 (12 Nutzziffern) und SSCC (17 Nutzziffern) funktionieren soll, berechnet es deshalb aus dem Abstand zum rechten Ende:
Funktion pruefzifferGs1(ziffern: integer[]): integer
    n: integer := laenge(ziffern)
    summe: integer := 0
    zähle i von 0 bis n - 1
        wenn (n - 1 - i) mod 2 = 0 dann
            summe := summe + ziffern[i] * 3
        sonst
            summe := summe + ziffern[i]
        Ende wenn
    Ende zähle
    Rückgabe (10 - summe mod 10) mod 10
Ende pruefzifferGs1Aufgaben geben manchmal eine abgewandelte Vorschrift vor, zum Beispiel Gewichtung 1 und 3 von links und als Prüfziffer den Rest summe mod 10 statt der Ergänzung. Das ist genauso gut rechenbar – entscheidend ist, dass Du genau die Vorschrift der Aufgabe umsetzt und nicht das Verfahren, das Du kennst.
Luhn-Verfahren (Kreditkarten)
Kreditkartennummern (ISO/IEC 7812-1) und viele Kunden- oder Gerätenummern nutzen das Luhn-Verfahren (Modulo-10-Verfahren mit Quersumme):
Von rechts beginnend wird jede zweite Ziffer verdoppelt – beginnend mit der Ziffer links neben der Prüfziffer.
Ist ein Produkt zweistellig, wird seine Quersumme genommen (z. B. 14 → 1 + 4 = 5). Das ist dasselbe wie „minus 9“, weil ein Produkt höchstens 18 ist.
Alle Werte werden addiert.
Die Summe wird auf die nächstgrößere durch 10 teilbare Zahl aufgerundet; die Prüfziffer ist die Differenz. Ist die Summe schon durch 10 teilbar, ist die Prüfziffer 0.
Beispiel mit der neunstelligen Nummer 472915836:
| Ziffer | 4 | 7 | 2 | 9 | 1 | 5 | 8 | 3 | 6 |
|---|---|---|---|---|---|---|---|---|---|
| verdoppeln? | ja | – | ja | – | ja | – | ja | – | ja |
| Wert | 8 | 7 | 4 | 9 | 2 | 5 | 16 → 7 | 3 | 12 → 3 |
Summe 48, aufgerundet 50, Prüfziffer 2 – die vollständige Nummer lautet 4729158362. Als Pseudocode (Prüfen einer vollständigen Nummer):
Funktion pruefeLuhn(nummer: string): boolean
    n: integer := laenge(nummer)
    summe: integer := 0
    zähle i von 0 bis n - 2                    // ohne Prüfziffer
        z: integer := ziffernwert(nummer[i])
        wenn (n - 2 - i) mod 2 = 0 dann        // jede zweite von rechts
            z := z * 2
            wenn z > 9 dann
                z := z - 9                     // Quersumme
            Ende wenn
        Ende wenn
        summe := summe + z
    Ende zähle
    aufgerundet: integer := summe
    wenn summe mod 10 <> 0 dann
        aufgerundet := summe + 10 - summe mod 10
    Ende wenn
    Rückgabe aufgerundet - summe = ziffernwert(nummer[n - 1])
Ende pruefeLuhnDie Bedingung (n - 2 - i) mod 2 = 0 zählt von rechts. Steht in einer Lösung i mod 2 = 0 (von links), ist das nur richtig, solange die Anzahl der Nutzziffern ungerade ist.
Modulo 97 (IBAN, Leitweg-ID)
Bei IBAN und bei der Leitweg-ID für E-Rechnungen an öffentliche Auftraggeber (XRechnung) bestehen die Prüfziffern aus zwei Stellen. Das Verfahren heißt ISO 7064 MOD 97-10:
Trennzeichen (Leerzeichen, Bindestriche) werden entfernt, Buchstaben in Zahlen umgewandelt (
A= 10 …Z= 35). Bei der IBAN werden außerdem die ersten vier Zeichen ans Ende gestellt.Die ganze Zeichenkette wird als eine große Zahl gelesen.
Die Nummer ist gültig, wenn diese Zahl modulo 97 den Rest 1 ergibt.
Zum Berechnen setzt man die Prüfziffern zunächst auf
00und rechnetpz = 98 - (Zahl mod 97); das Ergebnis wird zweistellig geschrieben (06statt6).
Warum 98? Wenn Zahl00 mod 97 = r ist, ergibt Zahl00 + pz den Rest r + pz. Mit pz = 98 - r ist das 98, und 98 mod 97 = 1.
Die Zahl hat 20 Stellen und mehr und passt in keinen Ganzzahltyp (long reicht bis etwa 9,2 · 1018). Man berechnet den Rest deshalb schrittweise, wie bei der schriftlichen Division: Für jede Ziffer wird der bisherige Rest mit 10 multipliziert, die Ziffer addiert und sofort wieder mod 97 gerechnet. Ein Buchstabe steht für zwei Ziffern, deshalb wird dort mit 100 multipliziert.
Funktion restMod97(text: string): integer
    rest: integer := 0
    zähle i von 0 bis laenge(text) - 1
        c: char := text[i]
        wenn istZiffer(c) dann
            rest := (rest * 10 + ziffernwert(c)) mod 97
        sonst wenn istBuchstabe(c) dann
            rest := (rest * 100 + ziffernwert(c)) mod 97
        Ende wenn                              // Bindestriche werden übersprungen
    Ende zähle
    Rückgabe rest
Ende restMod97Für die Beispiel-Leitweg-ID 04011000-1234512345-06 ergibt restMod97 den Wert 1 – sie ist gültig.
Umgekehrt entstehen so die Prüfziffern: Mit 00 an ihrer Stelle liefert restMod97("04011000-1234512345-00") den Wert 92. Die Prüfziffern sind also 98 − 92 = 6, zweistellig geschrieben 06.
Welche Fehler werden erkannt?
| Verfahren | Einzelfehler | Nachbarvertauschung | Einsatz |
|---|---|---|---|
| ungewichtete Quersumme modulo 10 | alle | keine | – (ungeeignet) |
| GS1: Gewichte 3/1, modulo 10 | alle | alle außer bei Ziffern mit Abstand 5 (z. B. 16 ↔︎ 61) |
GTIN/EAN, SSCC, ISBN-13 |
| Luhn | alle | alle außer 09 ↔︎ 90 |
Kreditkarten, Kundennummern |
| ISO 7064 MOD 97-10 | alle | alle | IBAN, Leitweg-ID |
Prüfziffer ist kein Fälschungsschutz
Das Verfahren einer Prüfziffer ist öffentlich und schnell gerechnet. Wer eine gültige Nummer absichtlich erfinden will, berechnet einfach die passende Prüfziffer dazu. Prüfziffern schützen also vor Versehen, nicht vor Angriffen. Gegen Manipulation helfen ausreichend lange, kryptografisch zufällige Codes, eine Prüfung gegen die Datenbank und Authentifizierung – bei Nachrichten ein Message Authentication Code oder eine Signatur (siehe Artikel zur Kryptografie). Auch ein Hashwert ist etwas anderes: Er fasst beliebig lange Daten zusammen und soll Veränderungen erkennen, eine Prüfziffer ist Teil der Nummer und zielt auf Tippfehler.
Codes erzeugen: zufällig, eindeutig, prüfbar
Ticketcodes, Freischaltcodes oder Gutscheincodes werden aus Zufallszeichen erzeugt. Damit kein Code doppelt vergeben wird, merkt sich das Programm die vergebenen Codes, zum Beispiel in einer Menge (set; Java Set<String>, Python set). Eine Menge beantwortet schnell, ob ein Code schon enthalten ist (vergeben.enthaelt(code)), und nimmt neue Codes auf (vergeben.hinzufuegen(code)).
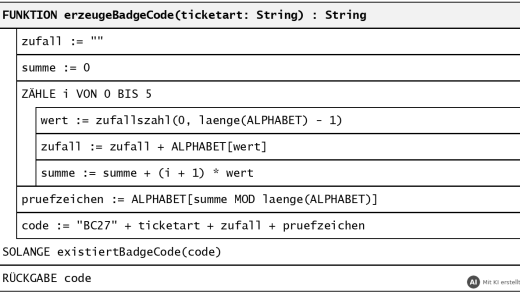
Ein Versuch besteht darin, Zeichen für Zeichen zufällig zu wählen, dabei die gewichtete Summe für das Prüfzeichen mitzurechnen und das Prüfzeichen anzuhängen. Ist der Code schon vergeben, folgt ein neuer Versuch. Dafür passt eine fußgesteuerte Schleife: Der Rumpf muss mindestens einmal laufen, bevor es überhaupt einen Code gibt, den man nachschlagen kann. Alle Variablen, die je Versuch neu beginnen (Code, Summe), werden innerhalb der Schleife zurückgesetzt – sonst wächst der Code beim zweiten Versuch auf die doppelte Länge.
Zwei Dinge machen den Algorithmus robust: Eine zweite Schleifenbedingung begrenzt die Zahl der Versuche, damit die Funktion bei fast vollem Nummernraum nicht endlos läuft; findet sie keinen freien Code, gibt sie eine leere Zeichenkette zurück, und das aufrufende Programm meldet den Fehler. Und ein gefundener Code wird sofort in die Menge aufgenommen, damit der nächste Aufruf ihn nicht noch einmal liefert.

Für Codes, die Menschen lesen oder abtippen, lohnt sich ein eigenes Alphabet ohne leicht verwechselbare Zeichen (0/O, 1/I/L, 5/S, 8/B). Ein Zufallszeichen erzeugst Du dann über seinen Index: alphabet[zufallszahl(0, laenge(alphabet) - 1)]. Der Index ist zugleich der Zahlenwert des Zeichens für die Prüfsumme; umgekehrt liefert position(alphabet, zeichen) beim Prüfen den Wert zurück. Ist die Länge des Alphabets eine Primzahl (z. B. 23) und sind die Gewichte größer als 0, kleiner als diese und für benachbarte Stellen verschieden, erkennt ein gewichtetes Prüfzeichen alphabet[summe mod laenge(alphabet)] jeden Einzelfehler und jede Nachbarvertauschung.
Zwei Hinweise für die Praxis: Die übliche Funktion zufallszahl ist nicht kryptografisch sicher; für Codes, die Zugang gewähren, nimmst Du einen sicheren Zufallsgenerator (Java SecureRandom, Python secrets). Und je voller der Nummernraum ist, desto öfter läuft die Wiederholungsschleife – plane genug Stellen ein.
Lauflängenkodierung
Die Lauflängenkodierung (run-length encoding, RLE) ist ein einfaches verlustfreies Kompressionsverfahren: Statt RRRRRRRRR speichert man „9-mal R“. Sie lohnt sich bei Daten mit langen Wiederholungen, etwa Schwarz-Weiß-Bildern, Faxen oder Pixelgrafiken mit wenigen Farben.
In der einfachsten Form wird jeder Lauf gleicher Zeichen als Paar aus Anzahl und Zeichen geschrieben. Eine Bildzeile eines Pixel-Icons mit den Farben R, G und B wird so
RRRRRRRRRGGGGBRRRRRR (20 Zeichen) zu 9R4G1B6R (8 Zeichen).
Ein einzelnes Zeichen wird in dieser Form doppelt so lang (1B statt B). Bei Daten mit vielen kurzen Läufen wird die Kodierung deshalb länger als das Original.
Komprimieren
Der Algorithmus läuft mit einem Index durch die Zeichenkette. An jeder Position zählt eine innere Schleife, wie oft dasselbe Zeichen direkt folgt; danach wird das Paar angehängt und der Index springt hinter den Lauf.
Funktion komprimiere(daten: string): string
    ergebnis: string := ""
    i: integer := 0
    solange i < laenge(daten)
        zeichen: char := daten[i]
        anzahl: integer := 1
        solange i + anzahl < laenge(daten) und daten[i + anzahl] = zeichen
            anzahl := anzahl + 1
        Ende solange
        ergebnis := ergebnis & zuText(anzahl) & zeichen
        i := i + anzahl
    Ende solange
    Rückgabe ergebnis
Ende komprimiereAchte auf die Reihenfolge in i + anzahl < laenge(daten) und daten[i + anzahl] = zeichen: Erst die Indexprüfung, dann der Zugriff (Kurzschlussauswertung). Andersherum liest der Algorithmus am Ende hinter die Zeichenkette. Wer statt der inneren Schleife eine einzige Zählschleife verwendet, muss den Lauf bei jedem Zeichenwechsel ausgeben – und den letzten Lauf nach der Schleife, sonst fehlt er.
Dekomprimieren
Beim Dekomprimieren liest das Programm abwechselnd eine Anzahl und ein Zeichen. Eine mehrstellige Anzahl setzt es wie beim schrittweisen Rest oben zusammen: anzahl := anzahl * 10 + ziffernwert(daten[i]), solange Ziffern folgen. Das nächste Zeichen wird anzahl-mal angehängt, danach beginnt anzahl wieder bei 0.
Wenn die Kodierung mehrdeutig wird
Die Kodierung funktioniert nur, wenn sich beim Dekomprimieren eindeutig sagen lässt, wo die Anzahl endet. Enthalten die Daten selbst Ziffern, ist das nicht mehr der Fall: Aus der Raumnummer 2000 wird 1230 („einmal 2, dreimal 0“). Beim Dekomprimieren liest das Programm aber alle Ziffern als Anzahl, also 123, und findet danach kein Zeichen mehr. Abhilfen:
Die Anzahl wird als ein Byte (Binärwert 0 bis 255) gespeichert statt als Ziffernfolge. Jedes Paar ist dann genau zwei Bytes lang; längere Läufe werden auf mehrere Paare verteilt.
Ein Trennzeichen, das in den Daten nicht vorkommt, steht zwischen den Paaren; kommt es doch vor, wird es maskiert (zum Beispiel verdoppelt).
Gibt es nur zwei Zeichen, etwa bei Schwarz-Weiß-Grafiken, muss das Zeichen gar nicht gespeichert werden: Die Läufe wechseln sich ab, übertragen werden nur die Lauflängen. So arbeitet im Prinzip auch das Fax.
Typische Fehler
Index und Stelle verwechselt: Stelle 3 ist Index 2; die letzte Stelle hat den Index
laenge(text) - 1.Zeichen statt Zahl gerechnet:
summe + text[i]addiert den Zeichencode oder verkettet; immer erstziffernwert.Prüfziffer mitgerechnet: Beim Prüfen läuft die Schleife nur bis
laenge - 2.Gewichte falsch zugeordnet: Gewichtung von links statt von rechts (oder umgekehrt), Gewicht über
mod 2von der falschen Seite berechnet.Sonderfall Rest 0 vergessen:
10 - summe mod 10ergibt 10 statt 0.Quersumme falsch: zweistelliges Produkt minus 10 statt minus 9.
Führende Nullen verloren:
zuText(5)statt"05"; Nummern als Zahl gespeichert.Gemischte Ausdrücke:
"Slot " + slot + 1ergibt"Slot 21".Zurücksetzen vergessen: In der Wiederholungsschleife Code und Summe nicht neu begonnen; neuen Code nicht in die Menge der vergebenen Codes aufgenommen.
Über das Ende gelesen: Nachfolger verglichen, ohne vorher
i + 1 < laengezu prüfen; letzter Lauf nicht ausgegeben.
Schritt für Schritt zur Lösung
Aufbauvorschrift markieren: Welche Stellen bedeuten was? Rechne Stellen in Indizes um und notiere sie am Rand.
Beispiel der Aufgabe von Hand nachrechnen: Wer das Beispiel selbst in einer Tabelle (Ziffer, Gewicht, Produkt) rechnet, versteht die Vorschrift – und hat gleich einen Testfall.
Signatur übernehmen: Wird ein Array von Ziffern oder eine Zeichenkette übergeben? Gibt die Funktion die Prüfziffer, einen Wahrheitswert oder einen Code zurück?
Grundmuster wählen: Durchlaufen und summieren (Prüfziffer), zusammensetzen in einer Zählschleife (Code), Lauf zählen (Kompression), wiederholen bis eindeutig (Code erzeugen).
Umwandlungen einbauen: Zeichen → Zahl beim Rechnen, Zahl → Text beim Zusammensetzen, führende Nullen.
Sonderfälle prüfen: Rest 0, letztes Zeichen, leere Eingabe, Eingabe mit falscher Länge oder fremden Zeichen.
Schreibtischtest mit dem Beispiel aus der Aufgabe.
Leitfragen
- Wie rechnest Du die Stellen einer Aufbauvorschrift in Indizes um, und wie greifst Du auf das letzte Zeichen zu?
Aufgabentexte zählen Stellen ab 1, Indizes beginnen bei 0: Stelle k hat also den Index k - 1. Das letzte Zeichen erreichst Du mit text[laenge(text) - 1], eine Teilzeichenkette mit teilText(text, start, anzahl); siehe Abschnitt „Zeichenketten in Pseudocode“ und Abschnitt „Zeichenketten zerlegen und zusammensetzen“.
- Wie wandelst Du ein Ziffernzeichen in eine Zahl um, und was ergibt
"Slot " + 2 + 1?
Ein Ziffernzeichen ist nicht die Zahl: Du wandelst es mit ziffernwert(zeichen) um, in Java etwa mit zeichen - '0' (Code 55 minus Code 48 ergibt 7). "Slot " + 2 + 1 wird von links nach rechts ausgewertet und ergibt "Slot 21"; für "Slot 3" brauchst Du Klammern um (2 + 1); siehe Abschnitt „Zeichencodes“ und Abschnitt „Gemischte Ausdrücke“.
- Wie stellst Du sicher, dass eine Zahl in einem Code zweistellig erscheint?
zuText(5) ergibt nur "5", deshalb füllst Du bei Zahlen kleiner als 10 mit einer führenden "0" auf, zum Beispiel in einer Funktion zweistellig. Nummern, mit denen nicht gerechnet wird, speicherst Du ohnehin als Zeichenkette, damit führende Nullen nicht verloren gehen; siehe Abschnitt „Zahl in Text: führende Nullen“.
- Wie berechnest Du eine GS1-Prüfziffer, und warum hängt das Gewicht einer Stelle von der Länge der Nummer ab?
Die Ziffern werden von rechts beginnend abwechselnd mit 3 und 1 gewichtet (die Ziffer links neben der Prüfziffer erhält 3), die Produkte addiert und die Prüfziffer als (10 - summe mod 10) mod 10 berechnet. Weil die Gewichtung rechts beginnt, hängt das Gewicht einer Stelle von der Gesamtlänge ab; eine allgemeine Funktion berechnet es deshalb aus dem Abstand zum rechten Ende ((n - 1 - i) mod 2); siehe Abschnitt „Gewichtete Summe modulo 10 (GTIN/EAN, SSCC)“.
- Worin unterscheiden sich die Prüfziffer als Rest (
summe mod 10) und als Ergänzung ((10 - summe mod 10) mod 10)?
Als Rest ist die Prüfziffer einfach summe mod 10. Als Ergänzung füllt sie die Summe zum nächsten Vielfachen von 10 auf; das äußere mod 10 sorgt dafür, dass bei einer durch 10 teilbaren Summe 0 statt 10 herauskommt. Entscheidend ist, genau die Vorschrift der Aufgabe umzusetzen; siehe Abschnitt „Gewichtete Summe modulo 10 (GTIN/EAN, SSCC)“.
- Wie funktioniert das Luhn-Verfahren, und warum ist „minus 9“ dasselbe wie die Quersumme?
Von rechts beginnend wird jede zweite Ziffer (beginnend links neben der Prüfziffer) verdoppelt, bei zweistelligen Produkten die Quersumme gebildet, alles addiert und die Prüfziffer als Differenz zur nächsten durch 10 teilbaren Zahl bestimmt. Ein verdoppeltes Produkt ist höchstens 18, die Quersumme einer Zahl von 10 bis 18 ist 1 + (z - 10), also genau z - 9; siehe Abschnitt „Luhn-Verfahren (Kreditkarten)“.
- Warum ist eine Nummer nach MOD 97-10 gültig, wenn der Rest 1 ist, und wie berechnest Du den Rest einer Zahl mit 20 Stellen?
Beim Berechnen setzt man die Prüfziffern auf 00 und nimmt pz = 98 - r mit r = Zahl mod 97; die vollständige Zahl hat dann den Rest r + pz = 98, und 98 mod 97 = 1. Eine Zahl mit 20 und mehr Stellen passt in keinen Ganzzahltyp, deshalb rechnest Du den Rest schrittweise: rest := (rest * 10 + ziffer) mod 97, bei Buchstaben mit 100 statt 10; siehe Abschnitt „Modulo 97 (IBAN, Leitweg-ID)“.
- Warum erzeugt man eindeutige Codes mit einer fußgesteuerten Schleife, und welche Variablen müssen in jedem Durchlauf neu beginnen?
Ob ein Code schon vergeben ist, lässt sich erst prüfen, wenn er erzeugt wurde – der Rumpf muss also mindestens einmal laufen, und genau das leistet die fußgesteuerte Schleife. Code und Prüfsumme müssen innerhalb der Schleife bei jedem Versuch neu beginnen, sonst wächst der Code beim zweiten Versuch auf die doppelte Länge. Eine Versuchsgrenze verhindert eine Endlosschleife bei fast vollem Nummernraum, und ein gefundener Code wird sofort als vergeben eingetragen; siehe Abschnitt „Codes erzeugen: zufällig, eindeutig, prüfbar“.
- Wie funktioniert die Lauflängenkodierung, wann wird sie mehrdeutig, und wie lässt sich das beheben?
Jeder Lauf gleicher Zeichen wird als Paar aus Anzahl und Zeichen geschrieben (z. B. 9R statt RRRRRRRRR); bei vielen kurzen Läufen wird das Ergebnis länger als das Original. Mehrdeutig wird die Kodierung, wenn die Daten selbst Ziffern enthalten, weil dann unklar ist, wo die Anzahl endet. Abhilfe schaffen die Anzahl als Byte, ein (maskiertes) Trennzeichen oder – bei nur zwei Zeichen – das Speichern der reinen Lauflängen; siehe Abschnitt „Komprimieren“ und Abschnitt „Wenn die Kodierung mehrdeutig wird“.
- Warum schützt eine Prüfziffer nicht vor absichtlich gefälschten Nummern?
Das Verfahren ist öffentlich und schnell gerechnet: Wer absichtlich eine gültige Nummer erfinden will, berechnet einfach die passende Prüfziffer dazu. Prüfziffern schützen vor Tippfehlern, nicht vor Angriffen; dagegen helfen lange, kryptografisch zufällige Codes, ein Abgleich mit der Datenbank, Authentifizierung oder Signaturen; siehe Abschnitt „Prüfziffer ist kein Fälschungsschutz“.
Links und weitere Informationen
Prozedurale Algorithmen mit Arrays: suchen, zählen, Extremwerte und Gruppenwechsel
Übersicht der Programmentwurfsmethoden (Pseudocode, Struktogramm, PAP, Aktivitätsdiagramm)
Kryptografie: symmetrisch, asymmetrisch, hybrid – mit Hash, Signatur und Zertifikat
als Nachschlagewerk: GS1 General Specifications, Abschnitt Prüfziffernberechnung und GS1-Prüfziffernrechner
als Nachschlagewerk: ISO/IEC 7812-1 (Luhn-Verfahren für Kartennummern), ISO 7064 (MOD 97-10) und ISO 13616 (IBAN)
zur Vertiefung: Format-Spezifikation Leitweg-ID 2.0.2 (Aufbau und Prüfziffer, KoSIT)
Hinweis zur Nachnutzung als Open Educational Resource (OER)
Dieser Artikel und seine Texte, Bilder, Grafiken, Code und sonstiger Inhalt sind - sofern nicht anders angegeben - lizenziert unter CC BY 4.0. Nennung gemäß TULLU-Regel bitte wie folgt: “Zeichenketten und Prüfziffern: Algorithmen für Codes, Nummern und Texte” von oer-informatik.de (H. Stein), Lizenz: CC BY 4.0. Der Artikel wurde unter https://oer-informatik.de/zeichenketten-pruefziffern veröffentlicht, die Quelltexte sind in weiterverarbeitbarer Form verfügbar im Repository unter https://gitlab.com/oer-informatik/algorithmik/algorithmen. Erstellt mit KI-Assistenz; von mir umfassend redaktionell überarbeitet, geprüft und freigegeben. Stand: 28.10.2026.
[Kommentare zum Artikel lesen, schreiben] / [Artikel teilen] / [gitlab-Issue zum Artikel schreiben]