SQL: Abfragen über mehrere Tabellen mit JOIN
https://bildung.social/@oerinformatik/112633708392604185
https://oer-informatik.de/sql-join
SQL, JOIN, INNER JOIN, LEFT JOIN, Kreuzprodukt, Anti-Join, Self Join, Fremdschlüssel, MariaDB, Aggregation
tl/dr; (ca. 26 min Lesezeit): In relationalen Datenbanken sind zusammengehörige Daten auf mehrere Tabellen verteilt. Mit JOIN fügst Du sie in einer Abfrage wieder zusammen: Der innere Verbund liefert nur Zeilen mit Partner, die äußeren Verbünde (LEFT, RIGHT, FULL) auch Zeilen ohne Partner. Der Artikel zeigt Kreuzprodukt, Join-Bedingungen über mehrere Tabellen und Spalten, Selbstverknüpfung, Anti-Join, die Falle „Bedingung in WHERE statt ON“, Vervielfachung beim Zählen sowie UPDATE und DELETE mit JOIN in MariaDB [AI-Assisted]. (Zuletzt geändert am 26.10.2026)
Dieser Artikel ist Teil einer Artikelreihe über SQL-Abfragen: Selektion und Projektion / Sortieren und Begrenzen (ORDER BY, LIMIT) / Funktionen im SELECT (Single-Row-Functions) / Fallunterscheidungen und NULL (CASE, COALESCE) / Aggregatfunktionen und Gruppierung / Abfragen über mehrere Tabellen (JOIN) / Übungsaufgaben: einfache Abfragen, Aggregatfunktionen, JOIN, Rechnungsdatenbank (gemischt)
Schon fit in diesem Thema? Nutze die Kann-Liste und die Leitfragen unter dem Artikel als Checkliste, ob Du die relevanten Kompetenzen bereits hast.
Dieser Artikel baut auf der Kann-Liste der Artikel Selektion und Projektion und Der logische Datenbankentwurf mit dem Relationenmodell auf.
Als SQL-Grundlagen kann ich nach Durchlesen des Artikels…
… erklären, warum Daten auf mehrere Tabellen verteilt sind und wie Primär- und Fremdschlüssel sie verbinden.
… das Kreuzprodukt zweier Tabellen erläutern und die Zahl seiner Zeilen berechnen.
… Abfragen mit
INNER JOIN … ONüber zwei und mehr Tabellen (auch über Zwischentabellen) notieren und die implizite Schreibweise mit Komma undWHERElesen.… Tabellen- und Spaltenaliase verwenden und mehrdeutige Spaltennamen qualifizieren.
…
LEFT JOINundRIGHT JOINunterscheiden und anhand einer vorgegebenen Ergebnistabelle die passende Join-Art wählen.… Verbünde mit
WHERE,GROUP BY,HAVINGundORDER BYkombinieren.… erkennen, dass eine Bedingung an die rechte Tabelle eines
LEFT JOINin dieON-Klausel gehört, und beim ZählenCOUNT(spalte)stattCOUNT(*)anwenden.… das Konzept eines Verbunds erklären und mit
DISTINCToderEXISTSermitteln, welche Datensätze überhaupt einen Partner haben.
Darüber hinaus kann ich als SQL-Expertenwissen…
… einen vollständigen äußeren Verbund in MariaDB mit
UNIONnachbilden.… Selbstverknüpfungen, Tabellen in mehreren Rollen, zusammengesetzte Schlüssel und Bedingungen mit Bereichen im Verbund anwenden.
… Datensätze ohne Partner mit einem Anti-Join finden und die Vervielfachung von Zeilen beim Zählen erkennen und beheben.
… Equi- und Non-Equi-Joins unterscheiden und Zeilen ohne Partner auf beiden Seiten mit zwei Anti-Joins und
UNIONfinden.… Datensätze mit
UPDATEundDELETEüber einen Verbund ändern bzw. löschen.… Zeitspannen über einen Verbund berechnen und je Gruppe mitteln.
… Verbünde in der Datenanalyse mit pandas (
merge) umsetzen und DataFrames mit mehreren Bedingungen filtern.
Ein Onlineshop speichert Kund*innen, Bestellungen, Bestellpositionen und Artikel in getrennten Tabellen. Das ist kein Zufall, sondern das Ergebnis der Normalisierung: Jede Information steht nur einmal in der Datenbank. Für fast jede sinnvolle Auswertung („Wer hat was bestellt?“) müssen die Teile aber wieder zusammengesetzt werden. Genau das leistet der Verbund (join). Kaum eine SQL-Aufgabe kommt ohne ihn aus.
Das Konzept in Kürze: Ein Verbund fügt die Datensätze von mindestens zwei Tabellen zu den Zeilen einer Ergebnistabelle zusammen. Welche Datensätze zusammengehören, legt die Verbundbedingung fest – meist der Vergleich eines Fremdschlüssels mit dem Primärschlüssel, auf den er verweist (ON b.kunde_id = k.kunde_id). Die Join-Art bestimmt, was mit Datensätzen ohne Partner geschieht: Der innere Verbund lässt sie weg, die äußeren Verbünde behalten sie und füllen die fehlenden Spalten mit NULL.
Das Beispiel: Abteilungen, Mitarbeitende und Schulungen
Alle Beispiele in diesem Artikel beziehen sich auf eine kleine Personaldatenbank eines Fahrradhändlers:
abteilung (abteilung_id, bezeichnung)
mitarbeiter (mitarbeiter_id, vorname, nachname, #abteilung_id, #vorgesetzt_id)
schulung (schulung_id, titel)
teilnahme (#mitarbeiter_id, #schulung_id)
| abteilung_id | bezeichnung |
|---|---|
| 1 | Vertrieb |
| 2 | Werkstatt |
| 3 | Buchhaltung |
| 4 | IT |
| mitarbeiter_id | vorname | nachname | abteilung_id | vorgesetzt_id |
|---|---|---|---|---|
| 1 | Sophie | Bertram | 1 | NULL |
| 2 | Bastian | Ludwig | 2 | NULL |
| 3 | Selin | Arslan | 2 | 2 |
| 4 | Paul | Neubauer | 2 | 2 |
| 5 | Natalia | Wróbel | 3 | 1 |
| 6 | Alex | Kaiser | NULL | 2 |
Der Fremdschlüssel abteilung_id in mitarbeiter verweist auf den Primärschlüssel von abteilung. Alex Kaiser ist neu und noch keiner Abteilung zugeordnet (NULL), die Abteilung IT hat noch niemanden.
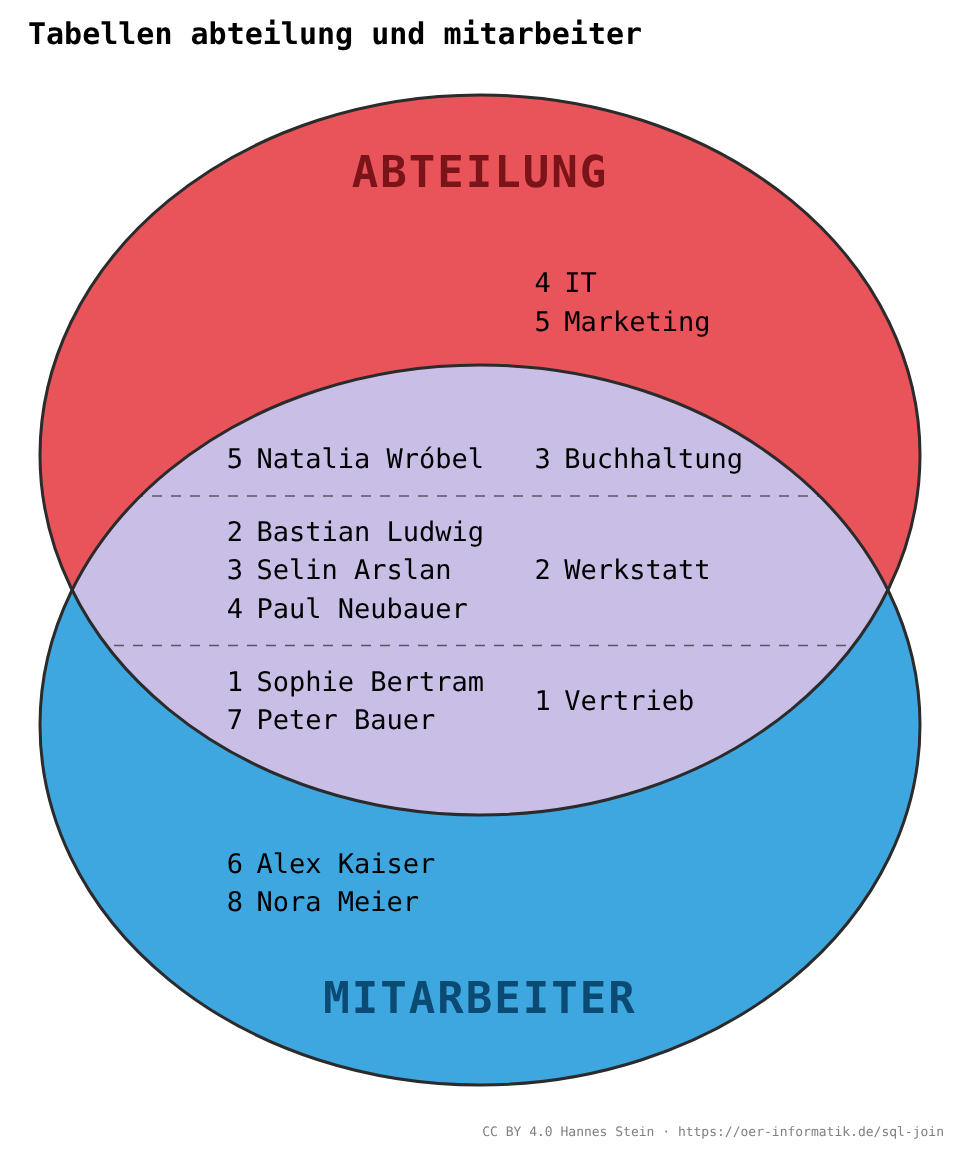
vorgesetzt_id verweist auf eine andere Zeile derselben Tabelle. Die Tabelle teilnahme löst die n:m-Beziehung zwischen Mitarbeitenden und Schulungen auf: Selin (3) und Paul (4) waren bei der E-Bike-Diagnose (1), Selin, Natalia (5) und Sophie (1) bei Erster Hilfe (2), Natalia außerdem bei der Schulung E-Rechnung (3).
Das Kreuzprodukt: jede Zeile mit jeder
Nennst Du zwei Tabellen in der FROM-Klausel, ohne zu sagen, wie sie zusammengehören, kombiniert die Datenbank jede Zeile der einen mit jeder Zeile der anderen Tabelle. Dieses kartesische Produkt oder Kreuzprodukt (cross join) hat so viele Zeilen wie das Produkt der Zeilenzahlen:
SELECT COUNT(*) AS zeilen
FROM mitarbeiter CROSS JOIN abteilung;   -- gleichwertig: FROM mitarbeiter, abteilung
Die Abfrage liefert 6 \cdot 4 = 24 Zeilen. Nur fünf davon sind sinnvoll, nämlich die, in denen mitarbeiter.abteilung_id und abteilung.abteilung_id übereinstimmen. Ein Verbund ist also gedanklich ein Kreuzprodukt, aus dem die Zeilen mit passendem Schlüssel ausgewählt werden. Ein vergessenes Verknüpfungskriterium erkennst Du in der Praxis an plötzlich riesigen Ergebnissen mit Wiederholungen.
Bewusst eingesetzt wird das Kreuzprodukt selten, zum Beispiel um alle Kombinationen zu erzeugen (jede Schulung für jede Abteilung als leere Planungsliste).
Der innere Verbund: INNER JOIN
Der innere Verbund (inner join) liefert nur die Zeilen, für die in beiden Tabellen ein passender Partner existiert.
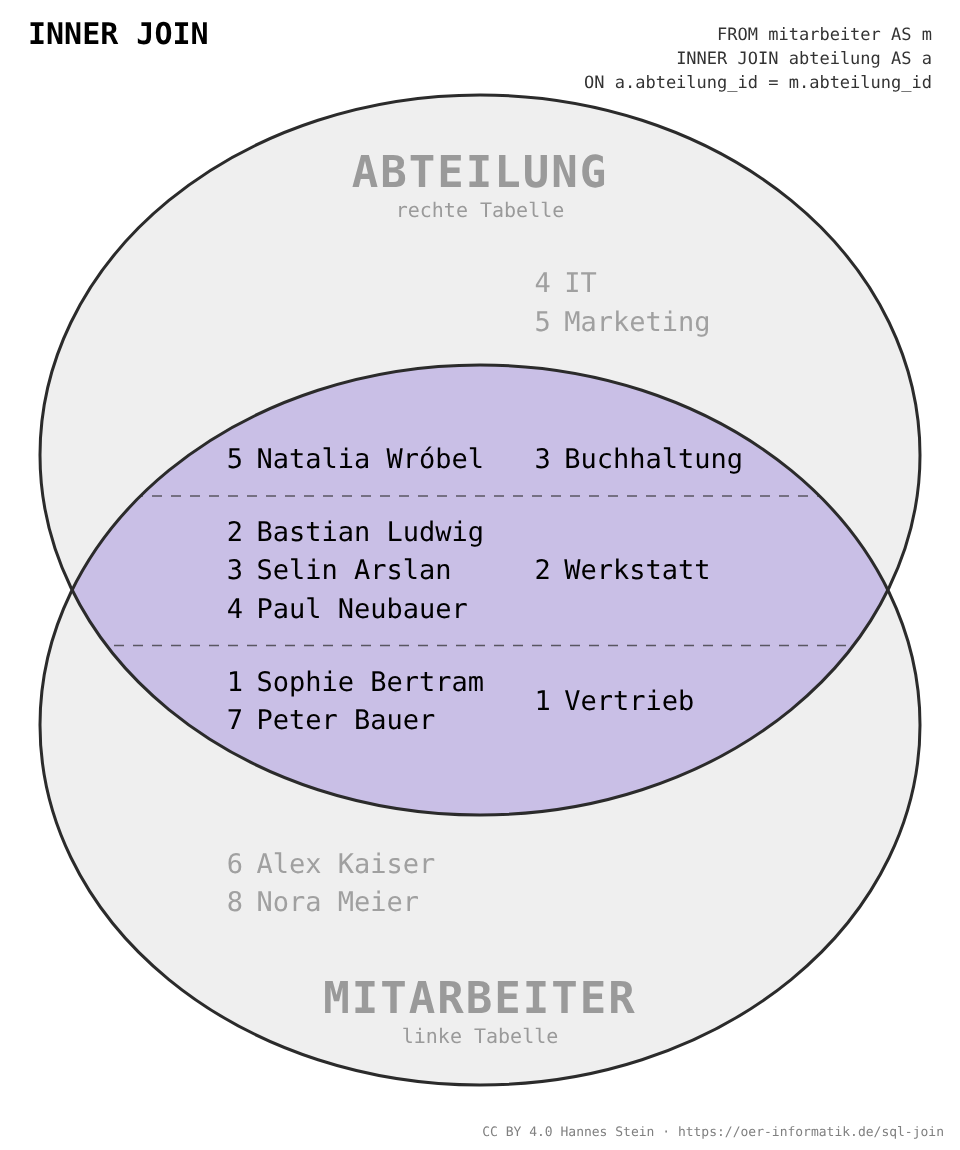
Die Verknüpfungsbedingung (Join-Bedingung) steht hinter ON; meist vergleicht sie Fremdschlüssel und Primärschlüssel:
SELECT m.vorname, m.nachname, a.bezeichnung AS abteilung
FROM mitarbeiter AS m
INNER JOIN abteilung AS a ON a.abteilung_id = m.abteilung_id;| vorname | nachname | abteilung |
|---|---|---|
| Sophie | Bertram | Vertrieb |
| Bastian | Ludwig | Werkstatt |
| Selin | Arslan | Werkstatt |
| Paul | Neubauer | Werkstatt |
| Natalia | Wróbel | Buchhaltung |
Alex Kaiser fehlt (kein Partner, weil NULL mit nichts übereinstimmt), die Abteilung IT ebenfalls (niemand verweist auf sie). Das Schlüsselwort INNER ist optional, JOIN allein bedeutet dasselbe. Die Werkstatt erscheint dreimal, weil drei Mitarbeitende auf sie verweisen: Ist die Verknüpfungsspalte auf einer Seite nicht eindeutig, wiederholt der Verbund die Werte der anderen Seite für jeden Partner.
Aliase und eindeutige Spaltennamen
m und a sind Tabellenaliase (das AS davor darf fehlen, in Oracle muss es sogar fehlen). Sie sparen Schreibarbeit und sind nötig, sobald ein Spaltenname in mehreren Tabellen vorkommt: abteilung_id gibt es in beiden Tabellen. Schreibst Du die Spalte ohne Tabellenangabe, bricht MariaDB mit Column 'abteilung_id' in field list is ambiguous ab. Gewöhn Dir an, im Verbund alle Spalten zu qualifizieren (m.nachname), auch wenn sie eindeutig sind.
Spaltenaliase (a.bezeichnung AS abteilung) geben Ergebnisspalten einen sprechenden Namen. Das ist wichtig, wenn mehrere Tabellen gleichnamige Spalten haben (etwa bezeichnung in Artikel und Kategorie) oder eine Aufgabe die Spaltenüberschriften vorgibt.
Die implizite Schreibweise
Ältere Lehrbücher, manche Lösungsvorlagen und viele Bestandsanwendungen nutzen die implizite Schreibweise: Die Tabellen stehen mit Komma in FROM, die Join-Bedingung in WHERE:
SELECT m.vorname, m.nachname, a.bezeichnung AS abteilung
FROM mitarbeiter AS m, abteilung AS a
WHERE a.abteilung_id = m.abteilung_id;
Das Ergebnis ist dasselbe. Die explizite Schreibweise mit JOIN … ON hat aber Vorteile: Verknüpfung und Filter sind getrennt, eine vergessene Join-Bedingung fällt sofort auf, und nur sie erlaubt äußere Verbünde. Du solltest beide lesen können und JOIN … ON schreiben.
Ein Verbund, dessen Bedingung nur auf Gleichheit prüft (=), heißt Equi-Join; in der impliziten Schreibweise sieht man gut, dass er ein gefiltertes Kreuzprodukt ist. Vergleicht die Bedingung mit anderen Operatoren (<, BETWEEN …), spricht man von einem Non-Equi-Join (auch Theta-Join); ein Beispiel folgt im Abschnitt über zusammengesetzte Schlüssel und weitere Bedingungen.
Daneben gibt es Kurzformen: USING (abteilung_id) vergleicht gleichnamige Spalten, NATURAL JOIN sogar alle gleichnamigen Spalten automatisch. NATURAL JOIN ist tückisch: Kommt später eine Spalte wie bezeichnung in beiden Tabellen hinzu, ändert sich das Ergebnis still. Verwende besser ON.
Mehr als zwei Tabellen verknüpfen
Für jede weitere Tabelle folgt ein weiteres JOIN … ON. Bei n Tabellen brauchst Du (in der Regel) n - 1 Join-Bedingungen. Den Weg findest Du im Datenmodell, indem Du den Fremdschlüsselbeziehungen folgst. Eine n:m-Beziehung führt dabei immer über die Zwischentabelle:
SELECT m.vorname, m.nachname, s.titel
FROM mitarbeiter AS m
  INNER JOIN teilnahme AS t ON t.mitarbeiter_id = m.mitarbeiter_id
  INNER JOIN schulung AS s ON s.schulung_id = t.schulung_id
ORDER BY m.nachname, s.titel;| vorname | nachname | titel |
|---|---|---|
| Selin | Arslan | E-Bike-Diagnose |
| Selin | Arslan | Erste Hilfe |
| Sophie | Bertram | Erste Hilfe |
| Paul | Neubauer | E-Bike-Diagnose |
| Natalia | Wróbel | E-Rechnung |
| Natalia | Wróbel | Erste Hilfe |
Die Reihenfolge der JOIN beeinflusst bei inneren Verbünden das Ergebnis nicht. Wichtig ist nur, dass jede Join-Bedingung auf Tabellen verweist, die vorher schon genannt wurden.
Zusammengesetzte Schlüssel und weitere Bedingungen
Besteht ein Schlüssel aus mehreren Spalten, müssen alle Spalten verglichen werden. Verweist zum Beispiel ein Fertigungsauftrag mit (bestellung_id, pos_nr) auf eine Bestellposition, lautet die Bedingung:
... INNER JOIN bestellposition AS bp ON bp.bestellung_id = fa.bestellung_id
                                    AND bp.pos_nr = fa.pos_nr
Vergleichst Du nur bestellung_id, passt der Auftrag zu allen Positionen der Bestellung, und die Zeilen vervielfachen sich.
Die Join-Bedingung muss außerdem kein reiner Schlüsselvergleich sein. Bei einer Mitfahr-App passt ein Angebot zu einem Gesuch, wenn Haltepunkt, Richtung und Datum übereinstimmen und die Abfahrt im gewünschten Zeitfenster liegt: ON an.haltepunkt_id = g.haltepunkt_id AND an.datum = g.datum AND an.abfahrt BETWEEN g.zeit_von AND g.zeit_bis. Auch Plan- und Ist-Zeiten (etwa für Verspätungen) werden so über mehrere Spalten verknüpft und dann mit Datumsfunktionen wie TIMESTAMPDIFF(MINUTE, plan, ist) verrechnet.
Äußere Verbünde: auch Zeilen ohne Partner
Oft sollen auch Zeilen erscheinen, die keinen Partner haben: alle Mitarbeitenden, auch die ohne Abteilung; alle Räume, auch die nicht belegten; alle Kund*innen, auch die ohne Bestellung. Dafür gibt es die äußeren Verbünde (outer joins). Fehlende Partner werden mit NULL aufgefüllt.
LEFT JOIN
Beim LEFT [OUTER] JOIN bleiben alle Zeilen der linken Tabelle (die vor JOIN steht) erhalten:
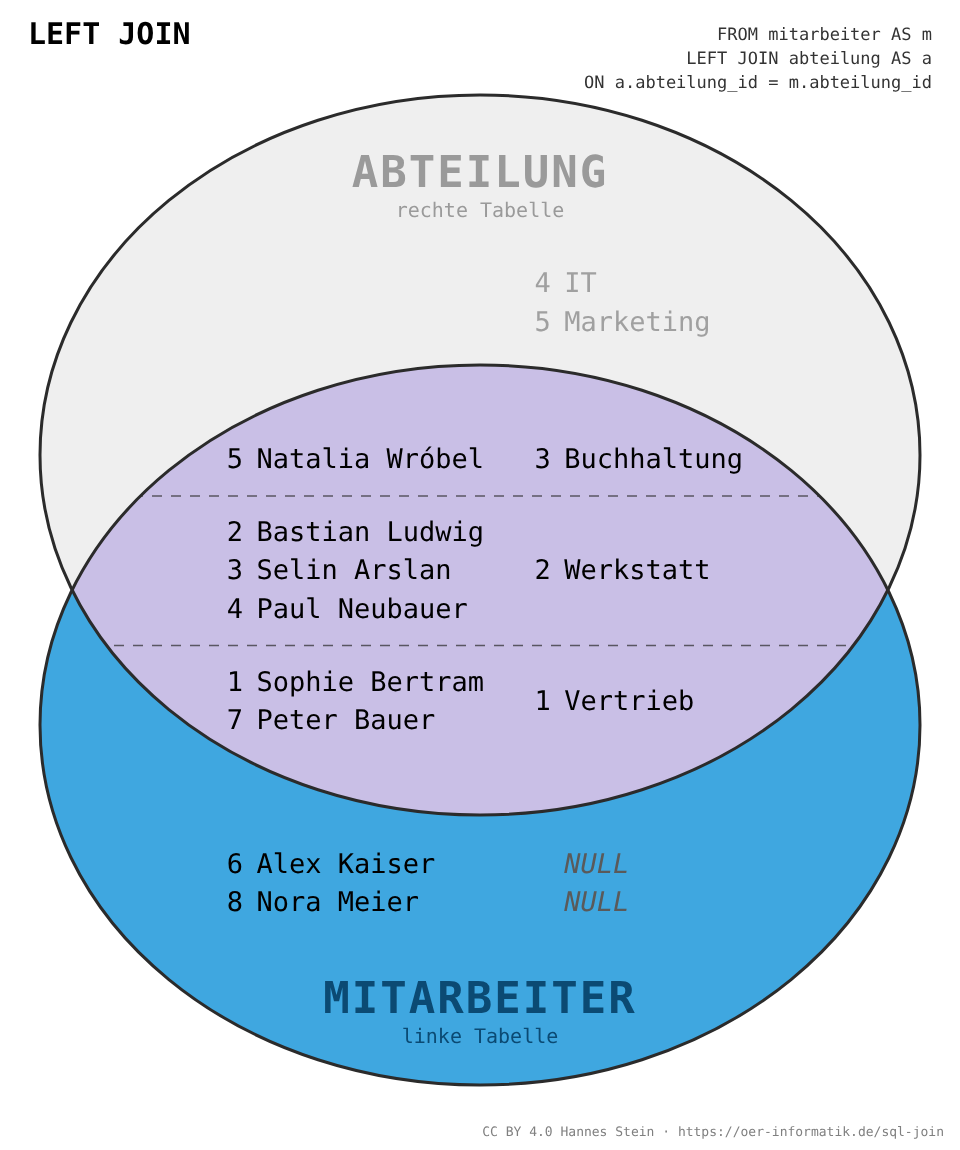
SELECT m.vorname, m.nachname, a.bezeichnung AS abteilung
FROM mitarbeiter AS m
LEFT JOIN abteilung AS a ON a.abteilung_id = m.abteilung_id;| vorname | nachname | abteilung |
|---|---|---|
| Sophie | Bertram | Vertrieb |
| Bastian | Ludwig | Werkstatt |
| Selin | Arslan | Werkstatt |
| Paul | Neubauer | Werkstatt |
| Natalia | Wróbel | Buchhaltung |
| Alex | Kaiser | NULL |
RIGHT JOIN
Der RIGHT [OUTER] JOIN behält entsprechend alle Zeilen der rechten Tabelle:
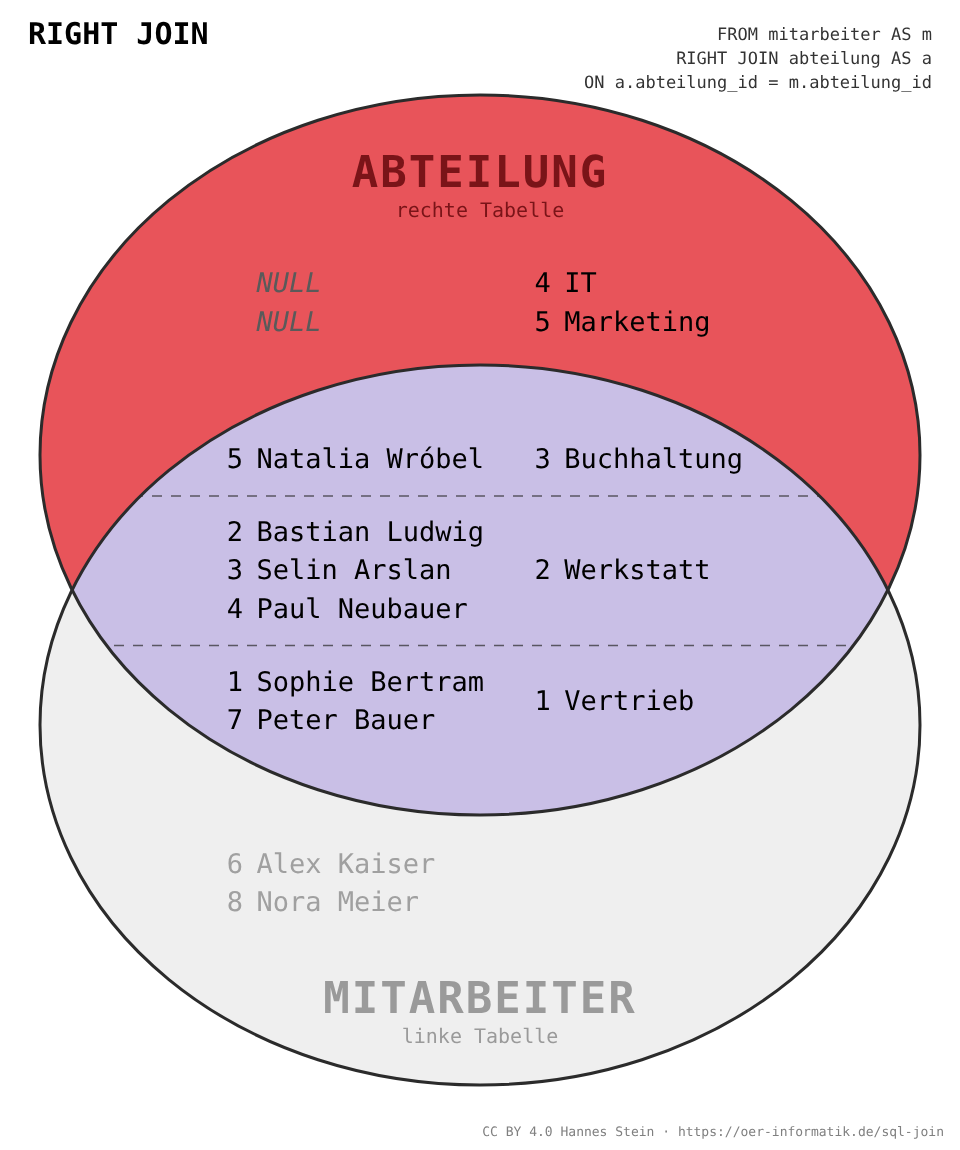
SELECT m.vorname, m.nachname, a.bezeichnung AS abteilung
FROM mitarbeiter AS m
  RIGHT JOIN abteilung AS a ON a.abteilung_id = m.abteilung_id;
Jetzt erscheint die Abteilung IT mit NULL bei Vor- und Nachname, Alex Kaiser fehlt. A RIGHT JOIN B ist gleichwertig zu B LEFT JOIN A. Viele Teams schreiben deshalb nur LEFT JOIN und stellen die Tabelle, deren Zeilen vollständig erscheinen sollen, an den Anfang.
FULL JOIN und sein Ersatz in MariaDB
Der FULL [OUTER] JOIN behält die Zeilen beider Tabellen. PostgreSQL, SQL Server, Oracle und SQLite (ab Version 3.39) kennen ihn. MariaDB und MySQL unterstützen ihn in den aktuellen Versionen nicht (bei MariaDB ist er in Entwicklung, Stand Herbst 2026). Dort vereinigst Du einen LEFT JOIN und einen RIGHT JOIN mit UNION, das die doppelt gelieferten Zeilen mit Partner entfernt:
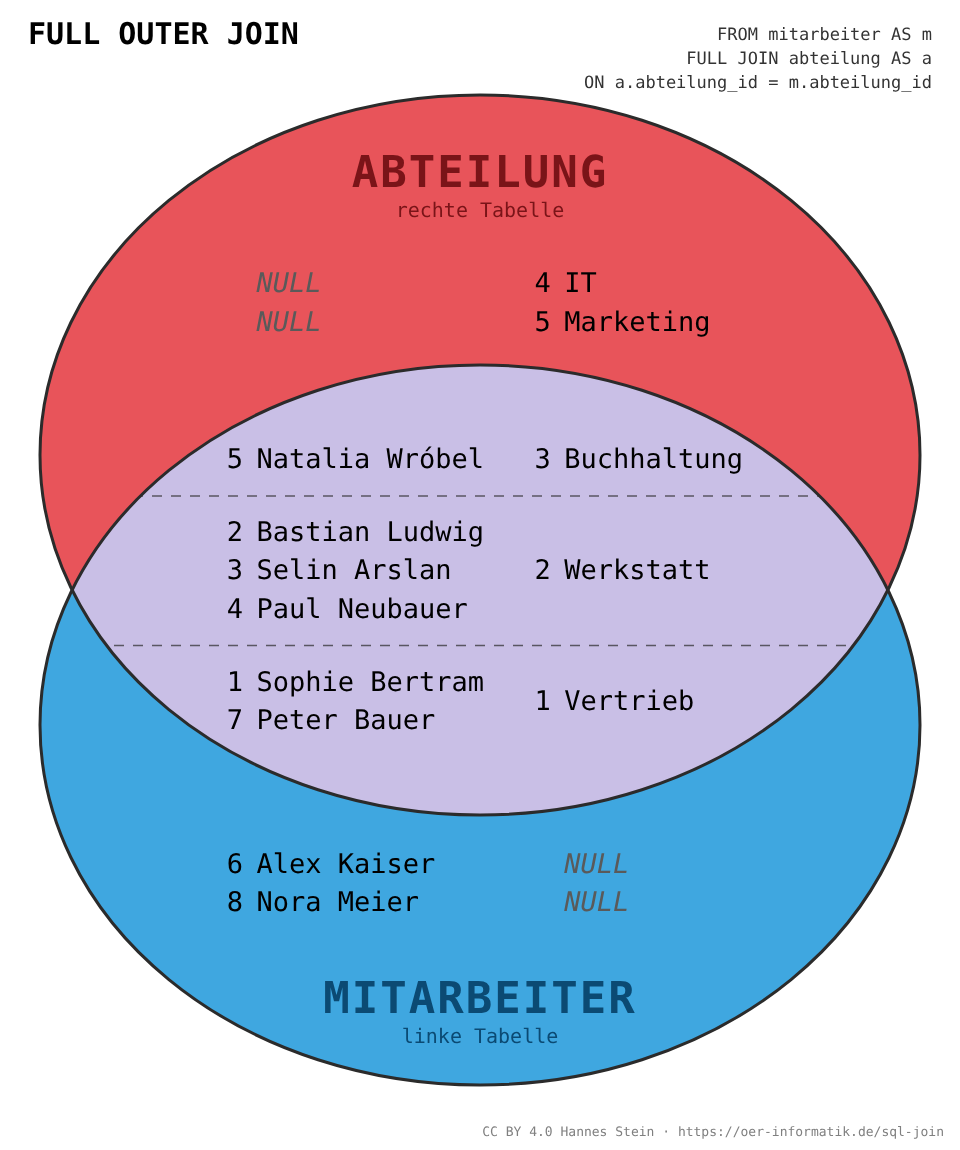
Das Ergebnis enthält die fünf Zeilen mit Partner, dazu Alex Kaiser ohne Abteilung und die Abteilung IT ohne Mitarbeitende. Mit UNION ALL stünden die fünf Zeilen mit Partner doppelt im Ergebnis.
Welche Join-Art passt? Die Ergebnistabelle verrät es
Viele Aufgaben geben eine Beispielausgabe vor. Daraus lässt sich die Join-Art ablesen:
| Beobachtung in der Ergebnistabelle | Join-Art |
|---|---|
| nur Zeilen, bei denen alle Spalten gefüllt sind | INNER JOIN |
Zeilen mit NULL in den Spalten der zweiten Tabelle oder Anzahl 0 |
LEFT JOIN (Haupttabelle links) bzw. RIGHT JOIN (Haupttabelle rechts) |
NULL-Zeilen auf beiden Seiten |
FULL JOIN bzw. LEFT … UNION … RIGHT |
Sollen zum Beispiel „alle Maschinentypen mit der Anzahl ihrer Maschinen“ ausgegeben werden und steht in der Beispielliste ein Typ mit 0, brauchst Du einen äußeren Verbund mit der Typ-Tabelle als Haupttabelle.
ON oder WHERE? Die häufigste Falle
Bei inneren Verbünden ist es egal, ob eine zusätzliche Bedingung in ON oder in WHERE steht. Bei äußeren Verbünden nicht. Die Datenbank wertet die Abfrage gedanklich so aus:
FROMundJOIN … ON: Verbund bilden, fehlende Partner mitNULLauffüllen.WHERE: Zeilen filtern.GROUP BY, Aggregatfunktionen,HAVING.SELECT,ORDER BY.
Beispiel: Gesucht ist je Abteilung die Anzahl der Mitarbeitenden, die eine vorgesetzte Person haben, auch Abteilungen mit 0. Ein naheliegender, aber falscher Versuch:
SELECT a.bezeichnung, COUNT(m.mitarbeiter_id) AS anzahl
FROM abteilung AS a
  LEFT JOIN mitarbeiter AS m ON m.abteilung_id = a.abteilung_id
WHERE m.vorgesetzt_id IS NOT NULL
GROUP BY a.abteilung_id, a.bezeichnung;
Er liefert nur Werkstatt (2) und Buchhaltung (1). Für die IT erzeugt der LEFT JOIN zwar eine Zeile, aber mit m.vorgesetzt_id = NULL; dasselbe gilt für Sophie im Vertrieb. Das WHERE wirft diese Zeilen danach hinaus, und der äußere Verbund wirkt wie ein innerer. Richtig ist, die Bedingung an die rechte Tabelle in die ON-Klausel zu schreiben. Sie entscheidet dann nur, welcher Partner passt:
SELECT a.bezeichnung, COUNT(m.mitarbeiter_id) AS anzahl
FROM abteilung AS a
  LEFT JOIN mitarbeiter AS m ON m.abteilung_id = a.abteilung_id
                            AND m.vorgesetzt_id IS NOT NULL
GROUP BY a.abteilung_id, a.bezeichnung;| bezeichnung | anzahl |
|---|---|
| Vertrieb | 0 |
| Werkstatt | 2 |
| Buchhaltung | 1 |
| IT | 0 |
Als Faustregel gilt: Bedingungen an die Tabelle, deren Zeilen vollständig erhalten bleiben sollen (die linke beim LEFT JOIN), gehören in WHERE. Bedingungen an die optionale Tabelle gehören in ON. Die Ausnahme ist der Anti-Join (siehe unten), bei dem Du gerade nach den fehlenden Partnern filterst.
COUNT(*) oder COUNT(spalte)?
Zählst Du nach einem äußeren Verbund mit COUNT(*), wird die mit NULL aufgefüllte Zeile mitgezählt: Die IT hätte dann 1 Person statt 0. COUNT(m.mitarbeiter_id) zählt nur Werte, die nicht NULL sind, und liefert die richtige 0. Zähle deshalb immer eine Spalte der optionalen Tabelle, am besten ihren Primärschlüssel.
Bei SUM, AVG, MIN und MAX ergibt eine Gruppe ohne Partner NULL. Soll stattdessen 0 oder ein Text erscheinen, hilft COALESCE(SUM(…), 0) bzw. IFNULL(…).
Nur wissen, ob es einen Partner gibt: DISTINCT und EXISTS
Manche Fragen interessieren sich nicht für die Partnerzeilen selbst, sondern nur dafür, ob es welche gibt: „Welche Abteilungen haben schon Mitarbeitende zu Schulungen geschickt?“, „Welche Treffpunkte wurden schon für Aktivitäten genutzt?“. Ein gewöhnlicher Verbund liefert dann jede Abteilung so oft, wie sie Teilnahmen hat:
SELECT a.bezeichnung
FROM abteilung AS a
  INNER JOIN mitarbeiter AS m ON m.abteilung_id = a.abteilung_id
  INNER JOIN teilnahme AS t ON t.mitarbeiter_id = m.mitarbeiter_id;
Das Ergebnis enthält sechs Zeilen: dreimal Werkstatt (Selin hat zwei Teilnahmen, Paul eine), zweimal Buchhaltung und einmal Vertrieb. Mit SELECT DISTINCT a.bezeichnung bleibt jede Abteilung nur einmal stehen. Gleichwertig ist ein sogenannter Semi-Join mit EXISTS, der die Partnerzeilen gar nicht erst in das Ergebnis holt:
SELECT a.bezeichnung
FROM abteilung AS a
WHERE EXISTS (SELECT 1
              FROM mitarbeiter AS m
                INNER JOIN teilnahme AS t ON t.mitarbeiter_id = m.mitarbeiter_id
              WHERE m.abteilung_id = a.abteilung_id);
DISTINCT wirkt immer auf die ganze Ergebniszeile: Nimmst Du zusätzlich den Namen der Mitarbeitenden in das SELECT auf, erscheinen die Abteilungen wieder mehrfach. Der Anti-Join im nächsten Abschnitt beantwortet die umgekehrte Frage „Wer hat keinen Partner?“.
Anti-Join: Datensätze ohne Partner finden
„Welche Mitarbeitenden haben noch an keiner Schulung teilgenommen?“, „Welche Betten sind heute frei?“, „Welche Haltepunkte werden nie genutzt?“ Solche Fragen beantwortet ein Anti-Join: ein LEFT JOIN, bei dem Du anschließend nur die Zeilen ohne Partner behältst:
SELECT m.vorname, m.nachname
FROM mitarbeiter AS m
  LEFT JOIN teilnahme AS t ON t.mitarbeiter_id = m.mitarbeiter_id
WHERE t.mitarbeiter_id IS NULL;
Ergebnis: Bastian Ludwig und Alex Kaiser. Prüfe in WHERE eine Spalte, die beim echten Partner nie NULL sein kann, am besten den Primär- oder Fremdschlüssel der rechten Tabelle. Gleichwertig ist eine Unterabfrage mit WHERE NOT EXISTS (SELECT * FROM teilnahme AS t WHERE t.mitarbeiter_id = m.mitarbeiter_id).
Sollen die Zeilen ohne Partner auf beiden Seiten erscheinen (Mitarbeitende ohne Abteilung und Abteilungen ohne Mitarbeitende), vereinigst Du zwei Anti-Joins mit UNION. Das ist das Gegenstück zum FULL JOIN: Es fehlen gerade die Zeilen mit Partner.
SELECT m.vorname, m.nachname, a.bezeichnung AS abteilung
FROM mitarbeiter AS m
  LEFT JOIN abteilung AS a ON a.abteilung_id = m.abteilung_id
WHERE a.abteilung_id IS NULL
UNION
SELECT m.vorname, m.nachname, a.bezeichnung
FROM mitarbeiter AS m
  RIGHT JOIN abteilung AS a ON a.abteilung_id = m.abteilung_id
WHERE m.mitarbeiter_id IS NULL;
Ergebnis: Alex Kaiser (ohne Abteilung) und die Abteilung IT (ohne Mitarbeitende). In DBMS mit FULL JOIN genügt … FULL JOIN … WHERE a.abteilung_id IS NULL OR m.mitarbeiter_id IS NULL.
Eine Tabelle in mehreren Rollen
Manchmal braucht eine Abfrage dieselbe Tabelle mehrmals. Dann bekommt jede Verwendung einen eigenen Alias.
Selbstverknüpfung (self join): vorgesetzt_id verweist auf mitarbeiter. Um zu jeder Person die vorgesetzte Person anzuzeigen, wird mitarbeiter einmal als „Mitarbeiter*in“ (m) und einmal als „Vorgesetzte*r“ (v) verwendet:
SELECT m.vorname, m.nachname,
       v.vorname AS vg_vorname, v.nachname AS vg_nachname
FROM mitarbeiter AS m
  LEFT JOIN mitarbeiter AS v ON v.mitarbeiter_id = m.vorgesetzt_id
ORDER BY m.mitarbeiter_id;| vorname | nachname | vg_vorname | vg_nachname |
|---|---|---|---|
| Sophie | Bertram | NULL | NULL |
| Bastian | Ludwig | NULL | NULL |
| Selin | Arslan | Bastian | Ludwig |
| Paul | Neubauer | Bastian | Ludwig |
| Natalia | Wróbel | Sophie | Bertram |
| Alex | Kaiser | Bastian | Ludwig |
Der LEFT JOIN sorgt dafür, dass auch die Geschäftsführung ohne Vorgesetzte erscheint. Nach demselben Muster werden Kategoriebäume (Kategorie und Oberkategorie) aufgelöst.
Mehrere Fremdschlüssel auf dieselbe Tabelle: Eine Bestellung hat eine Rechnungs- und eine Lieferadresse, beide in der Tabelle adresse; eine Mitfahrt hat eine Fahrerin und einen Mitfahrer, beide in nutzer. Auch hier wird die Tabelle je Rolle einmal mit eigenem Alias verbunden: JOIN adresse AS ra ON ra.adresse_id = b.rechnungsadresse_id JOIN adresse AS la ON la.adresse_id = b.lieferadresse_id. Ebenso lassen sich zwei Zeilen derselben Tabelle vergleichen, etwa die Zählerstände zweier Jahre (JOIN zaehlerstand AS z21 … JOIN zaehlerstand AS z22 …), um den Verbrauch als Differenz zu berechnen.
Verbund und Aggregation
Verbünde lassen sich mit allen Klauseln aus dem Artikel Aggregierende Funktionen kombinieren. Wichtig: Jede Spalte im SELECT, die nicht in einer Aggregatfunktion steht, gehört in GROUP BY. Gruppiere am besten zusätzlich nach dem Primärschlüssel, damit zwei Personen mit gleichem Namen nicht zusammenfallen.
Vorsicht, Vervielfachung
Jeder 1:n-Verbund kann Zeilen der „1-Seite“ vervielfachen. Das stört beim Auflisten nicht, beim Zählen und Summieren aber sehr. Beispiel: je Abteilung die Anzahl der Mitarbeitenden und die Anzahl der Schulungsteilnahmen:
SELECT a.bezeichnung,
       COUNT(m.mitarbeiter_id) AS mitarbeitende,
       COUNT(t.schulung_id)    AS teilnahmen
FROM abteilung AS a
  INNER JOIN mitarbeiter AS m ON m.abteilung_id = a.abteilung_id
  LEFT JOIN teilnahme AS t ON t.mitarbeiter_id = m.mitarbeiter_id
GROUP BY a.abteilung_id, a.bezeichnung;
Die Abfrage meldet für die Werkstatt 4 Mitarbeitende (es sind 3) und für die Buchhaltung 2 (es ist 1). Selin und Natalia haben je zwei Teilnahmen und stehen deshalb vor dem Gruppieren in zwei Zeilen. Abhilfen:
COUNT(DISTINCT m.mitarbeiter_id)zählt jede Person nur einmal (bei Summen hilftDISTINCTnicht).Jede Kennzahl in einer eigenen (korrelierten) Unterabfrage berechnen, zum Beispiel
(SELECT COUNT(*) FROM teilnahme AS t WHERE t.mitarbeiter_id = m.mitarbeiter_id). So zählt jede Unterabfrage unabhängig; mehr dazu im Artikel über Unterabfragen.Zuerst in einer abgeleiteten Tabelle je Person aggregieren und dann verbinden.
Kontrolliere Zählergebnisse deshalb immer an einem Beispiel, dessen Ergebnis Du von Hand kennst.
Zeitspannen über einen Verbund auswerten
Liegen Start- und Endzeitpunkt in verschiedenen Tabellen oder soll die Dauer je Gruppe einer anderen Tabelle ausgewertet werden (durchschnittliche Lieferzeit je Dienstleister, Bearbeitungsdauer je Mitarbeiter*in), verbindest Du die Tabellen und rechnest die Differenz in einer festen Einheit aus. Am sichersten ist es, zuerst in Minuten zu rechnen und dann umzurechnen; Datums- und Zeitfunktionen unterscheiden sich allerdings je Datenbanksystem. Beispiel mit den Tabellen sendung (sendung_id, dienstleister_id, versandt_am, zugestellt_am) und dienstleister (dienstleister_id, name) – durchschnittliche Transportdauer in Stunden:
Achte auf drei Punkte: Datensätze ohne Endzeitpunkt (NULL) fallen aus der Differenz heraus und sollten ausdrücklich ausgeschlossen oder gesondert gezählt werden; die Differenz von zwei reinen Uhrzeiten (TIME) funktioniert nur, wenn beide am selben Tag liegen; und TIMESTAMPDIFF schneidet angefangene Einheiten ab (89 Minuten sind 1 Stunde), deshalb erst in Minuten rechnen. In MariaDB rechnen TIME_TO_SEC und SEC_TO_TIME Uhrzeiten in Sekunden um und zurück, wenn das Ergebnis wieder als Uhrzeit (hh:mm:ss) erscheinen soll.
Ändern und Löschen über einen Verbund
Auch Änderungen hängen oft von einer anderen Tabelle ab: „Erhöhe die Preise aller Artikel des Herstellers X“, „Lösche alle Buchungen von Nutzenden ohne Einwilligung“. Standard-SQL löst das mit einer Unterabfrage, die in jedem Datenbanksystem funktioniert:
UPDATE mitarbeiter
SET abteilung_id = (SELECT abteilung_id FROM abteilung WHERE bezeichnung = 'Werkstatt')
WHERE nachname = 'Kaiser';
MariaDB und MySQL erlauben zusätzlich einen Verbund direkt in UPDATE und DELETE (multi-table UPDATE/DELETE):
Bei DELETE steht vor FROM die Tabelle (bzw. ihr Alias), aus der gelöscht wird; die verbundenen Tabellen liefern nur die Bedingungen. PostgreSQL und SQLite verwenden für UPDATE stattdessen UPDATE … SET … FROM andere_tabelle WHERE …. Teste solche Anweisungen vorher als SELECT mit derselben FROM- und WHERE-Klausel, dann siehst Du, welche Zeilen betroffen sind.
Die Join-Arten im Überblick
Alle Verbünde folgen derselben Grundform; eckige Klammern kennzeichnen optionale Teile:
SELECT tabelle1.spalte, tabelle2.spalte, …
FROM tabelle1
  [INNER | LEFT [OUTER] | RIGHT [OUTER]] JOIN tabelle2 ON verknuepfungsbedingung
[WHERE bedingung]
[GROUP BY …] [HAVING …]
[ORDER BY …]
[LIMIT …];| Join-Art | liefert | Schreibweise in MariaDB |
|---|---|---|
innerer Verbund (INNER JOIN) |
nur Zeilen mit Partner | A INNER JOIN B ON … |
linker äußerer Verbund (LEFT JOIN) |
alle Zeilen von A, fehlende Partner als NULL |
A LEFT JOIN B ON … |
rechter äußerer Verbund (RIGHT JOIN) |
alle Zeilen von B, fehlende Partner als NULL |
A RIGHT JOIN B ON … |
vollständiger äußerer Verbund (FULL JOIN) |
alle Zeilen beider Tabellen | A LEFT JOIN B ON … UNION A RIGHT JOIN B ON … |
| Anti-Join | Zeilen von A ohne Partner | A LEFT JOIN B ON … WHERE B.schluessel IS NULL |
| beidseitiger Anti-Join | Zeilen beider Tabellen ohne Partner | zwei Anti-Joins mit UNION |
Kreuzprodukt (CROSS JOIN) |
jede Zeile von A mit jeder von B | A CROSS JOIN B bzw. FROM A, B |
| Selbstverknüpfung | Zeilen einer Tabelle mit Zeilen derselben Tabelle | A AS a1 JOIN A AS a2 ON … |
NATURAL JOIN und USING sind Kurzformen des inneren bzw. äußeren Verbunds über gleichnamige Spalten (siehe oben).
Schritt für Schritt zur JOIN-Abfrage
Bei Aufgaben hat sich folgendes Vorgehen bewährt:
Ergebnis lesen: Welche Spalten sind gefordert, aus welchen Tabellen stammen sie? Gibt es Spaltenüberschriften, die Du per Alias nachbilden musst?
Weg im Datenmodell suchen: Welche Tabellen liegen zwischen den benötigten Spalten (Zwischentabellen, Tabellen nur für eine Bedingung)? Folge den Fremdschlüsseln und schreibe für jeden Schritt ein
JOIN … ON.Join-Art wählen: Sollen auch Zeilen ohne Partner (
NULL, 0) erscheinen? Dann äußerer Verbund mit der vollständigen Tabelle links.Bedingungen einordnen: Filter auf die Haupttabelle in
WHERE, Filter auf optionale Tabellen inON. Bekannte Namen statt IDs über den Verbund filtern.Gruppieren und sortieren:
GROUP BYmit allen nicht aggregierten Spalten,HAVINGfür Bedingungen an Aggregate,ORDER BYin der geforderten Reihenfolge.Kontrollieren: Stimmt die Zeilenzahl? Erscheinen Zeilen doppelt? Liefert
COUNTfür Zeilen ohne Partner 0?
Zum Üben findest Du drei umfangreiche Aufgaben in den Übungsaufgaben zu JOIN.
Exkurs: Verbünde in der Datenanalyse mit pandas
In der Datenanalyse liegen Daten oft nicht in einer Datenbank, sondern als CSV- oder JSON-Dateien vor und werden mit der Python-Bibliothek pandas ausgewertet. Auch dort werden Tabellen (DataFrames) verbunden – mit der Funktion merge, die einem SQL-Verbund entspricht:
import pandas as pd

mitarbeiter = pd.read_csv("mitarbeiter.csv")   # mitarbeiter_id, vorname, nachname, abteilung_id, ...
teilnahme   = pd.read_csv("teilnahme.csv")     # mitarbeiter_id, schulung_id
schulung    = pd.read_csv("schulung.csv")      # schulung_id, titel

# entspricht: mitarbeiter LEFT JOIN teilnahme ON ... LEFT JOIN schulung ON ...
daten = pd.merge(mitarbeiter, teilnahme, on="mitarbeiter_id", how="left")
daten = pd.merge(daten, schulung, on="schulung_id", how="left")merge-Parameter |
Bedeutung | SQL-Gegenstück |
|---|---|---|
on="spalte" bzw. on=["a", "b"] |
Verbundspalte(n) mit gleichem Namen in beiden DataFrames | ON l.spalte = r.spalte (mehrere Spalten mit AND) |
left_on=…, right_on=… |
Verbundspalten mit unterschiedlichen Namen | ON l.abteilung_id = r.id |
how="inner" (Standard) |
nur Zeilen mit Partner | INNER JOIN |
how="left" / how="right" |
alle Zeilen des linken bzw. rechten DataFrames | LEFT JOIN / RIGHT JOIN |
how="outer" |
alle Zeilen beider DataFrames | FULL OUTER JOIN |
Fehlende Partner erscheinen in pandas als NaN. Danach wird gefiltert – das entspricht dem WHERE. Mehrere Bedingungen werden mit & (und) bzw. | (oder) verknüpft, jede Bedingung steht in eigenen Klammern; and und or funktionieren hier nicht:
# Werkstatt-Mitarbeitende mit der Schulung "E-Bike-Diagnose"  -> Selin Arslan, Paul Neubauer
daten[(daten.abteilung_id == 2) & (daten.titel == "E-Bike-Diagnose")]

# Mitarbeitende ohne jede Schulung (Anti-Join)  -> Bastian Ludwig, Alex Kaiser
daten[daten.schulung_id.isna()]
Die Fallen sind dieselben wie in SQL: Verbindest Du nur über einen Teil eines zusammengesetzten Schlüssels, vervielfachen sich die Zeilen; ein innerer Verbund lässt Zeilen ohne Partner stillschweigend verschwinden. Kontrolliere deshalb nach jedem merge die Zeilenzahl (len(daten)).
Leitfragen
- Warum sind die Daten einer Datenbank auf mehrere Tabellen verteilt, und welche Rolle spielen Primär- und Fremdschlüssel beim Verbund?
Durch die Normalisierung steht jede Information nur einmal in der Datenbank; zusammengehörige Daten liegen deshalb in getrennten Tabellen. Ein Fremdschlüssel verweist auf den Primärschlüssel einer anderen Tabelle, und die Join-Bedingung vergleicht genau diese beiden Spalten, um die passenden Zeilen wieder zusammenzufügen; siehe Abschnitt „Das Beispiel: Abteilungen, Mitarbeitende und Schulungen“ und Abschnitt „Der innere Verbund: INNER JOIN“.
- Wie viele Zeilen liefert eine Abfrage über zwei Tabellen mit 8 und 7 Zeilen ohne Join-Bedingung, und warum?
Ohne Join-Bedingung entsteht das Kreuzprodukt: Jede Zeile der einen wird mit jeder Zeile der anderen Tabelle kombiniert, also 8 \cdot 7 = 56 Zeilen. Sinnvoll sind davon nur die Zeilen, in denen Fremd- und Primärschlüssel übereinstimmen; siehe Abschnitt „Das Kreuzprodukt: jede Zeile mit jeder“.
- Wie lautet eine Abfrage über eine n:m-Beziehung, und wie viele Join-Bedingungen braucht sie?
Eine n:m-Beziehung führt immer über die Zwischentabelle, z. B. FROM mitarbeiter AS m INNER JOIN teilnahme AS t ON t.mitarbeiter_id = m.mitarbeiter_id INNER JOIN schulung AS s ON s.schulung_id = t.schulung_id. Bei n Tabellen brauchst Du in der Regel n - 1 Join-Bedingungen, hier also zwei; siehe Abschnitt „Mehr als zwei Tabellen verknüpfen“.
- Woran erkennst Du an einer vorgegebenen Ergebnistabelle, ob ein
INNER,LEFT,RIGHToderFULL JOINnötig ist, und wie bildest Du denFULL JOINin MariaDB nach?
Sind alle Spalten gefüllt, reicht ein INNER JOIN; stehen NULL oder 0 in den Spalten der zweiten Tabelle, brauchst Du einen LEFT JOIN (Haupttabelle links) bzw. RIGHT JOIN (Haupttabelle rechts); NULL-Zeilen auf beiden Seiten verlangen einen FULL JOIN. In MariaDB bildest Du ihn nach, indem Du einen LEFT JOIN und einen RIGHT JOIN mit UNION vereinigst, das die doppelten Zeilen entfernt; siehe Abschnitt „Welche Join-Art passt? Die Ergebnistabelle verrät es“ und Abschnitt „FULL JOIN und sein Ersatz in MariaDB“.
- Warum macht eine Bedingung an die rechte Tabelle in
WHEREaus einemLEFT JOINpraktisch einenINNER JOIN, und warum liefertCOUNT(*)dort 1 statt 0?
WHERE wird erst nach dem Verbund ausgewertet: Die mit NULL aufgefüllten Zeilen ohne Partner erfüllen die Bedingung an die rechte Tabelle nicht und fliegen heraus, sodass nur noch Zeilen mit Partner übrig bleiben. Bedingungen an die optionale Tabelle gehören deshalb in ON. COUNT(*) zählt die aufgefüllte NULL-Zeile mit; COUNT(spalte) mit einer Spalte der optionalen Tabelle zählt nur Werte ungleich NULL und liefert 0; siehe Abschnitt „ON oder WHERE? Die häufigste Falle“ und Abschnitt „COUNT(*) oder COUNT(spalte)?“.
- Wie findest Du Datensätze, zu denen es keinen Partner gibt?
Mit einem Anti-Join: einem LEFT JOIN, nach dem Du in WHERE nur die Zeilen ohne Partner behältst, z. B. WHERE t.mitarbeiter_id IS NULL. Prüfe dabei eine Spalte, die beim echten Partner nie NULL ist, am besten den Schlüssel der rechten Tabelle; gleichwertig ist WHERE NOT EXISTS (…); siehe Abschnitt „Anti-Join: Datensätze ohne Partner finden“.
- Wann musst Du dieselbe Tabelle mehrfach mit unterschiedlichen Aliasen einbinden?
Immer dann, wenn eine Tabelle in mehreren Rollen gebraucht wird: bei einer Selbstverknüpfung (z. B. Mitarbeitende und ihre Vorgesetzten in derselben Tabelle), bei mehreren Fremdschlüsseln auf dieselbe Tabelle (Rechnungs- und Lieferadresse) oder wenn Du zwei Zeilen derselben Tabelle vergleichst (Zählerstände zweier Jahre). Jede Verwendung bekommt dann einen eigenen Alias; siehe Abschnitt „Eine Tabelle in mehreren Rollen“.
- Warum können Anzahlen nach mehreren 1:n-Verbünden zu groß sein, und was hilft dagegen?
Jeder 1:n-Verbund kann die Zeilen der 1-Seite vervielfachen; vor dem Gruppieren steht eine Person dann mehrfach im Ergebnis und wird mehrfach gezählt. Abhilfe schaffen COUNT(DISTINCT …) (nicht bei Summen), eine eigene (korrelierte) Unterabfrage je Kennzahl oder eine vorab aggregierte abgeleitete Tabelle; siehe Abschnitt „Vorsicht, Vervielfachung“.
- Wie änderst oder löschst Du Datensätze, deren Auswahl von einer anderen Tabelle abhängt?
In Standard-SQL nutzt Du eine Unterabfrage in SET oder WHERE. MariaDB und MySQL erlauben zusätzlich einen Verbund direkt in UPDATE … INNER JOIN … SET … WHERE … und DELETE alias FROM … INNER JOIN … WHERE …, wobei vor FROM die Tabelle steht, aus der gelöscht wird. Teste solche Anweisungen vorher als SELECT mit denselben Klauseln; siehe Abschnitt „Ändern und Löschen über einen Verbund“.
- Was ist das Konzept hinter einem JOIN, und wie vermeidest Du doppelte Zeilen, wenn nur gefragt ist, welche Datensätze einen Partner haben?
Ein JOIN fügt die Datensätze mehrerer Tabellen über eine Verbundbedingung – meist Fremdschlüssel gleich Primärschlüssel – zu Ergebniszeilen zusammen; die Join-Art entscheidet, ob Datensätze ohne Partner erhalten bleiben. Interessiert nur, ob es einen Partner gibt, entfernst Du die Mehrfachzeilen mit SELECT DISTINCT oder formulierst einen Semi-Join mit EXISTS; siehe Abschnitt „Nur wissen, ob es einen Partner gibt: DISTINCT und EXISTS“.
- Wie entspricht
pandas.mergeeinem SQL-Verbund, und worauf musst Du beim Filtern eines DataFrames achten?
on bzw. left_on/right_on geben die Verbundspalten an (wie ON), how die Join-Art (inner, left, right, outer); fehlende Partner werden zu NaN. Beim Filtern verknüpfst Du mehrere Bedingungen mit & bzw. | und setzt jede Bedingung in Klammern, and/or funktionieren nicht; siehe Abschnitt „Exkurs: Verbünde in der Datenanalyse mit pandas“.
Links und weitere Informationen
als Nachschlagewerk: MariaDB Knowledge Base: JOIN Syntax
als Nachschlagewerk: MariaDB Knowledge Base: UPDATE und DELETE (jeweils mit Abschnitt zu mehreren Tabellen)
zum Stand von FULL OUTER JOIN in MariaDB: MariaDB-Ticket MDEV-13648
für die Datenanalyse: pandas-Dokumentation: Merge, join, concatenate and compare
Hinweis zur Nachnutzung als Open Educational Resource (OER)
Dieser Artikel und seine Texte, Bilder, Grafiken, Code und sonstiger Inhalt sind - sofern nicht anders angegeben - lizenziert unter CC BY 4.0. Nennung gemäß TULLU-Regel bitte wie folgt: “SQL: Abfragen über mehrere Tabellen mit JOIN” von oer-informatik.de (H. Stein), Lizenz: CC BY 4.0. Der Artikel wurde unter https://oer-informatik.de/sql-join veröffentlicht, die Quelltexte sind in weiterverarbeitbarer Form verfügbar im Repository unter https://gitlab.com/oer-informatik/db-sql/dml-select-queries. Erstellt mit KI-Assistenz; von mir umfassend redaktionell überarbeitet, geprüft und freigegeben. Stand: 26.10.2026.
[Kommentare zum Artikel lesen, schreiben] / [Artikel teilen] / [gitlab-Issue zum Artikel schreiben]