Teststrategie und Qualitätssicherung: Wie Software gut wird und gut bleibt
https://bildung.social/@oerinformatik/
https://oer-informatik.de/teststrategie
Qualitätssicherung, Teststrategie, Blackbox-Test, Whitebox-Test, V-Modell, Teststufen, Regressionstest, Review, Statische Codeanalyse, Testkonzept
tl/dr; (ca. 24 min Lesezeit): Gute Software entsteht nicht durch Zufall und auch nicht durch einen einzigen Test am Schluss. Dieser Artikel ordnet die Maßnahmen der Qualitätssicherung (konstruktiv, analytisch, statisch, dynamisch), erklärt Reviews und statische Codeanalyse, vergleicht Blackbox- und Whitebox-Tests, unterscheidet Syntax-, Semantik- und Laufzeitfehler, stellt die Teststufen im V-Modell und den User Acceptance Test vor, zeigt, wofür Regressionstests da sind, und beschreibt, was in ein Testkonzept gehört. Zum Schluss geht es darum, wie Du zu einem Vorschlag für die Qualitätssicherung fachlich begründet Stellung nimmst [AI-Assisted]. (Zuletzt geändert am 28.10.2026)
Dieser Artikel ist Teil einer Artikelreihe über das Testen: Teststrategie und Qualitätssicherung / Blackbox-Testfälle erstellen / Whitebox-Tests und Code-Coverage / Übungsaufgaben zu Teststrategie und Qualitätssicherung
Schon fit in diesem Thema? Nutze die Kann-Liste und die Leitfragen unter dem Artikel als Checkliste, ob Du die relevanten Kompetenzen bereits hast.
Als Grundlagen der Qualitätssicherung kann ich nach Durchlesen des Artikels…
… konstruktive und analytische Maßnahmen der Qualitätssicherung unterscheiden und mindestens fünf Maßnahmen nennen und beschreiben.
… statische Prüfungen (Reviews, statische Codeanalyse) und dynamische Tests unterscheiden und erklären, welche Fehlerarten sie jeweils finden.
… Blackbox- und Whitebox-Tests beschreiben (Sicht auf das Testobjekt, Herkunft der Testfälle, wer testet) und je zwei Vor- und Nachteile nennen.
… die Teststufen Komponenten-, Integrations-, System- und Abnahmetest im V-Modell darstellen und ihnen die Entwurfsdokumente zuordnen, gegen die sie prüfen.
… Syntax-, Semantik- und Laufzeitfehler mit Beispiel beschreiben, Umstände nennen, unter denen eine Exception auftritt, und zuordnen, welche Maßnahme welche Fehlerart findet.
… erläutern, was ein User Acceptance Test ist und welche Voraussetzungen vor seinem Start erfüllt sein müssen.
… den Zweck von Regressionstests erläutern und sie vom Fehlernachtest unterscheiden.
… mindestens fünf Inhalte eines Testkonzepts beschreiben.
… zu einem Vorschlag für die Qualitätssicherung fachlich begründet Stellung nehmen.
Darüber hinaus kann ich als Expertenwissen Qualitätssicherung…
… die Reviewarten informelles Review, Walkthrough, technisches Review und Inspektion nach Formalität und Rollen unterscheiden.
… erklären, wie Regressionstests in einer CI/CD-Pipeline automatisiert und risikobasiert ausgewählt werden.
… Ein- und Endekriterien für Teststufen formulieren und begründen, warum Testdaten anonymisiert oder synthetisch sein müssen.
Stell Dir vor, ein Team liefert eine neue Version seiner App aus. Die neue Funktion läuft wunderbar, aber plötzlich können sich Nutzende nicht mehr anmelden – ein Fehler in einem Teil, den niemand angefasst zu haben glaubt. Oder: Die App rechnet korrekt, aber genau das, was die Auftraggeberin eigentlich wollte, wurde nie umgesetzt. Beide Fehler hätte man finden können, aber mit ganz unterschiedlichen Mitteln.
Qualitätssicherung (QS) ist die Gesamtheit aller Maßnahmen, die dafür sorgen, dass ein Produkt die vereinbarten Anforderungen erfüllt. Was „Qualität“ bei Software bedeutet, beschreibt die Norm ISO/IEC 25010 mit Qualitätsmerkmalen wie Funktionalität, Zuverlässigkeit, Benutzbarkeit, Sicherheit oder Wartbarkeit. Dieser Artikel klärt, wie man diese Qualität erreicht und nachweist: mit einer Teststrategie, die festlegt, was mit welchen Mitteln, auf welcher Stufe und bis zu welchem Kriterium geprüft wird.
Die Mindmap zeigt die Bausteine, um die es in diesem Artikel geht: konstruktive Maßnahmen, die Fehler vermeiden, analytische Maßnahmen, die Fehler finden (statisch ohne Ausführen, dynamisch durch Tests), und das Testkonzept, das alles plant.

Fehler vermeiden oder Fehler finden? Die Maßnahmen im Überblick
Eine alte Faustregel der Softwaretechnik sagt: Je später ein Fehler entdeckt wird, desto teurer wird er. Ein Missverständnis in den Anforderungen lässt sich in einem Gespräch klären; ist es erst programmiert, getestet und ausgeliefert, kostet seine Beseitigung ein Vielfaches (oft wird grob mit dem Verhältnis 1 : 10 : 100 gerechnet). Deshalb setzt Qualitätssicherung an zwei Stellen an:
Konstruktive Maßnahmen sollen Fehler von vornherein vermeiden. Sie wirken auf den Entstehungsprozess.
Analytische Maßnahmen sollen vorhandene Fehler finden. Sie prüfen ein Arbeitsergebnis. Analytische Maßnahmen werden weiter unterteilt in statische Prüfungen (das Ergebnis wird untersucht, aber nicht ausgeführt) und dynamische Prüfungen (das Programm wird mit Testdaten ausgeführt, also getestet).
| Art | Maßnahme | Wie sie die Qualität verbessert |
|---|---|---|
| konstruktiv | genaue, prüfbare Anforderungen (Lastenheft, Pflichtenheft, User Stories mit Akzeptanzkriterien) | Alle wissen, was gebaut werden soll; Tests haben eine eindeutige Grundlage. |
| konstruktiv | ein festgelegtes Vorgehensmodell (z. B. Scrum, V-Modell) | Planung, Rückmeldung der Kundschaft und Prüfschritte sind fester Teil des Ablaufs. |
| konstruktiv | Programmier- und Dokumentationsrichtlinien (Coding Conventions, Vorlagen) | Einheitlicher, lesbarer Code und vollständige Dokumentation erleichtern Wartung und Fehlersuche. |
| konstruktiv | geeignete, bewährte Werkzeuge (IDE, Versionsverwaltung, CI/CD-Pipeline, Bibliotheken) | Werkzeuge verhindern ganze Fehlerklassen (z. B. Syntaxfehler, verlorene Änderungen) und automatisieren Prüfungen. |
| konstruktiv | Qualifizierung und Zertifizierung der Beteiligten (z. B. Schulungen, Zertifikat „Certified Tester“) | Wer Methoden kennt, macht weniger Fehler und testet systematischer. |
| konstruktiv | Prototypen, Mockups, Pair Programming, Architektur- und Entwurfsmuster | Missverständnisse und Entwurfsfehler fallen früh auf, bewährte Lösungen werden wiederverwendet. |
| konstruktiv | Datenschutz und Sicherheit von Anfang an (Privacy by Design, Art. 25 DSGVO) | Gesetzliche Vorgaben werden eingehalten, statt sie später teuer nachzurüsten. |
| analytisch, statisch | Reviews von Anforderungen, Entwürfen, Code und Testfällen | Menschen finden Unklarheiten, Denkfehler und Verstöße gegen Richtlinien, bevor etwas ausgeführt wird. |
| analytisch, statisch | statische Codeanalyse (Linter, Analysewerkzeuge) | Werkzeuge finden automatisch Stilverstöße, toten Code und typische Fehlermuster. |
| analytisch, dynamisch | Tests auf allen Teststufen, standardisierte Testumgebung, -verfahren und -daten | Fehler im Verhalten werden reproduzierbar gefunden; Ergebnisse sind vergleichbar. |
Tipp: Wird verlangt, eine Maßnahme zu beschreiben, genügt das Stichwort nicht. Nenne die Maßnahme und wie sie konkret zu besserer Qualität führt, etwa: „Code-Reviews: Eine zweite Entwicklerin liest jede Änderung vor der Übernahme in den Hauptzweig. Dadurch fallen Denkfehler und Verstöße gegen die Programmierrichtlinien auf, bevor sie ausgeliefert werden.“
Welche Fehler sucht die Qualitätssicherung? Syntax-, Semantik- und Laufzeitfehler
Beim Programmieren unterscheidet man drei Fehlerarten (ausführlicher im Artikel Programmiersprachen, Abschnitt Fehlerarten). Für die Teststrategie ist wichtig, wer oder was sie jeweils findet:
| Fehlerart | Beschreibung | Beispiel | Wer oder was findet ihn? |
|---|---|---|---|
| Syntaxfehler | Der Quelltext verstößt gegen die Grammatik der Programmiersprache; das Programm lässt sich nicht übersetzen bzw. startet nicht. | fehlender Doppelpunkt nach if in Python, vergessenes Semikolon in Java, innt statt int |
Editor, Compiler bzw. Interpreter, statische Codeanalyse |
| Semantikfehler (Logikfehler) | Das Programm läuft, tut aber nicht das Beabsichtigte und liefert falsche Ergebnisse. | + statt -, „kleiner“ statt „kleiner gleich“, Ergebnis in der falschen Variablen gespeichert |
Tests mit erwarteten Ergebnissen (Black- und Whitebox), Reviews |
| Laufzeitfehler | Das Programm ist syntaktisch korrekt, gerät bei der Ausführung aber in einen Zustand, in dem es nicht weiterarbeiten kann; es wird eine Ausnahme (Exception) ausgelöst und – wenn sie nicht behandelt wird – das Programm abgebrochen. | siehe Liste unten | Tests mit ungültigen und extremen Eingaben, Code-Reviews, Fehlerbehandlung im Code |
Typische Umstände, unter denen eine Exception auftritt:
ungültige Eingaben oder Typumwandlungen, z. B. der Text
"49,90"soll in eine Zahl umgewandelt werden;unmögliche Rechenoperationen, z. B. Division durch null;
Zugriff auf nicht vorhandene Elemente, z. B. Index außerhalb eines Arrays oder einer Liste, Zugriff auf eine
null-Referenz;fehlende Ressourcen: Datei nicht vorhanden, keine Schreibrechte, Datenbank oder Netzwerkdienst nicht erreichbar, Speicher erschöpft.
Gute Software fängt erwartbare Ausnahmen ab (try/except bzw. try/catch) und reagiert sinnvoll, z. B. mit einer verständlichen Meldung. Tests sollten deshalb gezielt auch solche Fehlerfälle prüfen.
Prüfen ohne Ausführen: Reviews und statische Codeanalyse
Reviews
Bei einem Review lesen und prüfen Menschen ein Arbeitsergebnis, ohne es auszuführen. Das geht mit allem, was geschrieben ist: Anforderungen, User Stories, Klassendiagramme, Quelltext, Testfälle, Handbücher. Reviews finden Fehler, die kein Test aufdecken kann, solange es noch keinen lauffähigen Code gibt – zum Beispiel widersprüchliche oder fehlende Anforderungen. Außerdem verteilen sie Wissen im Team: Wer fremden Code begutachtet, kennt ihn danach.
Je nach Formalität werden (z. B. im Lehrplan „Certified Tester Foundation Level“ des ISTQB und in der Norm ISO/IEC 20246) folgende Reviewarten unterschieden:
| Reviewart | Ablauf | typischer Einsatz |
|---|---|---|
| informelles Review | Eine Kollegin schaut „kurz drüber“, ohne festen Ablauf und meist ohne Protokoll. | schnelle Rückmeldung, Pair Programming |
| Walkthrough | Die Autorin führt die Gruppe durch ihr Ergebnis und erklärt es; die anderen fragen nach. | Wissensaustausch, Verständnis schaffen |
| technisches Review | Fachleute prüfen das Ergebnis gegen Vorgaben und einigen sich auf Bewertung und Lösung. | Entwürfe, Architekturentscheidungen |
| Inspektion | formaler Ablauf mit Rollen (Moderation, Gutachtende, Protokoll), Checklisten, Fehlerprotokoll und Kennzahlen | sicherheitskritische Teile, Verträge, Schnittstellen |
Im Alltag vieler Teams ist das Code-Review per Merge- oder Pull-Request üblich: Eine Änderung wird in einem eigenen Zweig der Versionsverwaltung entwickelt; bevor sie in den Hauptzweig übernommen wird, muss mindestens eine andere Person sie lesen, kommentieren und freigeben.
Statische Codeanalyse („automatisches Code-Review“)
Werkzeuge zur statischen Codeanalyse (z. B. Linter wie Checkstyle oder ESLint, Plattformen wie SonarQube) untersuchen den Quelltext automatisch. Sie finden unter anderem:
Verstöße gegen Programmierrichtlinien (Benennung, Formatierung),
ungenutzte Variablen und toten Code,
typische Fehlermuster (mögliche Nullzeiger, nicht geschlossene Ressourcen, Vergleich von Zeichenketten mit
==in Java),bekannte Sicherheitsmuster (z. B. aus Zeichenketten zusammengesetzte SQL-Anweisungen) und veraltete Bibliotheken mit bekannten Schwachstellen,
Kennzahlen wie zu hohe Komplexität oder doppelten Code.
Ihre Grenze: Ein Werkzeug kennt die Anforderungen nicht. Ob die Methode das Richtige berechnet, ob ein Name für das Team verständlich ist oder ob der Entwurf zum Problem passt, kann es nicht beurteilen. Außerdem meldet es auch Dinge, die gar keine Fehler sind (falsch positive Meldungen). Statische Analyse ergänzt Reviews durch Menschen, ersetzt sie aber nicht.
Testen von außen oder von innen: Blackbox und Whitebox
Beim dynamischen Test wird das Testobjekt mit festgelegten Eingaben ausgeführt; das tatsächliche Ergebnis wird mit dem erwarteten Ergebnis verglichen. Wie ein vollständiger Testfall aufgebaut ist (Vorbedingung, Eingabe, erwartetes Ergebnis, tatsächliches Ergebnis, Bewertung), zeigt der Artikel Blackbox-Testfälle erstellen. Woher die Testfälle kommen, unterscheidet zwei grundlegende Verfahren.
Blackbox-Test: gegen die Spezifikation
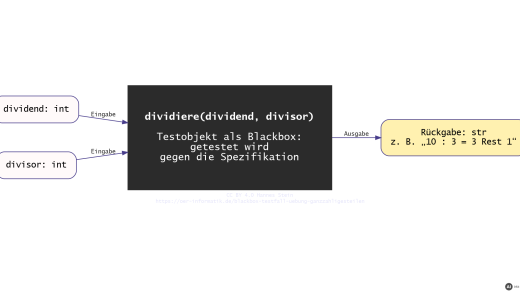
Beim Blackbox-Test (funktionsorientierter Test) ist das Testobjekt eine „schwarze Kiste“: Wie es innen programmiert ist, ist unbekannt oder wird bewusst nicht beachtet. Die Testfälle werden aus der Spezifikation abgeleitet (Anforderungen, Pflichtenheft, Schnittstellenbeschreibung). Die Spezifikation legt auch fest, welches Ergebnis erwartet wird. Typische Verfahren sind Äquivalenzklassenbildung und Grenzwertanalyse.
Blackbox-Tests können schon vor der Implementierung geschrieben werden (testgetriebene Entwicklung) und decken dabei Lücken in der Spezifikation auf.
Sie können von Personen ohne Programmierkenntnisse durchgeführt werden, z. B. von Fachabteilung oder Kundschaft beim Abnahmetest.
Sie finden fehlende Funktionen: Was spezifiziert, aber nicht programmiert ist, fällt auf.
Wie viel sie aufdecken, entscheidet sich bei der Auswahl der Testdaten. Programmteile, die in der Spezifikation nicht vorkommen (Sonderfälle, „vergessene“ Zweige), werden womöglich nie ausgeführt.
Schlägt ein Test fehl, ist zunächst unklar, wo im Code der Fehler liegt.
Whitebox-Test: gegen die Struktur des Codes
Beim Whitebox-Test (strukturorientierter Test, auch Glassbox-Test) ist der Quelltext bekannt. Die Testfälle werden anhand der Struktur des Quelltextes ausgewählt: Jede Anweisung, jeder Zweig einer Verzweigung oder sogar jeder Pfad soll mindestens einmal durchlaufen werden. Wie gut das gelingt, misst die Testabdeckung (Code-Coverage), etwa als Anweisungs-, Zweig- oder Pfadüberdeckung. Das erwartete Ergebnis kommt aber auch hier aus der Spezifikation – sonst würde der Code nur gegen sich selbst getestet. Whitebox-Tests schreiben meist die Entwickelnden selbst, oft als automatisierte Unit-Tests. Details und Übungen findest Du im Artikel Whitebox-Tests und Code-Coverage.
Vorteile gegenüber dem Blackbox-Test:
Wie gründlich getestet wurde, lässt sich messen: Ein Coverage-Werkzeug zeigt Zeile für Zeile, was nie ausgeführt wurde – auch toten Code.
Auch Code jenseits der Spezifikation kommt auf den Prüfstand: Sonderregeln, Fehlerbehandlung, vergessene Reste früherer Versionen. Ein Blackbox-Test trifft so etwas höchstens zufällig.
Schlägt ein Testfall fehl, ist bekannt, über welchen Zweig er gelaufen ist; die Fehlerursache ist schneller gefunden.
Beim Lesen des Codes fallen überflüssige Bedingungen, doppelte Abschnitte und fest eingetragene Zahlen auf – Ansatzpunkte, um den Code zu vereinfachen.
Nachteile:
Der Quelltext muss offengelegt werden; bei zugekaufter Software ist das oft nicht möglich oder nicht gewollt.
Bei großen Programmen ist die Analyse aufwendig; vollständige Pfadüberdeckung ist bei Schleifen meist gar nicht erreichbar.
Fehlende Funktionen findet ein Whitebox-Test nicht: Was nie programmiert wurde, hat keine Struktur, die man überdecken könnte.
Vergleich und Kombination
| Blackbox-Test | Whitebox-Test | |
|---|---|---|
| Sicht | von außen, Code unbekannt | von innen, Code bekannt |
| Testfälle aus | Spezifikation (Anforderungen) | Struktur des Quelltextes (Anweisungen, Zweige, Pfade) |
| typische Verfahren | Äquivalenzklassen, Grenzwerte, Entscheidungstabellen, Anwendungsfälle | Anweisungs-, Zweig-, Pfadüberdeckung |
| wer testet | Testteam, Fachabteilung, Kundschaft | Entwickelnde |
| typische Teststufe | System- und Abnahmetest, auch Komponententest | Komponenten- und Integrationstest |
| findet besonders | fehlende oder falsch umgesetzte Funktionen | ungetestete Zweige, nicht spezifizierte Sonderfälle, toten Code |
Beide Verfahren ergänzen sich. Eine bewährte Reihenfolge: zuerst Blackbox-Testfälle aus der Spezifikation erstellen, dann mit einem Coverage-Werkzeug prüfen, welche Teile des Codes dabei nicht ausgeführt wurden, und dafür gezielt Whitebox-Testfälle ergänzen. Mischformen, bei denen die Testenden die Architektur kennen, aber nicht den Code im Detail, heißen Graybox-Tests.
Teststufen und das V-Modell
Software wird nicht nur als Ganzes getestet, sondern auf mehreren Teststufen, die jeweils eine andere Frage beantworten. Das V-Modell macht anschaulich, dass zu jeder Entwurfsstufe auf der linken Seite eine Teststufe auf der rechten Seite gehört, die gegen genau dieses Dokument prüft.

| Teststufe | Testobjekt | Testbasis (prüft gegen) | Wer testet? | typische Fehler |
|---|---|---|---|---|
| Komponententest (Unit-Test, Modultest) | einzelne Methode, Klasse, Modul – isoliert, Abhängigkeiten durch Stubs/Mocks ersetzt | Komponentenentwurf | Entwickelnde, automatisiert | falsche Berechnung, fehlende Fehlerbehandlung, Grenzfälle |
| Integrationstest | Zusammenspiel mehrerer Komponenten oder Systeme (Schnittstellen, Datenbank, REST-API) | technischer Systementwurf (Architektur, Schnittstellen) | Entwickelnde, Testteam | falsche Datenformate, vertauschte Parameter, Zeitverhalten |
| Systemtest | das vollständige System in einer produktionsnahen Testumgebung | funktionaler Systementwurf (Pflichtenheft) | unabhängiges Testteam | fehlende Funktionen, nicht-funktionale Mängel (Last, Sicherheit, Benutzbarkeit) |
| Abnahmetest | das System im Einsatz bei bzw. mit der Kundschaft | Anforderungen der Auftraggebenden (Lastenheft, Akzeptanzkriterien) | Auftraggebende, Fachabteilung, künftige Nutzende | „richtig gebaut, aber nicht das Richtige gebaut“ |
Der neuere ISTQB-Lehrplan unterteilt die Integration noch in Komponentenintegrations- und Systemintegrationstest. Neben den Stufen unterscheidet man Testarten: funktionale Tests (Was tut das System?) und nicht-funktionale Tests wie Last- und Performancetests, Sicherheitstests (z. B. Penetrationstests), Usability-Tests und Kompatibilitätstests. Sie können auf mehreren Stufen vorkommen.
Auf der rechten Seite des V wird bis zum Systemtest verifiziert („Bauen wir das Produkt richtig?“ – stimmt das Ergebnis mit seiner Vorgabe überein?), mit dem Abnahmetest wird zusätzlich validiert („Bauen wir das richtige Produkt?“ – erfüllt es den Zweck der Nutzenden?). Agile Teams arbeiten nicht in einem großen V, durchlaufen die Stufen aber in jedem Sprint im Kleinen; die Testpyramide empfiehlt dabei viele schnelle Unit-Tests, weniger Integrationstests und wenige, aufwendige Ende-zu-Ende-Tests.
Abnahmetest als User Acceptance Test (UAT)
Beim User Acceptance Test (UAT, Benutzerakzeptanztest) prüfen künftige Nutzende oder die Fachabteilung die fertige Software unter möglichst realen Bedingungen: Lässt sich damit die eigene Arbeit erledigen, ist sie verständlich und bedienbar, erfüllt sie die vereinbarten Akzeptanzkriterien? Anders als im Systemtest, in dem ein Testteam gegen das Pflichtenheft prüft, geht es um die Frage, ob die Software für ihren Zweck taugt (Validierung). Das Ergebnis ist häufig die Grundlage für die formale Abnahme.
Ein UAT lohnt sich nur, wenn vorher einige Voraussetzungen erfüllt sind:
Die Anwendung ist funktional vollständig entwickelt; während des UAT kommen keine neuen Funktionen hinzu, sonst verhält sie sich ständig anders.
Systemtest und Regressionstests sind abgeschlossen, alle bekannten schweren Fehler sind behoben und nachgetestet; offen sind höchstens kosmetische Mängel.
Eine UAT-Umgebung steht bereit, die dem späteren Einsatz entspricht (Geräte, Netz, realistische, aber datenschutzgerechte Testdaten) – Laborbedingungen verfälschen das Ergebnis.
Akzeptanzkriterien und Testszenarien aus Sicht der Nutzenden sind vereinbart, die Testpersonen sind ausgewählt, eingewiesen und haben Zeit eingeplant, und es ist geklärt, wie Fehler gemeldet und bewertet werden.
Das Aktivitätsdiagramm fasst den Weg zur Abnahme zusammen: Erst wenn System- und Regressionstests höchstens noch kosmetische Mängel zeigen, beginnt der UAT. Kritische Fehler aus dem UAT werden behoben, nachgetestet und durch Regressionstests abgesichert, bis die Akzeptanzkriterien erfüllt sind.

Regressionstests: Damit Bewährtes nicht kaputtgeht
Jede Änderung an Software kann Nebenwirkungen haben – auch in Teilen, die scheinbar nichts damit zu tun haben. Eine Bibliothek wird aktualisiert, eine Methode für eine neue Funktion erweitert, ein Fehler behoben: Plötzlich funktioniert etwas nicht mehr, das vorher lief. Ein solcher Rückschritt heißt Regression.
Ein Regressionstest führt Testfälle, die schon einmal bestanden wurden, nach einer Änderung erneut aus. Ganz gleich, ob eine neue Funktion dazukommt, Code umgebaut, eine Bibliothek aktualisiert oder ein Fehler korrigiert wurde: Der Regressionstest soll aufdecken, ob die Änderung Seiteneffekte hat – ob sie also neue Fehler eingebaut oder bisher verdeckte Fehler freigelegt hat, sodass etwas, das vorher funktionierte, jetzt versagt. So ähnlich definiert auch das Glossar des International Software Testing Qualifications Board (ISTQB) den Begriff.
Davon zu unterscheiden ist der Fehlernachtest (Bestätigungstest, confirmation test): Er prüft nur, ob der gemeldete Fehler wirklich behoben ist, indem der fehlgeschlagene Testfall wiederholt wird. Der Regressionstest prüft dagegen, ob durch die Korrektur anderswo nichts kaputtgegangen ist.
Regressionstests lohnen sich besonders, wenn sie automatisiert sind:
Unit- und Integrationstests laufen in der CI-Pipeline bei jedem Commit bzw. jedem Merge-Request; ein fehlgeschlagener Test verhindert die Übernahme.
Wird ein Fehler gefunden, schreibt man zuerst einen Test, der ihn nachweist. Nach der Korrektur bleibt dieser Test dauerhaft in der Regressionstestsuite, damit der Fehler nie unbemerkt zurückkehrt.
Ist die Suite zu groß, um immer alles auszuführen, wählt man risikobasiert aus: Tests der geänderten Komponenten und ihrer Nachbarn sowie der geschäftskritischen Funktionen bei jeder Änderung, die vollständige Suite z. B. nächtlich und vor jedem Release.
Manuelle Regressionstests (z. B. über die Oberfläche) sind teuer; hier helfen Checklisten mit den wichtigsten Abläufen und schrittweise Automatisierung.
Das Testkonzept: Testen mit Plan
Ein Testkonzept (Testplan) legt vor Beginn der Tests fest, wie in einem Projekt getestet wird. Es macht das Testen planbar, überprüfbar und für Auftraggebende nachvollziehbar. Inhalt und Aufbau beschreibt die Norm ISO/IEC/IEEE 29119-3 (früher IEEE 829). Typische Inhalte:
| Inhalt | Beschreibung |
|---|---|
| Testobjekte und Umfang | Was wird getestet (Komponenten, Schnittstellen, Version), was ausdrücklich nicht? |
| Testziele und Teststrategie | Welche Qualitätsmerkmale sind besonders wichtig (z. B. Datenschutz, Verfügbarkeit)? Welche Teststufen, Testarten und Testverfahren (Blackbox/Whitebox, angestrebte Überdeckung) werden eingesetzt, was wird automatisiert? Wie spielen die Teststufen zusammen? |
| Testumgebung | Hardware, Betriebssysteme, Endgeräte, Datenbanken, Testserver, Werkzeuge; möglichst nah an der Produktionsumgebung und standardisiert |
| Testdaten | Herkunft und Umfang; synthetisch oder anonymisiert statt echter personenbezogener Daten (DSGVO) |
| Rollen und Verantwortlichkeiten, Testplan | Wer testet was, wann und in welchem Umfang? Zeitplan, Abhängigkeiten zu Entwicklung und Releases, Einbindung in die Projektplanung (z. B. Definition of Done im Sprint) |
| Ein- und Endekriterien | Wann darf eine Teststufe beginnen, wann ist genug getestet? Beispiel: alle Testfälle mit hoher Priorität bestanden, keine offenen kritischen Fehler, mindestens 80 % Zweigüberdeckung |
| Fehlermanagement | Wie werden Fehler gemeldet, klassifiziert (z. B. kritisch, schwer, leicht) und bis zur Behebung verfolgt (Ticketsystem)? |
| Testdokumentation | Vorlagen für Testfallspezifikation, Testprotokoll und Testbericht; Umfang der Dokumentation |
| Auswertung | Wie werden Testergebnisse ausgewertet und bewertet, an wen wird berichtet, welche Kennzahlen werden verwendet? |
| Aufwand, Kosten, Risiken | Schätzung von Testaufwand und -kosten, Aktualisierung im Projektverlauf; Risiken für das Testen (z. B. fehlende Testgeräte) |
Meist genügt es, einige Inhalte zu beschreiben – also nicht nur „Testumgebung“ zu schreiben, sondern kurz zu sagen, was dazu festgelegt wird und warum.
Ist das genug? Zu einem QS-Vorschlag Stellung nehmen
In Projekten kommen oft Vorschläge wie „Wir haben 100 % Anweisungsüberdeckung, wir sind fertig“ oder „Ein Abnahmetest reicht, die Kundschaft merkt schon, wenn etwas nicht stimmt“. Wird verlangt, dazu Stellung zu nehmen, erwartet man eine begründete Bewertung:
Position beziehen: Stimmst Du zu, teilweise zu oder nicht zu?
Fachlich begründen: Was leistet der Vorschlag (Stärken), was deckt er nicht ab (Lücken)? Ordne ihn dabei ein: konstruktiv/analytisch, statisch/dynamisch, Teststufe, Blackbox/Whitebox.
Folgerung oder Alternative: Was sollte ergänzt werden?
Beispiel zum ersten Vorschlag: „Ich stimme nicht zu. 100 % Anweisungsüberdeckung zeigt nur, dass jede Anweisung einmal ausgeführt wurde. Sie sagt nichts darüber, ob alle Zweige (z. B. der leere else-Zweig) geprüft wurden, und schon gar nicht, ob Funktionen fehlen, die in den Anforderungen stehen. Außerdem testet ein Komponententest nicht das Zusammenspiel mit Datenbank und Oberfläche. Ich schlage vor, zusätzlich Blackbox-Testfälle aus den Anforderungen sowie Integrations- und Systemtests einzuplanen und als Endekriterium Zweigüberdeckung festzulegen.“
Hilfreich ist dabei ein Grundsatz des Testens: Testen zeigt die Anwesenheit von Fehlern, nicht ihre Abwesenheit. Kein einzelnes Verfahren findet alle Fehlerarten – eine gute Teststrategie kombiniert deshalb konstruktive Maßnahmen, Reviews, statische Analyse und Tests auf mehreren Stufen.
Leitfragen
- Worin unterscheiden sich konstruktive und analytische Qualitätssicherung? Nenne je drei Beispiele.
Konstruktive Maßnahmen sollen Fehler von vornherein vermeiden und wirken auf den Entstehungsprozess, z. B. prüfbare Anforderungen, Programmierrichtlinien und bewährte Werkzeuge wie Versionsverwaltung und CI/CD-Pipeline. Analytische Maßnahmen finden vorhandene Fehler in einem Arbeitsergebnis, z. B. Reviews, statische Codeanalyse und dynamische Tests auf allen Teststufen; siehe Abschnitt „Fehler vermeiden oder Fehler finden? Die Maßnahmen im Überblick“.
- Welche Fehler finden Reviews, welche statische Codeanalyse und welche dynamischen Tests? Warum ersetzt keines die anderen?
Reviews finden Unklarheiten, widersprüchliche oder fehlende Anforderungen, Denkfehler und Richtlinienverstöße, auch bevor Code existiert. Statische Codeanalyse findet automatisch Stilverstöße, toten Code, typische Fehlermuster und bekannte Sicherheitsmuster, kennt aber die Anforderungen nicht. Dynamische Tests finden Fehler im Verhalten des ausgeführten Programms. Weil jedes Verfahren andere Fehlerarten findet, kombiniert eine gute Teststrategie alle; siehe Abschnitt „Prüfen ohne Ausführen: Reviews und statische Codeanalyse“ und Abschnitt „Ist das genug? Zu einem QS-Vorschlag Stellung nehmen“.
- Was zeichnet einen Blackbox-Test, was einen Whitebox-Test aus? Nenne je zwei Vor- und Nachteile.
Beim Blackbox-Test ist der Code unbekannt, die Testfälle kommen aus der Spezifikation: Er kann vor der Implementierung entstehen und findet fehlende Funktionen, hängt aber stark von der Testdatenauswahl ab und lokalisiert Fehler schlecht. Beim Whitebox-Test werden die Testfälle anhand der Code-Struktur gewählt: Er lokalisiert Fehler genauer und macht die Testabdeckung messbar, erfordert aber offenen Quelltext und findet keine fehlenden Funktionen; siehe Abschnitt „Blackbox-Test: gegen die Spezifikation“ und Abschnitt „Whitebox-Test: gegen die Struktur des Codes“.
- Welche Teststufen gibt es, und gegen welches Entwurfsdokument prüft jede Stufe im V-Modell?
Der Komponententest prüft gegen den Komponentenentwurf, der Integrationstest gegen den technischen Systementwurf (Architektur, Schnittstellen), der Systemtest gegen den funktionalen Systementwurf (Pflichtenheft) und der Abnahmetest gegen die Anforderungen der Auftraggebenden (Lastenheft, Akzeptanzkriterien); siehe Abschnitt „Teststufen und das V-Modell“.
- Wozu dienen Regressionstests, und wie unterscheiden sie sich vom Fehlernachtest?
Ein Regressionstest wiederholt nach jeder Änderung Testfälle, die vorher schon bestanden wurden, am besten automatisiert. Er deckt Seiteneffekte auf: Funktionen, die vorher liefen und durch die Änderung jetzt versagen. Der Fehlernachtest prüft dagegen nur, ob der gemeldete Fehler wirklich behoben ist; siehe Abschnitt „Regressionstests: Damit Bewährtes nicht kaputtgeht“.
- Welche Inhalte gehören in ein Testkonzept?
Ein Testkonzept legt Testobjekte und Umfang, Testziele und Teststrategie, Testumgebung, Testdaten, Rollen und Zeitplan, Ein- und Endekriterien, Fehlermanagement, Testdokumentation, Auswertung sowie Aufwand, Kosten und Risiken fest. In einer Aufgabe beschreibst Du jeweils kurz, was dazu festgelegt wird und warum; siehe Abschnitt „Das Testkonzept: Testen mit Plan“.
- Wie gehst Du vor, wenn Du zu einem Vorschlag für die Qualitätssicherung Stellung nehmen sollst?
Du beziehst zuerst Position (Zustimmung, teilweise oder keine), begründest dann fachlich Stärken und Lücken des Vorschlags, indem Du ihn einordnest (konstruktiv/analytisch, statisch/dynamisch, Teststufe, Blackbox/Whitebox), und ziehst eine Folgerung oder schlägst Ergänzungen vor; siehe Abschnitt „Ist das genug? Zu einem QS-Vorschlag Stellung nehmen“.
- Was ist ein User Acceptance Test, und was muss vor seinem Start erfüllt sein?
Im User Acceptance Test prüfen künftige Nutzende bzw. die Fachabteilung unter realen Bedingungen, ob die Software für ihre Arbeit taugt und die Akzeptanzkriterien erfüllt (Validierung). Vorher müssen die Anwendung funktional vollständig, System- und Regressionstests abgeschlossen und schwere Fehler behoben sein; eine realitätsnahe UAT-Umgebung, vereinbarte Akzeptanzkriterien und vorbereitete Testpersonen müssen bereitstehen; siehe Abschnitt „Abnahmetest als User Acceptance Test (UAT)“.
Links und weitere Informationen
Blackbox-Testfälle erstellen: Äquivalenzklassen und Grenzwerte
ISTQB/GTB: Lehrplan Certified Tester Foundation Level 4.0 (deutsch)
für den Einstieg: Andreas Spillner, Tilo Linz: Basiswissen Softwaretest, dpunkt.verlag (aktuelle Auflage, orientiert am ISTQB-Lehrplan)
als Nachschlagewerk: ISO/IEC/IEEE 29119-3: Testdokumentation (Normübersicht)
Hinweis zur Nachnutzung als Open Educational Resource (OER)
Dieser Artikel und seine Texte, Bilder, Grafiken, Code und sonstiger Inhalt sind - sofern nicht anders angegeben - lizenziert unter CC BY 4.0. Nennung gemäß TULLU-Regel bitte wie folgt: “Teststrategie und Qualitätssicherung: Wie Software gut wird und gut bleibt” von oer-informatik.de (H. Stein), Lizenz: CC BY 4.0. Der Artikel wurde unter https://oer-informatik.de/teststrategie veröffentlicht, die Quelltexte sind in weiterverarbeitbarer Form verfügbar im Repository unter https://gitlab.com/oer-informatik/qs/testen. Erstellt mit KI-Assistenz; von mir umfassend redaktionell überarbeitet, geprüft und freigegeben. Stand: 28.10.2026.
[Kommentare zum Artikel lesen, schreiben] / [Artikel teilen] / [gitlab-Issue zum Artikel schreiben]