Übungsaufgaben zu Werkzeugen der Softwareentwicklung
https://bildung.social/@oerinformatik/
https://oer-informatik.de/entwicklungswerkzeuge-uebungsaufgaben
Softwareentwicklung, Compiler, Interpreter, Debugger, Git, Open-Source-Lizenzen, Javadoc, Semantic Versioning, CI/CD, Übungsaufgaben, Prüfungsvorbereitung
tl/dr; (Bearbeitungszeit insgesamt 100 min, mehrere Aufgaben): Drei Übungsaufgaben zu Compilern und Interpretern, Bibliotheken und ihrer Dokumentation, Versionsverwaltung, CI/CD-Pipelines und Open-Source-Lizenzen – mit Zuordnungen und Abwägungen, einem fehlerhaften Git-Spickzettel, einem zu ergänzenden Javadoc-Kommentar, einer Lizenztabelle, einem Bibliotheksvergleich und einem Pipeline-Entwurf zum Korrigieren; dazu die Fehlersuche mit dem Debugger in einem Altersfilter, einschließlich bedingter Haltepunkte, Risiken des Remote-Debuggings und Grenzfall-Tests. Alle Lösungen sind ausgeblendet und mit Punkteverteilung versehen [AI-Assisted]. (Zuletzt geändert am 28.10.2026)
Diese Übungsaufgaben gehören zum Artikel Werkzeuge der Softwareentwicklung: Compiler, Debugger, Bibliotheken, Versionsverwaltung, CI/CD und Open Source. Verwandte Artikel: Git: Repository anlegen und lokal committen, Build-Tool Maven.

Hinweise zur Bearbeitung: Als FIA, FIDV oder IKD musst Du zur Teil-2-Prüfung Aufgaben auf Kernkompetenz-Ebene lösen können, das sind Aufgabe 2.1 und Aufgabe 2.2. Von IKD wird zusätzlich erwartet, dass ihnen Aufgaben auf Profilkompetenz-Ebene (Aufgabe 3.1) keine Probleme bereiten. Bei „nennen“ genügen Stichworte, bei „beschreiben“, „erläutern“, „begründen“ und „Stellung nehmen“ erwartet die Aufgabe ganze Sätze mit Bezug zur Situation. Werden zwei Angaben verlangt, werden auch nur die ersten zwei bewertet. Schreib Deine Lösung zuerst vollständig auf, bevor Du die Beispiellösung aufklappst; andere sachlich richtige Antworten sind ebenfalls richtig.
Du möchtest eigene Aufgaben zum Üben von einem KI-Sprachmodell generieren lassen?
Kopiere den Text in ein KI-Sprachmodell Deiner Wahl und passe Kompetenzstufe, Anzahl, Bearbeitungszeit und Szenario bei Bedarf an. Wie die Aufgaben aufgebaut sind, beschreibt der Artikel Wie sind die Aufgaben aufgebaut?. Prüfe die Ergebnisse mit dem Lehrartikel: KI-Sprachmodelle machen Fehler.
Erstelle neue Übungsaufgaben zum Thema „Werkzeuge der
Softwareentwicklung“.

Bauplan: Halte Dich an Aufbau, Kompetenzstufen, Operatoren,
Anforderungsbereiche, Punkte und Zeitschätzung, die im Artikel
https://oer-informatik.de/aufgaben-aufbau beschrieben sind.

Fachliche Grundlage:
- https://oer-informatik.de/entwicklungswerkzeuge
- https://oer-informatik.de/git01-repo_anlegen_und_lokal_commiten
- https://oer-informatik.de/build-tool-maven
- Stilbeispiel: https://oer-informatik.de/entwicklungswerkzeuge-uebungsaufgaben

Die Aufgaben sollen Inhalte zu diesen Schlagwörtern abdecken:
- Softwareentwicklung
- Compiler
- Interpreter
- Debugger
- Git
- Open-Source-Lizenzen
- Javadoc
- Semantic Versioning
- CI/CD

Kompetenzstufe: Kernkompetenz (alternativ: Basiskompetenz, Profilkompetenz, Expertise)
Anzahl: 1 Aufgabe mit Teilaufgaben
Bearbeitungszeit in Minuten ca.: <5 bis 30 min>
Szenario: eines der Szenarien aus dem Bauplan

Vorgehen:
1. Lies zuerst die verlinkten Artikel. Kannst Du keine Webseiten
   abrufen, sag mir das, statt zu raten.
2. Steht bei einer Angabe noch ein Platzhalter in <…>, frag mich
   zuerst danach. Richte Punkte und Zahl der Teilaufgaben nach der
   Bearbeitungszeit (ca. 0,9 min je Punkt).
3. Gib je Aufgabe Titel mit Kompetenzstufe, Ausgangssituation und
   Teilaufgaben mit Operator und Punktzahl aus, dazu die geschätzte
   Bearbeitungszeit.
4. Gib die Beispiellösungen mit Punkteverteilung erst aus, wenn ich
   danach frage.
Aufgabe 2.1: Software, Türschilder und Lizenzen für ein Barcamp (Kernkompetenz)
(ca. 39 min Bearbeitungszeit)
Das Ratz und Rübe Berufskolleg (RRB) in Bielefeld veranstaltet am 13.03.2027 das Barcamp „Lernen.Digital.Leben 2027“. Die Software dafür entwickelt ein Team aus sieben Schüler*innen, betreut von Informatiklehrer Dimitrios Papadopoulos. Du arbeitest als Auszubildende*r der Fachinformatik für Anwendungsentwicklung mit, zusammen mit Mia Schröder (FIA, 3. Lehrjahr), Hannah Klein (FIA) und Emre Aksoy (FISY, Leitung Technikteam).
Zur Software gehören der Info-Server (in Java geschrieben; er versorgt Infomonitore und E-Ink-Türschilder per MQTT mit dem Sessionplan), die Barcamp-Web-App für Sessionplan und Buchungen sowie die Firmware der zwölf E-Ink-Türschilder (Mikrocontroller ESP32 mit Akku). Bisher legt jede*r den eigenen Stand als ZIP-Datei in einem gemeinsamen Cloud-Ordner ab. Nach dem Barcamp möchte Schulleiterin Petra Schulze-Albers die Software anderen Schulen zur Verfügung stellen.
a) Emre hat den ersten Prototyp der Türschild-Firmware in MicroPython geschrieben: Auf dem ESP32 läuft ein MicroPython-Interpreter, der die .py-Dateien direkt ausführt. Svenja Krämer von der Schul-IT möchte die Firmware lieber in C++ schreiben und auf dem Laptop für den ESP32 übersetzen lassen, weil die Akkus der Türschilder den ganzen Barcamp-Tag halten müssen. Emre hält dagegen, dass er mit MicroPython jede Änderung in Sekunden auf dem Schild sieht.
aa) In der Diskussion fallen die folgenden Sätze. Entscheide für jeden Satz, ob er auf die interpretierte MicroPython-Firmware, auf die kompilierte C++-Firmware oder auf beide zutrifft. (3 Punkte)
| Nr. | Satz aus der Diskussion | trifft zu auf … |
|---|---|---|
| 1 | „Nach einer Änderung kopiere ich nur die geänderte Datei aufs Schild und sehe das Ergebnis sofort.“ | |
| 2 | „Auf dem Schild liegt am Ende nur Maschinencode, das Übersetzungsprogramm bleibt auf dem Laptop.“ | |
| 3 | „Ein vertippter Variablenname fällt erst auf, wenn das Schild genau diese Zeile erreicht.“ | |
| 4 | „Kaufen wir später Schilder mit einem anderen Prozessor, muss das Programm für diesen neu übersetzt werden.“ | |
| 5 | „Ein Teil des Flash-Speichers ist dauerhaft vom Übersetzungsprogramm belegt.“ | |
| 6 | „Bevor der Prozessor etwas tun kann, muss der Quelltext in Befehle übersetzt werden, die er versteht.“ |
Je Satz 0,5 Punkte:
| Nr. | trifft zu auf … | Begründung |
|---|---|---|
| 1 | interpretiert (MicroPython) | Es gibt keinen Übersetzungsschritt vor dem Start; der Interpreter liest beim nächsten Lauf einfach die neue Datei. |
| 2 | kompiliert (C++) | Der Compiler läuft auf dem Entwicklungsrechner und übersetzt das ganze Programm vorab; aufs Gerät kommt nur das fertige Programm. |
| 3 | interpretiert (MicroPython) | Python löst Namen erst zur Laufzeit auf. Ein C++-Compiler bricht bei einem unbekannten Bezeichner schon beim Übersetzen ab. |
| 4 | kompiliert (C++) | Maschinencode ist an den Befehlssatz eines Prozessors gebunden. MicroPython-Quelltext läuft auf jedem Prozessor, für den es den Interpreter gibt. |
| 5 | interpretiert (MicroPython) | Der Interpreter muss auf dem Zielsystem vorhanden sein und belegt dort Speicher. |
| 6 | beide | Übersetzt wird immer; der Unterschied liegt im Zeitpunkt: Der Compiler übersetzt einmal vorab das ganze Programm, der Interpreter bei jeder Ausführung Anweisung für Anweisung zur Laufzeit. |
ab) Mia sagt: „Der Info-Server ist in Java geschrieben. Java ist eine Compilersprache, also kopieren wir das kompilierte Programm einfach auf den Server und brauchen dort nichts weiter zu installieren.“
Nimm zu Mias Aussage Stellung. (3 Punkte)
Die Aussage stimmt nur teilweise (1 Punkt für die begründete Bewertung, 2 Punkte für die Erläuterung):
Java wird zwar kompiliert, aber nicht in Maschinencode, sondern in plattformunabhängigen Bytecode (.class-Dateien, zusammengefasst in einer .jar-Datei). Diesen Bytecode führt zur Laufzeit die Java Virtual Machine aus, die ihn interpretiert bzw. per Just-in-time-Compiler in Maschinencode übersetzt. Auf dem Info-Server muss deshalb eine passende Java-Laufzeitumgebung (JRE/JDK in mindestens der Version, für die kompiliert wurde) installiert sein – oder sie wird mit dem Programm zusammen ausgeliefert (z. B. in einem Container-Image). Dafür läuft dieselbe .jar-Datei auf jedem Betriebssystem mit JVM.
ac) Das Team will sich bis Ende Januar festlegen. Triff eine begründete Entscheidung für die Firmware der Türschilder: Wäge dabei Svenjas und Emres Argument gegeneinander ab und ziehe mindestens ein weiteres Kriterium heran, das in der Diskussion bisher fehlt. (5 Punkte)
Je 1 Punkt für die Einordnung von Svenjas und Emres Argument, 2 Punkte für ein weiteres Kriterium mit Bezug zur Situation, 1 Punkt für eine Entscheidung, die schlüssig aus der Abwägung folgt. Eine mögliche Lösung:
Svenjas Argument (Energie): Kompilierter C++-Code erledigt dieselbe Arbeit mit weniger Rechenzeit, weil zur Laufzeit nicht mehr übersetzt wird. Bei einem E-Ink-Schild fällt das aber weniger ins Gewicht, als es scheint: Das Display braucht nur beim Umschalten Strom, und der Mikrocontroller kann zwischen zwei Aktualisierungen des Sessionplans im Tiefschlaf liegen. Entscheidend für die Akkulaufzeit ist also vor allem, wie oft und wie lange das Schild wach ist.
Emres Argument (Entwicklungstempo): Ohne Übersetzungs- und Flash-Vorgang lassen sich Änderungen sofort ausprobieren. Bis zum 13.03.2027 bleibt wenig Zeit, und der Prototyp läuft bereits – ein Neuschreiben kostet Wochen.
Weiteres Kriterium, zum Beispiel: Kenntnisse im Team (die Schüler*innen können Python, C++ müssten sie erst lernen; das erhöht das Fehlerrisiko kurz vor dem Barcamp), Speicher des ESP32 (der Interpreter belegt einen Teil von Flash und RAM), verfügbare Bibliotheken für E-Paper-Displays und MQTT oder Wartbarkeit für die anderen Schulen, die die Firmware später übernehmen sollen.
Entscheidung, zum Beispiel: Für das Barcamp bleibt es bei MicroPython. Die Energiefrage wird durch Tiefschlaf zwischen den Aktualisierungen gelöst und vorher mit einem Dauertest eines Schilds über zehn Stunden überprüft. Reicht der Akku dann nicht, wird der zeitkritische Teil später in C++ umgesetzt. Eine gut begründete Entscheidung für C++ (z. B. weil der Dauertest scheitert oder der Speicher knapp wird) ist ebenfalls richtig.
b) Bei einer Teambesprechung stellt Mia den Vorschlag vor, ab sofort mit der Versionsverwaltung Git und einem Repository auf dem GitLab-Server der Schul-IT OWL zu arbeiten.
ba) Hannah widerspricht: „Wir sind nur sieben Leute. Git ist viel zu kompliziert. Wir laden weiter ZIP-Dateien mit Datum in den Cloud-Ordner und sagen im Gruppenchat, wer gerade an welcher Datei arbeitet.“
Hannah hat recht, dass Git eine Einarbeitung kostet. Schildere zwei Situationen, die im Barcamp-Projekt mit dem ZIP-Verfahren schiefgehen können, und zeige jeweils, wie Git sie verhindert oder auffängt. Schließe mit einer Empfehlung an Hannah, die ihren Einwand „zu kompliziert“ ernst nimmt. (5 Punkte)
Je Situation 1 Punkt für die Schilderung und 1 Punkt für die Lösung mit Git, 1 Punkt für die Empfehlung, zum Beispiel:
Verlorene Arbeit: Emre und eine Schülerin ändern am selben Vormittag die Klasse, die im Info-Server die MQTT-Nachrichten für die Türschilder zusammenstellt. Wer sein ZIP später hochlädt, überschreibt still die Änderungen der anderen – die Chat-Absprache wurde im Trubel übersehen. Mit Git committen beide ihre Änderungen; beim Zusammenführen vereint Git Änderungen an verschiedenen Stellen automatisch und meldet einen Konflikt, wenn dieselbe Stelle betroffen ist. Verloren geht nichts.
Kein Weg zurück: Am Abend vor dem Barcamp stürzt die Buchung in der Web-App ab. Welches der vielen ZIP-Dateien der letzte funktionierende Stand war und was sich seitdem geändert hat, weiß niemand genau. Mit Git ist jede Änderung ein Commit mit Autor*in, Zeitpunkt und Nachricht;
git logundgit diffzeigen, was sich geändert hat, und mitgit revertoder dem Auschecken des letzten markierten Stands läuft die Web-App in wenigen Minuten wieder.Weitere Situationen: Experimente gefährden die lauffähige Version (mit Git: eigener Branch); niemand weiß, welcher Stand auf welchem Türschild läuft (mit Git: Tag bzw. Commit-Kennung im Build).
Empfehlung: Git einführen, aber bewusst einfach halten: eine halbstündige Einführung, nur wenige Befehle (
clone,pull,add,commit,push) oder die Git-Unterstützung der IDE bzw. die Weboberfläche von GitLab, je Aufgabe ein Branch und Zusammenführen über Merge Requests. Dieser Aufwand ist kleiner als eine Nacht, in der verlorene Änderungen rekonstruiert werden müssen.
bb) Mia hat für das Team einen Spickzettel zu Git geschrieben. Einige Aussagen sind fachlich falsch.
| Nr. | Aussage auf Mias Spickzettel |
|---|---|
| 1 | Ein Commit speichert einen Schnappschuss des Projekts mit Nachricht, Autor*in und Zeitpunkt in der Projektgeschichte. |
| 2 | Nach git commit sind Deine Änderungen sofort für alle im Team auf dem GitLab-Server sichtbar. |
| 3 | Für jede neue Funktion legst Du einen eigenen Branch an, damit der Hauptzweig main lauffähig bleibt. |
| 4 | Haben zwei Personen dieselbe Zeile geändert, übernimmt Git beim Merge automatisch die Version, die zuletzt gepusht wurde. |
| 5 | Die Datei mqtt.properties mit dem Passwort für den MQTT-Broker committen wir mit, damit alle sie haben. |
| 6 | Die Version, die am Barcamp-Tag läuft, markieren wir mit einem Tag, z. B. v1.0.0. |
Gib die Nummern der drei falschen Aussagen an und korrigiere sie. (6 Punkte)
Je falscher Aussage 1 Punkt für das Erkennen und 1 Punkt für die Korrektur:
Aussage 2 ist falsch:
git commitspeichert die Änderungen nur im lokalen Repository. Erst mitgit pushwerden sie auf den GitLab-Server übertragen; die anderen holen sie mitgit pull.Aussage 4 ist falsch: Git überschreibt bei einem Merge-Konflikt nichts automatisch. Es meldet den Konflikt, markiert die betroffenen Stellen in der Datei, und eine Person entscheidet, welche Fassung (oder welche Kombination) gilt; danach wird der aufgelöste Stand committet.
Aussage 5 ist falsch: Zugangsdaten gehören nicht ins Repository, weil sie dort für alle mit Lesezugriff – und in der Historie dauerhaft, auch nach dem Löschen – sichtbar sind; nach der geplanten Veröffentlichung sogar weltweit. Die Datei wird über
.gitignoreausgeschlossen; ins Repository kommt nur eine Vorlage ohne Passwort (z. B.mqtt.properties.example), das Passwort wird lokal bzw. als geschützte Variable der CI-Pipeline hinterlegt.
Aussagen 1, 3 und 6 sind richtig.
c) Für die Barcamp-Software setzt das Team mehrere fremde Komponenten ein. Nach dem Barcamp soll die Software unter der MIT-Lizenz auf GitLab veröffentlicht werden, damit andere Schulen sie frei nutzen und anpassen können.
ca) Hannah hat die verwendeten Komponenten zusammengestellt.
| Komponente | Verwendung | Angabe zur Lizenz | Open Source? | Was bedeutet das für die Veröffentlichung unter MIT? |
|---|---|---|---|---|
qrbadge |
QR-Codes auf den Badges (Web-App) | MIT | ||
epaper-ui |
Textdarstellung auf dem E-Paper (Firmware), unverändert genutzt | LGPL-3.0 | ||
zertifikat-pdf |
Teilnahmebescheinigungen als PDF (Web-App auf dem Schulserver) | AGPL-3.0 | ||
stream-overlay |
Bauchbinden im Livestream, Code von einer privaten Seite kopiert | Quelltext öffentlich lesbar, keine Lizenzangabe |
Ergänze die Tabelle. (8 Punkte)
Je Zeile 0,5 Punkte für die Spalte „Open Source?“ und 1,5 Punkte für die Folgen, zum Beispiel:
| Komponente | Open Source? | Was bedeutet das für die Veröffentlichung unter MIT? |
|---|---|---|
qrbadge |
ja (freizügige Lizenz) | Darf genutzt und mit veröffentlicht werden; Lizenztext und Copyright-Hinweis von qrbadge müssen erhalten bleiben (z. B. in einer Datei mit Drittanbieter-Lizenzen). |
epaper-ui |
ja (schwaches Copyleft) | Darf genutzt werden, die Firmware selbst darf unter MIT stehen. epaper-ui bleibt unter LGPL und muss mit Lizenztext und Quelle angegeben werden; Änderungen an epaper-ui selbst müssten unter LGPL offengelegt werden, und Empfänger*innen müssen die Bibliothek austauschen können. |
zertifikat-pdf |
ja (starkes Netzwerk-Copyleft) | Wer die Web-App mit dieser Bibliothek weitergibt oder als Netzwerkdienst anbietet, muss den gesamten abgeleiteten Code unter AGPL-3.0 veröffentlichen. Eine Veröffentlichung der Web-App unter MIT ist damit nicht möglich: Entweder Bibliothek ersetzen (z. B. durch eine unter MIT/Apache-2.0) oder die Web-App unter AGPL veröffentlichen. |
stream-overlay |
nein (nur lesbar, keine Lizenz) | Ohne Lizenz gilt das Urheberrecht: Es gibt kein Recht, den Code zu nutzen oder weiterzugeben. Nicht verwenden bzw. entfernen, oder die Urheber*in um eine Lizenz (z. B. MIT) bitten. |
cb) Petra Schulze-Albers wirft einen Blick auf die Tabelle und sagt: „Ich dachte, Open Source heißt einfach, dass man den Quelltext lesen kann. Dann wäre ja alles erlaubt.“
Erkläre ihr anhand von zwei Zeilen der Tabelle, warum beide Teile ihrer Aussage nicht stimmen. (4 Punkte)
Je Teil der Aussage 2 Punkte (1 Punkt für das passende Beispiel aus der Tabelle, 1 Punkt für die Erklärung):
„Open Source heißt, man kann den Quelltext lesen“ – stimmt nicht. Bei
stream-overlayist der Quelltext öffentlich lesbar, eine Lizenz fehlt aber. Dann gilt allein das Urheberrecht, und das Team darf den Code weder nutzen noch weitergeben. Open Source ist Software erst, wenn ihre Lizenz allen erlaubt, sie zu nutzen, zu untersuchen, zu verändern und – auch verändert – weiterzugeben, ohne Lizenzgebühren und ohne bestimmte Personen oder Einsatzzwecke auszuschließen (so legt es die Open Source Definition der Open Source Initiative fest).„Dann ist alles erlaubt“ – stimmt auch nicht.
zertifikat-pdfsteht unter einer anerkannten Open-Source-Lizenz, der AGPL-3.0. Trotzdem stellt sie Bedingungen: Wer die Web-App damit weitergibt oder als Netzwerkdienst anbietet, muss den gesamten Code unter AGPL offenlegen – das verträgt sich nicht mit der geplanten MIT-Veröffentlichung. Selbst die freizügige MIT-Lizenz vonqrbadgeverlangt, dass Lizenztext und Copyright-Hinweis erhalten bleiben. Open-Source-Lizenzen räumen also Rechte unter Bedingungen ein.
cc) Für die Anbindung des Info-Servers an den MQTT-Broker stehen zwei Java-Bibliotheken zur Wahl, beide unter der Lizenz Apache-2.0:
| Merkmal | mqtt-mini |
brokerlink |
|---|---|---|
| Entwicklung | eine Privatperson | Projekt einer Stiftung, rund 40 Mitwirkende |
| letzte Version | 0.9.2 vom Mai 2022 | 4.1.0 vom September 2026, etwa monatlich neue Versionen |
| gemeldete Sicherheitslücken | eine Meldung von 2023, bis heute unbeantwortet | zwei Meldungen im Jahr 2026, jeweils nach wenigen Tagen behoben |
| Größe | 60 KB, keine weiteren Abhängigkeiten | 1,4 MB, bringt drei weitere Bibliotheken mit |
| Dokumentation | kurze README-Datei | Handbuch mit Beispielen |
Emre findet mqtt-mini sympathisch, weil sie „klein und übersichtlich“ ist. Entscheide begründet, welche Bibliothek das Team einsetzen sollte. Leite aus dem Vergleich außerdem drei Prüffragen ab, die das Team vor der Aufnahme jeder neuen Open-Source-Bibliothek klären sollte. (5 Punkte)
2 Punkte für die begründete Entscheidung, je 1 Punkt für eine Prüffrage, zum Beispiel:
Entscheidung:
brokerlink. Beimqtt-miniist seit Jahren keine neue Version erschienen, und eine gemeldete Sicherheitslücke bleibt unbeantwortet – findet jemand einen Fehler, behebt ihn niemand, und das Team müsste den fremden Code selbst pflegen.brokerlinkwird aktiv gepflegt, Lücken werden schnell geschlossen, und die Dokumentation erleichtert auch den Schulen, die die Software später übernehmen, den Einstieg. Emres Argument zählt auf dem Info-Server wenig: Dort spielen 1,4 MB keine Rolle (anders als auf dem ESP32). Die drei mitgebrachten Bibliotheken müssen allerdings ebenfalls geprüft werden.Prüffragen, zum Beispiel:
- Wird das Projekt aktiv gepflegt (Datum der letzten Version, Zahl der Mitwirkenden, Reaktion auf Fehlermeldungen)?
- Gibt es offene bekannte Sicherheitslücken (CVE-Einträge), und wie schnell wurden frühere behoben?
- Passt die Lizenz zur geplanten Veröffentlichung unter MIT?
- Welche weiteren Abhängigkeiten bringt die Bibliothek mit, und bestehen diese dieselbe Prüfung?
- Reicht die Dokumentation, und wie verbreitet ist die Bibliothek (Hilfe bei Problemen)?
cd) Die Check-in-Terminals laufen bisher mit der proprietären Check-in-Software „BadgeDesk“. Emre schlägt vor, sie durch ein Open-Source-Programm zu ersetzen.
Nenne jeweils zwei Vorteile von Open-Source-Software und von proprietärer Software für diesen Einsatz. (4 Punkte)
Je 1 Punkt, zum Beispiel:
Open-Source-Software: keine Lizenzkosten (wichtig für eine Schulveranstaltung mit knappem Budget); der offene Quelltext lässt sich selbst prüfen, und Verbesserungen anderer Schulen fließen zurück; kann an die eigenen Badges angepasst werden; keine Abhängigkeit vom Hersteller; andere Schulen können sie ebenfalls frei nutzen.
Proprietäre Software: vertraglich zugesicherter Support (am Samstag darf nichts ausfallen); Gewährleistung und Haftung des Herstellers; ggf. bessere Zusammenarbeit mit weiterer Software und Hardware des Herstellers (z. B. Badge-Drucker); planbare Weiterentwicklung und Sicherheitsupdates durch ein Unternehmen.
Aufgabe 2.2: Shop-Backend automatisch bauen und ausliefern (Kernkompetenz)
(ca. 30 min Bearbeitungszeit)
Die CSB-Rad GmbH in Bielefeld betreibt einen Onlineshop für Fahrräder und Komponenten. Du bist Auszubildende*r der Fachinformatik für Anwendungsentwicklung im dreiköpfigen Entwicklungsteam von Geschäftsführer Cem Sarıkaya (Technik und IT). Das Shop-Backend ist in Java geschrieben und wird mit Maven gebaut.
Bisher baut Cem jeden zweiten Freitagabend das Backend auf seinem Laptop, kopiert die erzeugte .jar-Datei per SSH auf den Shop-Server und startet den Dienst neu. Das ging zweimal schief: Am 12.09.2026 war der Shop drei Stunden nicht erreichbar, weil die neue Version mit Java 21 übersetzt war, auf dem Server aber noch Java 17 lief. Am 26.09.2026 ging eine ungetestete Änderung der Versandkostenberechnung live, und einige Kund*innen zahlten keine Versandkosten.
Außerdem pflegt das Team die interne Bibliothek csb-partner-client (aktuelle Version 2.3.1). Sie kapselt die Schnittstellen zu den Fertigungspartnern – die REST-API der Lipper SchließTec KG und die OPC-UA-Anbindung der Rahmenwerk OWL GmbH – und wird vom Shop-Backend und vom neuen Werkstattportal genutzt.
a) Zuerst geht es um Bibliotheken.
aa) Ab dem 01.01.2027 muss CSB-Rad seinen Geschäftskunden E-Rechnungen ausstellen. Natalia Wróbel aus der Buchhaltung möchte ZUGFeRD- und XRechnung-Dateien direkt aus dem Shop erzeugen. Statt das Format selbst zu programmieren, schlägt Cem die Open-Source-Bibliothek „erechnung-kit“ (Lizenz Apache-2.0) vor.
Natalia ist skeptisch: „Und wenn die Leute hinter dieser Bibliothek in zwei Jahren aufhören? Dann stehen wir mit unseren Rechnungen allein da.“
Wäge Cems Vorschlag gegen eine eigene Umsetzung der Rechnungsformate ab, gehe dabei auf Natalias Einwand ein und gib eine Empfehlung. (5 Punkte)
2 Punkte für Argumente zugunsten der Bibliothek, 2 Punkte für die Bewertung von Natalias Einwand samt Gegenmaßnahme, 1 Punkt für eine schlüssige Empfehlung, zum Beispiel:
Für die Bibliothek: Die Formate sind umfangreich (XML nach festgelegten Schemata und Prüfregeln, bei ZUGFeRD zusätzlich ein PDF mit eingebetteter XML-Datei). Eine Eigenentwicklung bis zum 01.01.2027 wäre für ein dreiköpfiges Team knapp und fehleranfällig. Eine verbreitete Bibliothek ist von vielen Nutzenden erprobt, und neue Fassungen der Formate kommen per Update.
Natalias Einwand ist berechtigt: CSB-Rad macht sich von der Pflege durch Fremde abhängig; dazu kommen Einarbeitungsaufwand und weitere Abhängigkeiten, deren Fehler und Sicherheitslücken auch den Shop treffen. Gegenmaßnahmen: vor der Auswahl prüfen, wie aktiv das Projekt gepflegt wird; den Zugriff im Shop hinter einer eigenen Schnittstelle (z. B. einem Interface
RechnungsExporter) kapseln, damit sich die Bibliothek später austauschen lässt. Die Apache-2.0-Lizenz erlaubt es außerdem, den Quelltext notfalls selbst weiterzupflegen.Empfehlung, zum Beispiel:
erechnung-kiteinsetzen, aber gekapselt und mit Tests, die die erzeugten Dateien gegen die offiziellen Prüfwerkzeuge validieren. Eine Eigenentwicklung lohnt sich nur, wenn keine gepflegte Bibliothek verfügbar ist.
ab) Du erweiterst csb-partner-client um die Klasse SchliessanlagenClient, über die Shop und Werkstattportal Nachschlüssel für eine bestehende Schließanlage bei der Lipper SchließTec bestellen. Das Team des Werkstattportals arbeitet ausschließlich mit der erzeugten Javadoc-Seite und liest Deinen Quelltext nicht. Cem hat Dir die Regeln für die Methode nachbestellen aufgeschrieben:
Die Methode bestellt für eine bestehende Schließanlage zusätzliche Schlüssel bei der Lipper SchließTec. Übergeben werden der Schließungscode der Anlage (Format
VS-und acht Zeichen, z. B.VS-7Q4K2M9, darf nicht leer sein) und die Anzahl der Schlüssel (1 bis 20 je Bestellung). Zurück kommt die Bestellnummer der SchließTec, z. B.LST-2026-08812. Ist der Code falsch aufgebaut oder die Anzahl außerhalb des Bereichs, wird eineIllegalArgumentExceptiongeworfen. Ist die SchließTec-API nicht erreichbar oder kennt sie den Schließungscode nicht, wird eineSchliessTecExceptiongeworfen.
Ergänze den Dokumentationskommentar an den Stellen (1) bis (5). Nenne außerdem zwei Angaben, die das Team des Werkstattportals braucht, die aber nicht in diesen Methodenkommentar, sondern in den Kommentar der Klasse SchliessanlagenClient gehören. (7 Punkte)
/**
 * (1) ...
 *
 * @param schliessungscode (2) ...
 * @param anzahl (3) ...
 * @return (4) ...
 * @throws IllegalArgumentException wenn der Schließungscode falsch aufgebaut ist
 *         oder die Anzahl nicht zwischen 1 und 20 liegt
 * @throws (5) ...
 * @since 2.4
 */
public String nachbestellen(String schliessungscode, int anzahl) throws SchliessTecExceptionJe Lücke 1 Punkt, zum Beispiel:
/**
 * Bestellt für eine bestehende Schließanlage zusätzliche Schlüssel
 * bei der Lipper SchließTec KG.                                         (1)
 *
 * @param schliessungscode Schließungscode der Anlage, nicht leer,
 *        Format "VS-" und acht Zeichen, z. B. "VS-7Q4K2M9"            (2)
 * @param anzahl Anzahl der nachzubestellenden Schlüssel, 1 bis 20       (3)
 * @return Bestellnummer der SchließTec, z. B. "LST-2026-08812"          (4)
 * @throws IllegalArgumentException wenn der Schließungscode falsch aufgebaut ist
 *         oder die Anzahl nicht zwischen 1 und 20 liegt
 * @throws SchliessTecException wenn die SchließTec-API nicht erreichbar ist
 *         oder den Schließungscode nicht kennt                          (5)
 * @since 2.4
 */
public String nachbestellen(String schliessungscode, int anzahl) throws SchliessTecException
Für (2) bis (4) gibt es den Punkt nur, wenn Bedeutung und gültiger Wertebereich bzw. Format angegeben sind; für (5) müssen Exception-Name und beide Auslöser genannt werden.
Für den Klassenkommentar je 1 Punkt, zum Beispiel: wozu die Klasse dient, mit einem kurzen Verwendungsbeispiel; welche Konfiguration ein Objekt braucht (Adresse und Zugangsschlüssel der SchließTec-API); ob ein Objekt von mehreren Threads gleichzeitig genutzt werden darf; wie viele Anfragen je Stunde die SchließTec zulässt; @since 2.4 und Verweise (@see) auf verwandte Klassen.
ac) csb-partner-client verwendet Semantic Versioning (MAJOR.MINOR.PATCH). Für die nächsten Monate sind drei voneinander unabhängige Änderungen geplant, jeweils ausgehend von Version 2.3.1:
Ein Fehler bei der Zeitüberschreitung der OPC-UA-Verbindung wird behoben; die Schnittstelle bleibt gleich.
Die neue Klasse
SchliessanlagenClientkommt hinzu; alle bisherigen Klassen und Methoden bleiben unverändert.Die Methode
bestandAbfragen(String artikelnummer)bekommt einen zusätzlichen Pflichtparameterint lager; die alte Variante entfällt.
Gib für jede Änderung die neue Versionsnummer an und begründe sie kurz. (3 Punkte)
Je 1 Punkt (Versionsnummer mit Begründung):
2.3.2 – reine Fehlerbehebung ohne Änderung der Schnittstelle: PATCH wird erhöht.
2.4.0 – neue Funktion, abwärtskompatibel: MINOR wird erhöht, PATCH auf 0 gesetzt (passt zu
@since 2.4in Teilaufgabe ab).3.0.0 – inkompatible Änderung, weil vorhandener Code mit dem alten Aufruf nicht mehr kompiliert (Shop-Backend und Werkstattportal müssen angepasst werden): MAJOR wird erhöht, MINOR und PATCH auf 0 gesetzt.
b) Nach den beiden Ausfällen will Cem die Freitagabende mit Laptop und SSH abschaffen. Künftig soll eine Pipeline auf dem GitLab-Server von CSB-Rad, wo der Quelltext bereits in einem Git-Repository liegt, das Shop-Backend bauen, testen und ausliefern.
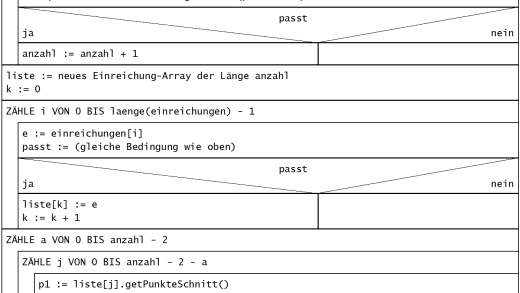
ba) Cem hat einen ersten Entwurf für die Pipeline aufgeschrieben:
| Schritt | Entwurf |
|---|---|
| Auslöser | jeder Push in einen beliebigen Branch |
Stufe 1 deploy |
.jar-Datei per SSH auf den Shop-Server kopieren, Dienst neu starten |
Stufe 2 build |
mvn package im Container-Image maven:3.9-eclipse-temurin-21 |
Stufe 3 test |
mvn verify (Unit-Tests); bei fehlgeschlagenen Tests geht eine Hinweis-Mail an das Team, die Pipeline läuft weiter |
| Zugang | SSH-Benutzer und Passwort des Shop-Servers stehen im Klartext in .gitlab-ci.yml |
Der Shop-Server läuft weiterhin mit Java 17. Beschreibe vier Fehler im Entwurf und gib jeweils eine Korrektur an. (8 Punkte)
Je Fehler 1 Punkt für die Beschreibung und 1 Punkt für die Korrektur, vier der folgenden fünf:
Reihenfolge: Ausgeliefert wird, bevor gebaut und getestet ist – damit ginge der alte oder ein ungetesteter Stand live. Korrektur:
build→test→ (package) →deploy.Tests ohne Wirkung: Fehlgeschlagene Tests stoppen die Pipeline nicht, fehlerhafter Code wird trotzdem ausgeliefert (wie bei der Versandkostenberechnung). Korrektur: Bei einem fehlgeschlagenen Test bricht die Pipeline ab; ausgeliefert wird nur, wenn alle Stufen erfolgreich waren.
Auslöser: Jeder Push in einen beliebigen Branch, auch unfertige Feature-Branches, landet direkt im Live-Shop. Korrektur: Bauen und testen bei jedem Push/Merge Request, aber nur Stände aus
mainauf ein Staging-System ausliefern und nur getaggte Versionen nach manueller Freigabe in die Produktion.Zugangsdaten im Repository: Das Passwort ist für alle mit Zugriff auf das Repository und dauerhaft in der Git-Historie sichtbar. Korrektur: SSH-Schlüssel statt Passwort, als geschützte und maskierte CI/CD-Variable hinterlegen, die nur in geschützten Branches/Tags verfügbar ist.
Java-Version passt nicht zum Server: Das Build-Image nutzt Java 21, der Server Java 17 – genau der Fehler vom 12.09.2026. Korrektur: Build-Image mit Java 17 verwenden (z. B.
maven:3.9-eclipse-temurin-17) oder zuerst den Server auf Java 21 aktualisieren bzw. Anwendung samt Laufzeitumgebung als Container ausliefern.
So könnte die korrigierte Pipeline aussehen:

bb) Sophie Bertram (Geschäftsführerin Vertrieb) wünscht sich: „Jede fertige Änderung soll sofort automatisch im Shop sein.“ Cem möchte lieber jede Version vor der Auslieferung in die Produktion selbst freigeben.
Erläutere den Unterschied zwischen Continuous Delivery und Continuous Deployment und begründe, welche Variante Du für den Shop empfiehlst. (4 Punkte)
2 Punkte für die Erläuterung, 2 Punkte für eine begründete Empfehlung:
Continuous Delivery: Jede Änderung wird automatisch gebaut, getestet und bis in eine Testumgebung ausgeliefert, sodass jeder Stand jederzeit veröffentlicht werden könnte. Die Auslieferung in die Produktion erfolgt nach einer manuellen Freigabe (Cems Wunsch).
Continuous Deployment: Auch die Auslieferung in die Produktion läuft ohne menschliches Zutun, sobald alle Prüfungen bestanden sind (Sophies Wunsch).
Empfehlung, zum Beispiel: Zunächst Continuous Delivery. Die Testabdeckung des Shop-Backends ist offensichtlich noch lückenhaft (Versandkostenfehler), und Fehler im Live-Shop kosten direkt Umsatz und Vertrauen. Mit der manuellen Freigabe kann eine Version auf dem Staging-System kurz geprüft und zu einem günstigen Zeitpunkt veröffentlicht werden. Wenn die automatisierten Tests zuverlässig sind und Rollbacks geübt wurden, kann später auf Continuous Deployment umgestellt werden. Eine begründete Empfehlung für Continuous Deployment (z. B. kleine, risikoarme Änderungen, schnelle Reaktion auf Kundenwünsche, Voraussetzung: hohe Testabdeckung) wird ebenfalls gewertet.
bc) Beschreibe, wie das Team mit der neuen Pipeline reagieren kann, wenn eine ausgelieferte Version trotz aller Tests einen schweren Fehler im Live-Shop verursacht. (2 Punkte)
2 Punkte, zum Beispiel:
Das Team führt ein Rollback durch: Die Bereitstellungsstufe der Pipeline wird für den letzten funktionierenden Stand – z. B. das vorherige Tag v4.7.2 – erneut ausgeführt, oder das dort gespeicherte Build-Ergebnis wird erneut ausgeliefert. Das geht mit wenigen Klicks und ohne Zugriff auf den Server per Hand. Anschließend wird der Fehler in einem Branch behoben, mit einem neuen Test abgesichert und als neue Version über die Pipeline ausgeliefert (alternativ: git revert der fehlerhaften Änderung, die Pipeline liefert den korrigierten Stand aus).
c) Im November 2026 warnt das BSI vor einer kritischen Sicherheitslücke in der Bibliothek „jsonfast“ ab Version 2.14. Das Team benutzt „jsonfast“ nicht direkt – es stellt sich aber heraus, dass „erechnung-kit“ sie intern verwendet.
Erläutere zwei Maßnahmen, mit denen das Team solche Sicherheitslücken in Abhängigkeiten künftig früh erkennt und schnell beheben kann. (4 Punkte)
Je 2 Punkte, zum Beispiel:
Abhängigkeitsprüfung in der Pipeline (dependency scanning): Bei jedem Build werden alle direkten und transitiven Abhängigkeiten mit Datenbanken bekannter Schwachstellen (CVE) abgeglichen; bei kritischen Funden bricht die Pipeline ab bzw. meldet den Fund. So fällt eine Lücke wie in „jsonfast“ auf, auch wenn sie nur indirekt eingebunden ist.
Software-Stückliste (SBOM): Die Pipeline erzeugt bei jedem Build eine Liste aller enthaltenen Komponenten mit Versionen. Bei einer neuen Warnung ist sofort klar, welche Versionen von Shop und Werkstattportal betroffen sind.
Festgelegte Versionen und regelmäßige Updates: Versionen werden in der
pom.xmlfest eingetragen; Werkzeuge schlagen automatisch Updates vor (Merge Request mit neuer Version), die durch die Pipeline getestet werden. Eine abgesicherte Version kann so innerhalb kurzer Zeit gebaut, getestet und ausgeliefert werden.Sicherheitsmeldungen verfolgen: Warnungen des BSI/CERT und der Projekte der verwendeten Bibliotheken abonnieren und eine verantwortliche Person benennen.
Aufgabe 3.1: Mit dem Debugger einen Fehler im Altersfilter finden (Profilkompetenz)
(ca. 31 min Bearbeitungszeit)
Die Let’s Meet GmbH in Bielefeld betreibt eine App für gemeinsame Freizeitaktivitäten. Nutzen dürfen sie Menschen ab 16 Jahren; jede Aktivität hat ein Mindestalter von 16 oder 18 Jahren, und Minderjährige dürfen nur Aktivitäten ab 16 sehen. Das Backend ist in Java mit Spring Boot geschrieben und läuft in einem Docker-Container. Du bist Auszubildende*r in der Entwicklung. Dein Mit-Azubi Jonas Weber sucht Fehler bisher, indem er überall System.out.println(…) einfügt und das Backend neu startet.
a) Jonas fragt: „Wozu soll ich mich mit dem Debugger beschäftigen? Mit ein paar Ausgaben sehe ich doch auch, was passiert.“
aa) Überzeuge Jonas: Stelle zwei Situationen dar, in denen der Debugger mehr leistet als eingestreute Ausgaben. Erkläre ihm außerdem, welche Fehler er schon über die Meldungen des Compilers und welche über Unittests bemerkt, bevor er überhaupt einen Debugger braucht. (6 Punkte)
Je Situation 2 Punkte, je 1 Punkt für die Einordnung von Compiler und Unittests, zum Beispiel:
Unklare Spur: Solange man nicht weiß, welche Werte wichtig sind, muss Jonas für jede neue Vermutung eine weitere Ausgabe einbauen, neu übersetzen und das Backend neu starten. Am Haltepunkt zeigt der Debugger dagegen sofort alle lokalen Variablen, die Inhalte der Objekte und den Aufrufstapel; Ausdrücke lassen sich direkt auswerten.
Langer Ablauf: Führt der Weg zum Fehler durch mehrere Methoden oder viele Schleifendurchläufe, liefern Ausgaben eine unübersichtliche Textflut. Mit dem Debugger verfolgt man den Ablauf Schritt für Schritt, hält nur unter einer Bedingung an und kann einen Wert zur Laufzeit ändern, um eine Vermutung sofort zu prüfen.
Weitere: Vergessene Ausgaben bleiben im Code und landen in den Logs des Live-Betriebs, womöglich mit personenbezogenen Daten.
Compiler: meldet Syntax- und Typfehler, bevor das Programm läuft (z. B. fehlendes Semikolon,
Stringstattint). Logikfehler wie eine falsche Altersberechnung erkennt er nicht.Unittests: zeigen automatisch und wiederholbar, dass ein Programmteil ein falsches Ergebnis liefert. Wo und warum der Fehler entsteht, klärt dann der Debugger.
ab) Ordne jeder Situation die Debugger-Funktion zu, die Dir am schnellsten weiterhilft. (4 Punkte)
| Nr. | Situation |
|---|---|
| 1 | Das Programm hält in berechneAlter, und Du willst wissen, aus welcher Methode und über welche Aufrufe es dorthin gekommen ist. |
| 2 | Irgendwo im Backend tritt gelegentlich eine NullPointerException auf; Du weißt nicht, in welcher Zeile. |
| 3 | Du bist im Einzelschritt in eine lange Hilfsmethode geraten, die Dich nicht interessiert, und willst zurück in die aufrufende Methode. |
| 4 | Du willst bei jedem Halt sofort sehen, welchen Wert der Ausdruck heute.getYear() - benutzer.getGeburtsdatum().getYear() gerade hat. |
Je Situation 1 Punkt:
Aufrufstapel (Call Stack): zeigt die Kette der Methodenaufrufe bis zur aktuellen Zeile; ein Klick auf einen Eintrag zeigt die Variablen der jeweiligen Methode.
Ausnahme-Haltepunkt (Exception Breakpoint) für
NullPointerException: Der Debugger hält genau dort an, wo die Ausnahme geworfen wird.Step Out: führt die aktuelle Methode zu Ende aus und hält in der aufrufenden Methode an.
Beobachtungsausdruck (Watch): Der Ausdruck wird bei jedem Halt neu ausgewertet und angezeigt.
b) Am 05.01.2027 meldet der Support: Noah Bergmann (Benutzer 13, geboren am 12.03.2009) sieht in seiner Liste die Aktivität „Kneipenquiz“ mit Mindestalter 18. Der Filter ist so umgesetzt:
public int berechneAlter(LocalDate geburtsdatum, LocalDate stichtag) {
    return stichtag.getYear() - geburtsdatum.getYear();
}

public List<Aktivitaet> sichtbareAktivitaeten(Benutzer benutzer, List<Aktivitaet> alle, LocalDate heute) {
    int alter = berechneAlter(benutzer.getGeburtsdatum(), heute);
    List<Aktivitaet> ergebnis = new ArrayList<>();
    for (Aktivitaet a : alle) {
        if (alter >= a.getMindestalter()) {
            ergebnis.add(a);
        }
    }
    return ergebnis;
}
Du stellst den Fall in der Testumgebung mit Noahs Daten und dem Datum 05.01.2027 nach und startest das Backend im Debug-Modus.
ba) Gib zwei Vorgehensweisen an, wie Du den Fehler mit den Möglichkeiten des Debuggers eingrenzt. Nenne jeweils, wo Du ansetzt und was Du beobachtest. (4 Punkte)
Je Vorgehensweise 2 Punkte (1 Punkt Vorgehen, 1 Punkt konkreter Ansatzpunkt), z. B.:
- Haltepunkt und Variablen prüfen: Haltepunkt auf die Zeile
List<Aktivitaet> ergebnis = …setzen (also direkt nach der Altersberechnung) und den Wert vonalterim Variablenfenster ablesen. Erwartet wäre 17, angezeigt wird 18 – der Fehler liegt also inberechneAlter. - Einzelschrittmodus in der Schleife: Haltepunkt in der
for-Schleife setzen und mit Step Over die Durchläufe verfolgen; bei der Aktivität „Kneipenquiz“a.getMindestalter()(18) undaltervergleichen und beobachten, dass die Bedingungtrueergibt. - Step Into in die Methode: Beim Aufruf von
berechneAltermit Step Into hineinspringen und die Werte vonstichtag.getYear()undgeburtsdatum.getYear()ansehen. - Werte ändern:
alterim Debugger auf 17 setzen und weiterlaufen lassen; verschwindet die Aktivität, ist der Filter selbst richtig und nur das Alter falsch.
bb) Die Testdatenbank enthält einige hundert Aktivitäten. Formuliere die Bedingung für einen bedingten Haltepunkt in der Schleife, damit der Debugger nur bei einer Aktivität ab 18 Jahren anhält. (2 Punkte)
a.getMindestalter() == 18 (2 Punkte; alternativ a.getMindestalter() > alter - 1 oder a.getMindestalter() == 18 && benutzer.getBenutzerId() == 13). Ohne Bedingung müsste man sich durch alle Durchläufe klicken.
bc) Der Debugger steht auf der Zeile int alter = berechneAlter(…);. Erläutere, wann Du hier Step Over und wann Step Into verwendest. (3 Punkte)
- Step Over (1 Punkt) führt die ganze Zeile einschließlich des Methodenaufrufs aus und hält in der nächsten Zeile. Das genügt, wenn man nur das Ergebnis (
alter) prüfen will oder der Methode vertraut. - Step Into (1 Punkt) springt in
berechneAlterhinein. Das ist nötig, sobald feststeht, dassalterfalsch ist, um die Berechnung Zeile für Zeile zu verfolgen. - Begründung für diesen Fall (1 Punkt): Zuerst Step Over, um
alterzu sehen (18 statt 17); weil das falsch ist, beim nächsten Durchlauf Step Into. (Mit Step Out kommt man aus der Methode wieder heraus.)
bd) Erläutere die Ursache des Fehlers. Begründe, warum er bei Noah erst seit dem 01.01.2027 auftritt, und korrigiere die Methode berechneAlter. (4 Punkte)
- Ursache (1 Punkt): Die Methode zieht nur die Jahreszahlen voneinander ab und berücksichtigt nicht, ob die Person in diesem Jahr schon Geburtstag hatte.
- Begründung (1 Punkt): Im Jahr 2026 ergab 2026 − 2009 = 17 (richtig). Seit dem 01.01.2027 ergibt 2027 − 2009 = 18, obwohl Noah erst am 12.03.2027 volljährig wird. Bis dahin sieht er Aktivitäten ab 18 – ein Verstoß gegen den Jugendschutz der App.
- Korrektur (2 Punkte):
public int berechneAlter(LocalDate geburtsdatum, LocalDate stichtag) {
    return Period.between(geburtsdatum, stichtag).getYears();
}
Ebenfalls richtig: vom Jahresunterschied 1 abziehen, wenn der Geburtstag (Monat und Tag) im Stichtagsjahr noch nicht erreicht ist.
c) Bevor Ihr den Fehler gefunden hattet, schlug Jonas vor, den Debugger direkt mit dem Backend im Live-Betrieb zu verbinden (Remote-Debugging über einen geöffneten Debug-Port des Containers), um „echte Fälle“ zu untersuchen.
ca) Beschreibe zwei Möglichkeiten, einen Fehler zu untersuchen, der nur im Betrieb auftritt, ohne den Live-Betrieb anzuhalten. (4 Punkte)
Je 2 Punkte, z. B.:
- Fall in einer Test- oder Staging-Umgebung nachstellen, die dieselbe Programmversion und vergleichbare, aber anonymisierte oder künstliche Testdaten enthält (z. B. Testkonto mit Geburtsdatum 12.03.2009), und dort mit dem Debugger arbeiten – auch per Remote-Debugging in einen Testcontainer.
- Logging gezielt erweitern: an der verdächtigen Stelle das berechnete Alter und die Mindestalter-Prüfung mit einer passenden Protokollstufe (z. B. DEBUG) und ohne personenbezogene Daten protokollieren, z. B. nur mit Benutzer-ID, und die Logs auswerten.
- Logpoints oder Beobachtungswerkzeuge (Monitoring, Tracing) nutzen, die Meldungen schreiben, ohne das Programm anzuhalten.
cb) Erläutere zwei Risiken, die gegen Jonas’ Vorschlag sprechen. (4 Punkte)
Je 2 Punkte, z. B.:
- Betrieb wird gestört: Hält der Debugger an einem Haltepunkt, bleiben die Anfragen aller Nutzenden in diesem Thread hängen; die App reagiert nicht mehr oder Zeitüberschreitungen entstehen.
- Datenschutz: Im Debugger sind alle Daten im Speicher sichtbar, auch Geburtsdaten, Adressen und Chatnachrichten echter Nutzender, darunter Minderjähriger. Ein Zugriff ohne Rechtsgrundlage und Erforderlichkeit verstößt gegen die DSGVO (Datenminimierung, Vertraulichkeit).
- IT-Sicherheit: Ein offener Debug-Port (z. B. JDWP) erlaubt, Code im Prozess auszuführen und Werte zu ändern; ist er erreichbar, kann ein Angreifer den Server übernehmen.
- Veränderung des Verhaltens: Werte, die im Debugger geändert werden, wirken sich direkt auf echte Daten und Abläufe aus.
d) Damit der Fehler nicht zurückkommt, schreibst Du Unittests für berechneAlter. Gib drei sinnvolle Testfälle mit Geburtsdatum, Stichtag und erwartetem Alter an, die die Grenzfälle abdecken. (3 Punkte)
Je Testfall 1 Punkt, z. B.:
| Geburtsdatum | Stichtag | erwartetes Alter | geprüfter Fall |
|---|---|---|---|
| 12.03.2009 | 05.01.2027 | 17 | Geburtstag im Jahr noch nicht erreicht (der gemeldete Fehler) |
| 12.03.2009 | 11.03.2027 | 17 | Tag vor dem 18. Geburtstag |
| 12.03.2009 | 12.03.2027 | 18 | am 18. Geburtstag |
| 12.03.2009 | 13.03.2027 | 18 | Tag nach dem Geburtstag |
| 29.02.2008 | 28.02.2026 | 17 | Schaltjahr-Geburtstag (Period.between zählt den 29.02. erst am 01.03. als erreicht) |
Links und weitere Informationen
zum Artikel: Werkzeuge der Softwareentwicklung: Compiler, Debugger, Bibliotheken, Versionsverwaltung, CI/CD und Open Source
verwandte Artikel: Git: Repository anlegen und lokal committen, Build-Tool Maven
Hinweis zur Nachnutzung als Open Educational Resource (OER)
Dieser Artikel und seine Texte, Bilder, Grafiken, Code und sonstiger Inhalt sind - sofern nicht anders angegeben - lizenziert unter CC BY 4.0. Nennung gemäß TULLU-Regel bitte wie folgt: “Übungsaufgaben zu Werkzeugen der Softwareentwicklung” von oer-informatik.de (H. Stein), Lizenz: CC BY 4.0. Der Artikel wurde unter https://oer-informatik.de/entwicklungswerkzeuge-uebungsaufgaben veröffentlicht, die Quelltexte sind in weiterverarbeitbarer Form verfügbar im Repository unter https://gitlab.com/oer-informatik/programmierung/programmiergrundlagen. Erstellt mit KI-Assistenz; von mir umfassend redaktionell überarbeitet, geprüft und freigegeben. Stand: 28.10.2026.
[Kommentare zum Artikel lesen, schreiben] / [Artikel teilen] / [gitlab-Issue zum Artikel schreiben]