Datenaustauschformate: CSV, XML und JSON vergleichen
https://bildung.social/@oerinformatik/
https://oer-informatik.de/datenaustauschformate
Datenaustauschformat, CSV, XML, JSON, Zeichenkodierung, ASCII, Unicode, UTF-8, UTF-16, Binärformat, REST, Prüfungsvorbereitung
tl/dr; (ca. 19 min Lesezeit): Wenn Programme Daten austauschen, landen sie meist in einer CSV-, XML- oder JSON-Datei. Der Artikel erklärt den Unterschied zwischen Text- und Binärformaten, zeigt, wie Du ein unbekanntes Dateiformat einordnest, wie Zeichenkodierungen wie ASCII, UTF-8 und UTF-16 den Speicherbedarf beeinflussen, wie derselbe Datensatz in CSV, XML und JSON aussieht, welche Datentypen JSON kennt, wie Du Tabellen in JSON umwandelst und welches Format für welchen Zweck passt [AI-Assisted]. (Zuletzt geändert am 28.10.2026)
Dieser Artikel baut auf der Kann-Liste des Artikels Die Auszeichnungssprache Extensible Markup Language (XML) auf. Übungen findest Du unter Übungsaufgaben zu Datenaustauschformaten.
Schon fit in diesem Thema? Nutze die Kann-Liste und die Leitfragen unter dem Artikel als Checkliste, ob Du die relevanten Kompetenzen bereits hast.
Als Grundlagen zu Datenaustauschformaten kann ich nach Durchlesen des Artikels…
… den Unterschied zwischen einer Datei im Textformat (z. B. ASCII) und einer Binärdatei erläutern.
… Möglichkeiten nennen, Informationen über ein unbekanntes Dateiformat zu beschaffen und Daten in ein benötigtes Format umzuwandeln.
… gängige Dateiformate (z. B. CSV, PDF, JPG, TIFF, ISO) ihrem Zweck zuordnen.
… die Formate CSV, XML und JSON mit je zwei charakteristischen Merkmalen beschreiben und ihren gemeinsamen Vorteil nennen.
… einen tabellarischen Datensatz im CSV-, XML- und JSON-Format darstellen.
… Fehler in einer CSV-Datei (Trennzeichen, Datumsformat, ungültige Zeichen, falscher Dateityp) erkennen und erklären.
… erläutern, wie sich der Speicherbedarf eines Textes mit ASCII, UTF-8 und UTF-16 unterscheidet.
Darüber hinaus kann ich als Kernwissen zu Datenaustauschformaten…
… in einem JSON-Dokument Attribute, Werte und Datentypen (String, Zahl, Boolean, Array, Objekt) bestimmen.
… Datensätze aus Tabellen in JSON umwandeln und zusammengehörige Daten als Array in ein Dokument einbetten.
… für eine Situation ein passendes Austauschformat auswählen und die Wahl mit Pro- und Kontra-Argumenten begründen.
… Vorteile von JSON gegenüber XML angeben und begründen, wann CSV die bessere Wahl ist.
Ein Onlineshop schickt Bestellungen an das Warenwirtschaftssystem, eine Wetterstation liefert Messwerte an einen Server, eine App fragt Daten über eine Web-Schnittstelle ab. Immer müssen zwei Programme, die oft von unterschiedlichen Herstellern stammen und auf verschiedenen Systemen laufen, dieselben Daten verstehen. Dafür braucht es ein gemeinsames Datenaustauschformat. Die drei wichtigsten sind CSV, XML und JSON.

Textformat oder Binärformat?
Jede Datei besteht letztlich aus Bytes. Entscheidend ist, wie diese Bytes gedeutet werden:
Eine Textdatei (oft „ASCII-Datei“ genannt) speichert nur Zeichen, die über eine Zeichenkodierung (z. B. ASCII oder UTF-8) festgelegt sind, gegliedert durch Zeilenumbrüche. Du kannst sie mit jedem Texteditor öffnen, lesen und bearbeiten. Beispiele:
.csv,.xml,.json,.txt,.html, Quelltext.Eine Binärdatei speichert die Daten so, wie das Programm sie intern verarbeitet, z. B. Zahlen als 32-Bit-Gleitkommawerte, Bilder als komprimierte Pixeldaten. Im Texteditor erscheint nur Zeichensalat; lesen und verarbeiten kann sie nur ein Programm, das das Format kennt. Beispiele:
.jpg,.png,.pdf(meist),.docxund.xlsx(ZIP-Archive),.exe,.iso.
Binärdateien sind meist kleiner und schneller zu verarbeiten: Die Zahl 3,14159 braucht als 32-Bit-Float immer 4 Byte, als Text 7 Byte (ein Byte je Zeichen). Textdateien sind dafür für Menschen lesbar, lassen sich mit einfachen Mitteln prüfen und von fast jedem Programm verarbeiten – deshalb sind die gängigen Austauschformate textbasiert. Manche Formate gibt es in beiden Varianten, etwa das 3D-Format PLY oder STL.
| Format | Zweck | Text/Binär |
|---|---|---|
| CSV | Tabellendaten, Zeilen mit Trennzeichen | Text |
| XML, JSON | strukturierte (hierarchische) Daten | Text |
| druckfertiges, layouttreues Dokument | binär (mit Textanteilen) | |
| JPG | verlustbehaftet komprimiertes Foto | binär |
| TIFF | verlustfrei gespeichertes Bild, z. B. für Druck und Scans | binär |
| ISO | Abbild (Image) eines kompletten Datenträgers, z. B. einer DVD | binär |
| DOCX, XLSX | Office-Dokument (gezippte XML-Dateien) | binär (ZIP) |
Unbekannte Dateiformate einordnen und umwandeln
Bekommst Du Daten in einem Format, das Du nicht kennst, helfen diese Schritte:
Informationen beschaffen: Websuche nach der Dateiendung, Dokumentation oder Spezifikation des Formats, Nachfrage beim Absender oder Hersteller der Software, Fachforen und Fachliteratur, Handbücher der eigenen Programme. Auch ein KI-Chatbot kann einen ersten Hinweis geben – prüfe die Antwort an einer verlässlichen Quelle.
In die Datei schauen: Öffne sie in einem Texteditor oder Hex-Editor. Lesbarer Text deutet auf ein Textformat hin; viele Binärformate beginnen mit einer festen Byte-Folge (Magic Number, Dateisignatur), z. B.
%PDFbei PDF oderPKbei ZIP-basierten Formaten wie DOCX. Die Dateiendung allein ist kein Beweis: Sie lässt sich beliebig ändern.Daten nutzbar machen: Prüfe, ob Dein Programm das Format importieren kann (Importfunktion, Plug-in), ob das Ursprungsprogramm in ein passendes Format exportieren kann, oder nutze einen Dateikonverter. Notfalls schreibst Du einen eigenen Konverter, z. B. ein kurzes Skript.
Beim Umwandeln gehen manchmal Informationen verloren (etwa Farben, Formatierungen, Genauigkeit). Kontrolliere das Ergebnis deshalb immer an Stichproben.
Zeichenkodierung: ASCII, Unicode, UTF-8 und UTF-16
Damit aus Bytes Zeichen werden, braucht jede Textdatei eine Zeichenkodierung (Encoding). Sie legt fest, welche Bitfolge für welches Zeichen steht.
ASCII (American Standard Code for Information Interchange) ordnet 128 Zeichen – lateinische Buchstaben ohne Umlaute, Ziffern, Satzzeichen und Steuerzeichen – einen 7-Bit-Code zu. Gespeichert wird jedes Zeichen in einem Byte. Für ä, ö, ü, ß oder € reicht ASCII nicht; ältere 8-Bit-Erweiterungen wie ISO 8859-1 (Latin-1) oder Windows-1252 nutzen die übrigen 128 Codes, aber jede nur für eine Sprachgruppe.
Unicode ist der internationale Standard, der jedem Schriftzeichen aller Schriften – auch Emojis und mathematischen Zeichen – eine eindeutige Nummer (Codepoint, z. B. U+00FC für ü) zuweist. Version 18.0 vom September 2026 umfasst rund 173.000 Zeichen. Unicode selbst legt noch nicht fest, wie die Nummer in Bytes gespeichert wird; das regeln die Kodierungen UTF-8, UTF-16 und UTF-32.
UTF-8 speichert jedes Zeichen mit 1 bis 4 Byte. Die 128 ASCII-Zeichen brauchen genau ein Byte und sind identisch mit ASCII; Umlaute brauchen 2 Byte, das €-Zeichen 3 Byte, viele Emojis 4 Byte. UTF-8 ist der Standard im Web und für JSON.
UTF-16 speichert jedes Zeichen mit 2 Byte, seltene Zeichen (z. B. Emojis) mit 4 Byte. Windows und Java verwenden UTF-16 intern.
| Zeichen | ASCII | UTF-8 | UTF-16 |
|---|---|---|---|
| A | 1 Byte | 1 Byte | 2 Byte |
| ü | nicht darstellbar | 2 Byte | 2 Byte |
| € | nicht darstellbar | 3 Byte | 2 Byte |
| Emoji „grinsendes Gesicht“ (U+1F600) | nicht darstellbar | 4 Byte | 4 Byte |
Für den Speicherbedarf heißt das: Ein Text, der nur aus ASCII-Zeichen besteht, belegt in UTF-8 genauso viel Platz wie in ASCII, in UTF-16 dagegen ungefähr doppelt so viel. Eine Webseite mit 10.000 ASCII-Zeichen wächst also von rund 10 KB auf rund 20 KB.
Welche Kodierung eine Datei hat, steht nicht immer in der Datei. XML nennt sie im Prolog (<?xml version="1.0" encoding="UTF-8"?>); fehlt die Angabe, gilt UTF-8 oder UTF-16. JSON muss beim Austausch zwischen Systemen in UTF-8 kodiert sein (RFC 8259). Bei CSV gibt es keine Angabe – daher die bekannten kaputten Umlaute: Wird eine UTF-8-Datei als Windows-1252 gelesen, erscheint aus „Grün“ ein „Grün“. Manche Programme schreiben zur Kennzeichnung eine Byte Order Mark (BOM) an den Dateianfang. Vereinbare die Kodierung beim Datenaustausch deshalb immer ausdrücklich, im Zweifel UTF-8.
Ein Beispiel in drei Formaten
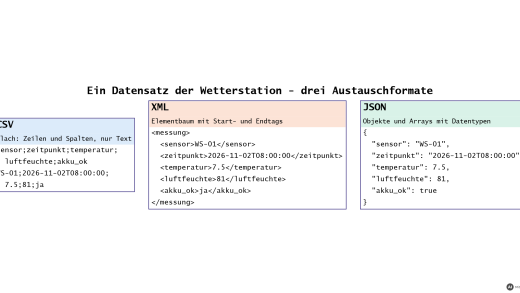
Eine Wetterstation auf dem Schuldach liefert Messwerte von zwei Sensoren:
| sensor | zeitpunkt | temperatur | luftfeuchte | akku_ok |
|---|---|---|---|---|
| WS-01 | 2026-11-02T08:00:00 | 7.5 | 81 | ja |
| WS-02 | 2026-11-02T08:00:00 | 6.9 | 84 | nein |
Den Zeitpunkt schreibst Du am besten nach ISO 8601 (JJJJ-MM-TTThh:mm:ss): Das Format ist eindeutig, sortierbar und international verständlich, während 02.11.2026 in den USA als 11. Februar gelesen würde.
CSV: Werte mit Trennzeichen
CSV (Comma-Separated Values) ist das einfachste Format: Jede Zeile ist ein Datensatz, die Werte sind durch ein Trennzeichen (Delimiter) getrennt. Die erste Zeile enthält meist die Spaltennamen (Kopfzeile).
sensor;zeitpunkt;temperatur;luftfeuchte;akku_ok
WS-01;2026-11-02T08:00:00;7.5;81;ja
WS-02;2026-11-02T08:00:00;6.9;84;nein
Merkmale:
Textdatei, zeilenweise aufgebaut: Zeilenumbruch trennt die Datensätze, das Trennzeichen die Felder.
Flache Struktur: nur Zeilen und Spalten, keine Verschachtelung. Eine Bestellung mit mehreren Positionen passt nur in mehrere Zeilen oder mehrere Dateien.
Keine Datentypen: Alles ist Text; ob
81eine Zahl ist, weiß nur das einlesende Programm.Sehr wenig Overhead und von jeder Tabellenkalkulation und Datenbank lesbar.
Nur locker festgelegt: RFC 4180 beschreibt Komma als Trennzeichen und doppelte Anführungszeichen für Felder, die das Trennzeichen oder Zeilenumbrüche enthalten (
"Bielefeld; Mitte"). In Deutschland ist das Semikolon üblich, weil das Komma als Dezimaltrennzeichen dient. Trennzeichen, Dezimaltrennzeichen, Datumsformat und Zeichenkodierung müssen Sender und Empfänger deshalb vereinbaren.
XML: Elemente mit Start- und Endtag
XML (Extensible Markup Language, W3C-Empfehlung) beschreibt Daten als Baum aus Elementen. Jedes Element hat ein Starttag und ein Endtag oder ist ein Leertag; Elemente können Text, Attribute und weitere Elemente enthalten. Ein XML-Dokument hat genau ein Wurzelelement.
<?xml version="1.0" encoding="UTF-8"?>
<messwerte>
  <messung>
    <sensor>WS-01</sensor>
    <zeitpunkt>2026-11-02T08:00:00</zeitpunkt>
    <temperatur>7.5</temperatur>
    <luftfeuchte>81</luftfeuchte>
    <akku_ok>ja</akku_ok>
  </messung>
  <messung>
    <sensor>WS-02</sensor>
    <zeitpunkt>2026-11-02T08:00:00</zeitpunkt>
    <temperatur>6.9</temperatur>
    <luftfeuchte>84</luftfeuchte>
    <akku_ok>nein</akku_ok>
  </messung>
</messwerte>
Statt Kindelementen kannst Du einzelne Werte auch als Attribute schreiben, z. B. <messung sensor="WS-01">. Merkmale:
Textbasiert und hierarchisch: beliebig tief verschachtelbar, gut für komplexe Dokumente.
Selbstbeschreibend: Jeder Wert steht zwischen Tags mit seinem Namen – gut lesbar, aber mit viel Overhead.
Prüfbar: Wohlgeformtheit (Syntaxregeln) und Gültigkeit gegen eine DTD oder ein XML-Schema (XSD), das auch Datentypen festlegt. Dazu kommen Namensräume, Kommentare, XSLT-Transformation und XPath-Abfragen.
Typischer Einsatz: SOAP-Webservices, E-Rechnungen (XRechnung, ZUGFeRD), Office-Formate, viele Branchenstandards.
Die Regeln der Wohlgeformtheit und die Validierung erklären die Artikel XML-Einstieg, DTD und XML-Schema.
JSON: Objekte und Arrays
JSON (JavaScript Object Notation, RFC 8259 und ECMA-404) stammt aus JavaScript, wird aber von allen gängigen Programmiersprachen verarbeitet. Es kennt zwei Strukturen: Objekte in geschweiften Klammern mit Schlüssel-Wert-Paaren ("schlüssel": wert) und Arrays (Listen) in eckigen Klammern.
{
  "station": "Schuldach",
  "messwerte": [
    {
      "sensor": "WS-01",
      "zeitpunkt": "2026-11-02T08:00:00",
      "temperatur": 7.5,
      "luftfeuchte": 81,
      "akku_ok": true
    },
    {
      "sensor": "WS-02",
      "zeitpunkt": "2026-11-02T08:00:00",
      "temperatur": 6.9,
      "luftfeuchte": 84,
      "akku_ok": false
    }
  ]
}
Merkmale:
Textbasiert und hierarchisch: Objekte und Arrays lassen sich beliebig verschachteln.
Kompakt: keine Endtags, deutlich weniger Overhead als XML.
Eingebaute Datentypen (siehe nächster Abschnitt) und eingebaute Arrays.
Typischer Einsatz: REST-Schnittstellen (Web-APIs), Konfigurationsdateien, Dokumentendatenbanken wie MongoDB, Nachrichten im Internet der Dinge (z. B. über MQTT).
Die Syntax ist streng: Schlüssel und Zeichenketten stehen in doppelten Anführungszeichen, nach dem letzten Element folgt kein Komma, und Kommentare sind nicht erlaubt. Syntaxdiagramm, Escape-Sequenzen, Pfade und die Prüfung mit JSON Schema vertieft der Artikel JSON: Syntax, Datentypen und Prüfung.
Datentypen in JSON bestimmen
JSON kennt sechs Arten von Werten:
| JSON-Typ | Schreibweise | Beispiel | typischer Datentyp im Programm |
|---|---|---|---|
| String | in doppelten Anführungszeichen | "WS-01", "2026-11-02T08:00:00" |
String |
| Number | ohne Anführungszeichen, Dezimalpunkt | 81, -3, 7.5, 1.2e3 |
Integer (ganzzahlig, ohne Vorzeichen: UInteger), Float oder Double |
| Boolean | true oder false |
true |
Boolean |
| null | null |
null |
„kein Wert“ |
| Array | [ … ] |
[7.5, 6.9, 8.1] |
Liste bzw. Array, z. B. Float-Array |
| Object | { … } |
{"sensor": "WS-01"} |
Objekt bzw. Dictionary |
Ein paar Hinweise zum Bestimmen:
Steht ein Wert in Anführungszeichen, ist er ein String – auch
"81"oder"true".JSON unterscheidet nicht zwischen ganzen Zahlen und Kommazahlen; beides ist
number. Für die Übernahme in ein Programm wählst Du den passenden Typ:81als (vorzeichenlose) Ganzzahl,7.5als Float. Entscheidend ist dabei nicht die Zahl der Nachkommastellen, sondern die Zahl der signifikanten Stellen: Ein Float speichert etwa 7 signifikante Stellen, ein Double etwa 15–16. Werte, die genauer sein müssen, etwa GPS-Koordinaten wie51.907000, speicherst Du als Double.JSON hat keinen Datumstyp. Datum und Uhrzeit werden als String übertragen; Sender und Empfänger müssen das Format vereinbaren, am besten ISO 8601.
Mit JSON Schema lassen sich erlaubte Felder, Typen und Wertebereiche ähnlich wie mit XSD festlegen und automatisch prüfen.
Tabellen in JSON umwandeln
Aus einer Tabelle wird in JSON meist ein Array von Objekten: Jede Zeile wird ein Objekt, jede Spalte ein Schlüssel. Aus der Tabelle sensor (jeder Sensor gehört über den Fremdschlüssel station_id zu einer Station der Tabelle station) wird zum Beispiel:
[
  { "id": 1, "station_id": 1, "art": "Temperatur", "einheit": "°C" },
  { "id": 2, "station_id": 1, "art": "Luftfeuchte", "einheit": "%" }
]
Werden zusammengehörige Daten meistens gemeinsam gelesen und ist ihre Anzahl überschaubar, bettest Du sie in das übergeordnete Objekt ein. Der Fremdschlüssel station_id entfällt dann, denn die Zugehörigkeit ergibt sich aus der Verschachtelung:
{
  "id": 1,
  "standort": "Schuldach",
  "sensoren": [
    { "id": 1, "art": "Temperatur", "einheit": "°C" },
    { "id": 2, "art": "Luftfeuchte", "einheit": "%" }
  ]
}
Wann Einbetten und wann Verweisen besser ist, behandelt der Artikel NoSQL und Dokumentendatenbanken (Document Stores).
CSV, XML und JSON im Vergleich
Alle drei Formate haben einen gemeinsamen Vorteil: Sie sind offene, textbasierte Formate. Die Daten stehen im Klartext in der Datei, Sender und Empfänger können die Struktur selbst festlegen, und fast jedes Programm und jede Programmiersprache kann sie lesen und schreiben – unabhängig von Hersteller und Betriebssystem.
| Merkmal | CSV | XML | JSON |
|---|---|---|---|
| Struktur | flach: Zeilen und Spalten | hierarchisch: Elementbaum, Attribute | hierarchisch: Objekte und Arrays |
| Datentypen | keine (nur Text) | im Dokument nur Text, Typen über XSD | String, Number, Boolean, null, Array, Object |
| Overhead | sehr gering | groß | gering |
| Lesbarkeit für Menschen | gut bei wenigen Spalten | gut, aber lang | gut |
| Strukturprüfung | kaum standardisiert | DTD, XSD (sehr ausgereift) | JSON Schema |
| Kommentare | nein | ja | nein |
| Zeichenkodierung | nicht angegeben | im Prolog angegeben | UTF-8 vorgeschrieben |
| typischer Einsatz | Export/Import von Tabellen, Messwertreihen | SOAP, E-Rechnung, Branchenstandards | REST-APIs, IoT, Konfiguration |
Vorteile von JSON gegenüber XML: kürzer, dadurch weniger Datenvolumen; ohne Endtags schneller zu lesen und zu verarbeiten; eingebaute Arrays und Datentypen; in JavaScript direkt als Objekt nutzbar; Standard bei Web-APIs. Im Beispiel oben braucht die XML-Fassung ohne Einrückungen und Zeilenumbrüche 385 Zeichen, die JSON-Fassung 242 (obwohl sie zusätzlich den Standort enthält) und die CSV-Fassung nur 121 (einschließlich der zwei nötigen Zeilenumbrüche).
Vorteile von XML: sehr hoher Grad an Standardisierung, mächtige Werkzeuge (Schema, XSLT, XPath), Kommentare und Namensräume; viele Branchen- und Behördenformate setzen XML voraus. Nachteil: aufwendig zu erzeugen und viel Overhead.
CSV ist die beste Wahl für große Mengen gleichartiger, flacher Datensätze: Messwertreihen, Exporte aus Datenbanken, Daten für die Tabellenkalkulation. Durch den geringen Overhead entsteht wenig Datenlast bei Übertragung und Speicherung – wichtig etwa bei Sensoren mit Funkübertragung und Akku. Für verschachtelte Daten oder wenn Datentypen erhalten bleiben sollen, ist JSON besser geeignet.
Welches Format wofür?
Bei der Auswahl helfen diese Fragen:
Sind die Daten flach oder verschachtelt? Flache Tabellen → CSV; Objekte mit Listen (Bestellung mit Positionen) → JSON oder XML.
Was erwartet die Gegenseite? Eine REST-API erwartet meist JSON, ein SOAP-Webservice oder eine E-Rechnung XML, eine Tabellenkalkulation CSV.
Wie wichtig sind Datenmenge und Geschwindigkeit? Bei vielen Datensätzen oder schmaler Leitung zählt geringer Overhead (CSV, JSON).
Muss die Struktur streng geprüft werden? Dann XML mit XSD oder JSON mit JSON Schema.
Die Fragen lassen sich als Entscheidungshilfe zusammenfassen:

Office- oder Druckformate wie DOCX, XLSX oder PDF sind keine Datenaustauschformate: Sie beschreiben Layout und Darstellung, sind binär und lassen sich nur mit passender Software zuverlässig auslesen. Eine „CSV-Datei“, die als PDF geliefert wird, kann kein Programm automatisch einlesen.
Typische Fehler
CSV: Trennzeichen innerhalb einer Datei gemischt (Komma und Semikolon); Werte mit Trennzeichen nicht in Anführungszeichen gesetzt; uneinheitliches Datumsformat (
15.02.2024und02.15.2024); ungültige Zeichen in Zahlenfeldern (20#); Dezimalkomma bei Komma als Trennzeichen; falscher Dateityp (PDF statt CSV).XML: nicht wohlgeformt, z. B. fehlendes oder falsch geschriebenes Endtag (
<employees>statt</employees>), mehr als ein Wurzelelement, Attributwerte ohne Anführungszeichen, Groß- und Kleinschreibung bei Tags nicht beachtet.JSON: einfache statt doppelter Anführungszeichen, Komma nach dem letzten Element, Kommentare, Zahlen oder Wahrheitswerte unnötig in Anführungszeichen (
"81","true"), Datumswerte ohne vereinbartes Format.Kodierung: Datei in UTF-8 gespeichert, aber als Windows-1252 eingelesen (oder umgekehrt) – Umlaute werden zu Zeichensalat.
Leitfragen
- Worin unterscheidet sich eine Textdatei (z. B. im ASCII-Format) von einer Binärdatei?
Eine Textdatei speichert nur Zeichen einer Zeichenkodierung und lässt sich mit jedem Texteditor lesen und bearbeiten. Eine Binärdatei speichert die Daten im internen Format eines Programms (z. B. Zahlen als Gleitkommawerte, komprimierte Bilddaten) und kann nur mit passender Software verarbeitet werden – siehe Abschnitt „Textformat oder Binärformat?“.
- Wie gehst Du vor, wenn Du Daten in einem unbekannten Dateiformat erhältst?
Informationen beschaffen (Websuche, Spezifikation, Hersteller oder Absender, Foren, Fachliteratur), in die Datei schauen (Texteditor, Hex-Editor, Dateisignatur) und die Daten über Import- oder Exportfunktionen, einen Konverter oder ein eigenes Skript in ein nutzbares Format bringen – siehe Abschnitt „Unbekannte Dateiformate einordnen und umwandeln“.
- Wie ändert sich der Speicherbedarf eines Textes, wenn statt ASCII UTF-8 oder UTF-16 verwendet wird?
Besteht der Text nur aus ASCII-Zeichen, bleibt der Speicherbedarf mit UTF-8 gleich (1 Byte je Zeichen), mit UTF-16 verdoppelt er sich ungefähr (2 Byte je Zeichen). Umlaute brauchen in UTF-8 2 Byte, in UTF-16 ebenfalls 2 Byte; ASCII kann sie gar nicht darstellen – siehe Abschnitt „Zeichenkodierung: ASCII, Unicode, UTF-8 und UTF-16“.
- Welche charakteristischen Merkmale haben CSV, XML und JSON, und welchen Vorteil haben alle drei gemeinsam?
CSV ist eine flache Textdatei mit einem Datensatz je Zeile und Trennzeichen zwischen den Feldern; XML ist ein hierarchischer Elementbaum mit Start- und Endtags; JSON besteht aus verschachtelbaren Objekten in geschweiften und Arrays in eckigen Klammern mit eigenen Datentypen. Gemeinsam ist ihnen, dass sie offene Textformate sind, deren Inhalt im Klartext lesbar ist und die fast jedes Programm verarbeiten kann – siehe Abschnitt „CSV, XML und JSON im Vergleich“.
- Welche Datentypen kennt JSON, und woran erkennst Du sie?
String (in doppelten Anführungszeichen), Number (ganze Zahl oder Kommazahl mit Dezimalpunkt, ohne Anführungszeichen), Boolean (true/false), null, Array ([ ]) und Object ({ }). Einen Datumstyp gibt es nicht – siehe Abschnitt „Datentypen in JSON bestimmen“.
- Wie wandelst Du die Zeilen einer Tabelle in JSON um, und wann bettest Du Daten ein?
Jede Zeile wird ein Objekt, jede Spalte ein Schlüssel, alle Zeilen zusammen bilden ein Array. Werden zusammengehörige Daten meist gemeinsam gelesen und ist ihre Anzahl begrenzt, bettest Du sie als Array in das übergeordnete Objekt ein; der Fremdschlüssel entfällt dann – siehe Abschnitt „Tabellen in JSON umwandeln“.
- Wann ist CSV, wann JSON und wann XML die bessere Wahl?
CSV für große Mengen flacher, gleichartiger Datensätze mit wenig Overhead (Messwerte, Tabellenexporte); JSON für verschachtelte Daten mit Datentypen, vor allem bei REST-APIs und IoT; XML, wenn strenge Prüfung per Schema, Kommentare oder ein vorgegebener Standard (SOAP, E-Rechnung) nötig sind. Office- und Druckformate wie DOCX oder PDF eignen sich nicht – siehe Abschnitt „Welches Format wofür?“.
- Welche typischen Fehler machen eine CSV-Datei für ein Programm unlesbar?
Gemischte Trennzeichen, uneinheitliche Datumsformate, ungültige Zeichen in Zahlenfeldern, nicht maskierte Trennzeichen in Werten, eine nicht vereinbarte Zeichenkodierung oder ein falscher Dateityp wie PDF – siehe Abschnitt „Typische Fehler“.
Links und weitere Informationen
als Nachschlagewerk: RFC 8259: The JavaScript Object Notation (JSON) Data Interchange Format
als Nachschlagewerk: RFC 4180: Common Format and MIME Type for Comma-Separated Values (CSV) Files
als Nachschlagewerk: W3C: Extensible Markup Language (XML) 1.0
als Nachschlagewerk: The Unicode Standard
Hinweis zur Nachnutzung als Open Educational Resource (OER)
Dieser Artikel und seine Texte, Bilder, Grafiken, Code und sonstiger Inhalt sind - sofern nicht anders angegeben - lizenziert unter CC BY 4.0. Nennung gemäß TULLU-Regel bitte wie folgt: “Datenaustauschformate: CSV, XML und JSON vergleichen” von oer-informatik.de (H. Stein), Lizenz: CC BY 4.0. Der Artikel wurde unter https://oer-informatik.de/datenaustauschformate veröffentlicht, die Quelltexte sind in weiterverarbeitbarer Form verfügbar im Repository unter https://gitlab.com/oer-informatik/datenformate/xml. Erstellt mit KI-Assistenz; von mir umfassend redaktionell überarbeitet, geprüft und freigegeben. Stand: 28.10.2026.
[Kommentare zum Artikel lesen, schreiben] / [Artikel teilen] / [gitlab-Issue zum Artikel schreiben]