Hochverfügbarkeit: Ausfallzeiten berechnen, Redundanz planen
https://bildung.social/@oerinformatik/
https://oer-informatik.de/hochverfuegbarkeit
Hochverfügbarkeit, Verfügbarkeit, Ausfallzeit, Single Point of Failure, Redundanz, Failover-Cluster, Load Balancer, Skalierung, RTO, RPO, MTBF, Verfügbarkeitsklassen
tl/dr; (ca. 17 min Lesezeit): Wie lange darf ein Dienst bei 99,9 % Verfügbarkeit ausfallen, und wie erreicht man überhaupt so hohe Werte? Der Artikel zeigt, wie Du Ausfallzeiten, Verfügbarkeitsklassen und die Gesamtverfügbarkeit verketteter und redundanter Komponenten berechnest, Single Points of Failure findest und mit Redundanz, Failover-Cluster, Lastverteilung und Skalierung beseitigst und RTO und RPO für die Wiederherstellung festlegst [AI-Assisted]. (Zuletzt geändert am 28.10.2026)
Schon fit in diesem Thema? Nutze die Kann-Liste und die Leitfragen unter dem Artikel als Checkliste, ob Du die relevanten Kompetenzen bereits hast.
Dieser Artikel baut auf der Kann-Liste des Artikels RAID auf.
Als Grundlagen der Hochverfügbarkeit kann ich nach Durchlesen des Artikels…
… Verfügbarkeit und Zuverlässigkeit unterscheiden und Anforderungen an beide für ein IT-System formulieren.
… aus einer Verfügbarkeit die zulässige Ausfallzeit für einen Zeitraum berechnen (und umgekehrt), Verfügbarkeitsklassen zuordnen und Aussagen dazu rechnerisch prüfen.
… die Gesamtverfügbarkeit von in Reihe und parallel geschalteten Komponenten berechnen.
… Single Points of Failure in einer IT-Infrastruktur erkennen und mit redundanten Komponenten, Anbindungen und Standorten beseitigen.
… die Funktionsweise von Failover-Cluster (mit Heartbeat) und Load Balancer erläutern und Verfahren der Lastverteilung unterscheiden.
… RTO und RPO erläutern und daraus Anforderungen an Datensicherung und Wiederherstellung ableiten.
… MTBF, MTTF und MTTR erläutern, die Verfügbarkeit daraus berechnen und Maßnahmen gegen Früh- und Verschleißausfälle begründen.
… horizontale und vertikale Skalierung sowie Blue-Green-Deployment beschreiben und den möglichen Umsatzverlust durch Ausfälle berechnen.
Ein Onlineshop, der am Samstagabend nicht erreichbar ist, verliert Bestellungen. Ein Check-in-System, das zu Beginn einer Konferenz ausfällt, erzeugt lange Schlangen. Und eine Leitstelle, deren Server stehen, kann im Notfall nicht helfen. Wie viel Ausfall ein Dienst verträgt, hängt also davon ab, wofür er gebraucht wird. Hochverfügbarkeit heißt, ein System so zu bauen und zu betreiben, dass es auch dann weiterläuft, wenn einzelne Teile ausfallen. Dafür muss man zuerst rechnen können – und dann wissen, an welchen Stellen Redundanz wirklich hilft.

Verfügbarkeit, Zuverlässigkeit, Ausfallsicherheit
Verfügbarkeit (availability) ist der Anteil der vereinbarten Betriebszeit, in der ein System nutzbar ist. Sie ist eines der drei Schutzziele der Informationssicherheit (neben Vertraulichkeit und Integrität).
Zuverlässigkeit (reliability) beschreibt, wie selten ein System ausfällt bzw. wie lange es im Mittel störungsfrei läuft. Ein System kann sehr zuverlässig sein (selten Ausfälle), aber trotzdem eine schlechte Verfügbarkeit haben, wenn jede Reparatur tagelang dauert.
Ausfallsicherheit bzw. Resilienz bedeutet, dass ein System Störungen einzelner Komponenten verkraftet und weiterarbeitet – meist durch Redundanz.
Für ein Kassensystem könnte man z. B. formulieren: Zuverlässigkeit – höchstens ein Ausfall pro Quartal, Belege werden nie doppelt oder gar nicht gebucht; Verfügbarkeit – während der Öffnungszeiten zu 99,9 % nutzbar.
Verfügbarkeit und Ausfallzeit berechnen
Die Verfügbarkeit V ist das Verhältnis aus tatsächlicher Betriebszeit und vereinbarter Gesamtzeit:
V = \dfrac{t_{\text{Gesamt}} - t_{\text{Ausfall}}}{t_{\text{Gesamt}}} \qquad \Leftrightarrow \qquad t_{\text{Ausfall}} = (1 - V) \cdot t_{\text{Gesamt}}
Entscheidend ist der Bezugszeitraum: Ein Jahr im 24/7-Betrieb hat 365 \cdot 24\,\mathrm{h} = 8.760\,\mathrm{h}, ein Monat mit 30 Tagen 720\,\mathrm{h}. Ist nur eine Servicezeit vereinbart (z. B. Mo–Fr 8–18 Uhr), wird nur diese Zeit gerechnet.
Beispiel: Wie lange darf ein Dienst mit 99,9 % Verfügbarkeit im Jahr ausfallen?
Geg.: V = 99{,}9\,\% = 0{,}999, t_{\text{Gesamt}} = 8.760\,\mathrm{h}
Ges.: t_{\text{Ausfall}}
t_{\text{Ausfall}} = (1 - 0{,}999) \cdot 8.760\,\mathrm{h} = \underline{\underline{8{,}76\,\mathrm{h}}} = 8\,\mathrm{h}\;45{,}6\,\mathrm{min}
Umrechnen in Stunden und Minuten: 0{,}76\,\mathrm{h} \cdot 60\,\frac{\mathrm{min}}{\mathrm{h}} = 45{,}6\,\mathrm{min}. Mit der Ausfallzeit lässt sich auch der tolerierte Umsatzverlust abschätzen: Erwirtschaftet ein Onlineshop 600 € Umsatz je Stunde, kosten 8,76 Stunden Ausfall rund 5.256 € im Jahr.
| Verfügbarkeit | Ausfallzeit je Jahr (8.760 h) | Ausfallzeit je Monat (720 h) | Verfügbarkeitsklasse (BSI) |
|---|---|---|---|
| 99 % („zwei Neunen“) | 87,6 h ≈ 3 d 15 h 36 min | 7,2 h | VK 1 |
| 99,5 % | 43,8 h | 3,6 h | – |
| 99,9 % („drei Neunen“) | 8,76 h ≈ 8 h 46 min | 43,2 min | VK 2 |
| 99,99 % („vier Neunen“) | 52,56 min | 4,32 min | VK 3 |
| 99,999 % („fünf Neunen“) | 5,26 min | 26 s | VK 4 |
Das Bundesamt für Sicherheit in der Informationstechnik (BSI) unterscheidet in seinem Hochverfügbarkeits-Kompendium Verfügbarkeitsklassen von VK 0 (keine zugesicherte Verfügbarkeit) bis VK 5 (keine Ausfälle tolerierbar). Ab 99,99 % spricht man in der Regel von Hochverfügbarkeit. Um herauszufinden, welche Klasse ein System erreicht, rechnest Du die tatsächliche Ausfallzeit in eine Verfügbarkeit um: 3 Tage und 6 Stunden Ausfall im Jahr sind 78 Stunden, also V = \frac{8.760 - 78}{8.760} \approx 99{,}110\,\% – das reicht für VK 1, nicht für VK 2.
Typische Fehler: falscher Bezugszeitraum (Monat statt Jahr), 99,9 % mit 0,999 verwechselt (Ausfallanteil ist 0,1 % = 0,001), Stunden-Dezimalstellen als Minuten gelesen (8,76 h sind nicht 8 h 76 min). Wird eine Aussage geprüft („99,99 % heißt höchstens eine Stunde Ausfall im Monat“), rechnest Du den richtigen Wert aus und urteilst klar: Erlaubt sind nur 4,32 Minuten, die Aussage ist falsch.
MTBF, MTTF und MTTR
Hersteller geben die Zuverlässigkeit ihrer Geräte als Mittelwerte an:
MTTF (Mean Time To Failure): mittlere Betriebszeit bis zum Ausfall – für Teile, die nicht repariert, sondern getauscht werden (z. B. Festplatten).
MTBF (Mean Time Between Failures): mittlere Betriebszeit zwischen zwei Ausfällen eines reparierbaren Systems.
MTTR (Mean Time To Repair/Restore): mittlere Zeit bis zur Wiederherstellung nach einem Ausfall.
V = \dfrac{\text{MTBF}}{\text{MTBF} + \text{MTTR}}
Ein System mit einer MTBF von 2.000 Stunden und einer MTTR von 4 Stunden hat also V = \frac{2.000}{2.004} \approx 99{,}800\,\%. Die Formel zeigt: Verfügbarkeit steigt nicht nur durch seltenere Ausfälle, sondern auch durch schnellere Wiederherstellung (Ersatzteile vor Ort, Hot-Swap, Rufbereitschaft, automatisches Failover).
Eine MTTF von 100.000 Stunden bedeutet nicht, dass jedes Gerät 100.000 Stunden (rund 11,4 Jahre) hält. Es ist ein statistischer Mittelwert über viele Geräte: Bei 1.000 Festplatten im Dauerbetrieb ist im Mittel alle 100 Stunden mit einem Ausfall zu rechnen. Für die geplante Einsatzdauer ist die Angabe ein Hinweis auf die Qualität, aber keine Garantie.

Über die Lebensdauer folgt die Ausfallrate oft der Badewannenkurve. Frühausfälle begegnest Du mit einem Einbrenntest (Burn-in) vor dem produktiven Einsatz, mit Garantietausch und indem Du in einem RAID nicht nur Platten derselben Charge verbaust. Verschleißausfällen begegnest Du mit Überwachung (z. B. S.M.A.R.T.-Werte von Festplatten), mit vorbeugendem Austausch nach einer festgelegten Betriebszeit und mit Hot-Spare-Platten, die sofort einspringen.
Verfügbarkeit verketteter und redundanter Komponenten
Ein Dienst besteht aus vielen Komponenten: Stromversorgung, Internetanbindung, Firewall, Switch, Server, Datenbank. Wie sich ihre Verfügbarkeiten zusammensetzen, hängt davon ab, ob sie alle gebraucht werden oder ob eine von mehreren genügt.

Reihenschaltung: Der Dienst funktioniert nur, wenn alle Komponenten funktionieren. Die Verfügbarkeiten werden multipliziert; die Gesamtverfügbarkeit ist kleiner als die schlechteste einzelne: V_{\text{ges}} = V_1 \cdot V_2 \cdot \ldots \cdot V_n.
Parallelschaltung (Redundanz): Der Dienst funktioniert, solange mindestens eine Komponente funktioniert. Multipliziert werden die Ausfallwahrscheinlichkeiten, das Ergebnis wird von 1 abgezogen; die Gesamtverfügbarkeit ist größer als die beste einzelne: V_{\text{ges}} = 1 - (1 - V_1) \cdot (1 - V_2).
Zwei Internetanbindungen mit je 99 % ergeben so 1 - 0{,}01 \cdot 0{,}01 = 99{,}99\,\%. Die Rechnung setzt voraus, dass die Ausfälle unabhängig voneinander sind. Liegen beide Leitungen im selben Kabelkanal oder hängen am selben Verteiler des Providers, fallen sie beim Bagger gemeinsam aus – die Redundanz ist dann nur scheinbar.
Single Points of Failure finden und beseitigen
Ein Single Point of Failure (SPoF) ist eine Komponente, deren Ausfall allein das ganze System lahmlegt, weil sie nicht redundant vorhanden ist. Um SPoFs zu finden, gehst Du den Weg eines Zugriffs vom Nutzenden bis zu den Daten durch und fragst an jeder Station: Was passiert, wenn genau das ausfällt? SPoFs liegen oft außerhalb des Rechenzentrums: die einzige Internetleitung, der Router des Providers, ein einzelner DNS-Server, die Stromversorgung des Gebäudes – oder die eine Person, die als einzige das Passwort kennt.
| Bereich | typischer SPoF | Maßnahme |
|---|---|---|
| Strom | ein Netzteil, ein Stromkreis, Netzausfall | redundante Netzteile an getrennten Stromkreisen, USV, Netzersatzanlage (Notstromaggregat) |
| Speicher | einzelne Festplatte | RAID mit Hot-Spare, Replikation auf ein zweites Speichersystem |
| Server | einzelner Server | Failover-Cluster, virtuelle Maschinen mit Hochverfügbarkeitsfunktion |
| Netzwerk | ein Switch, eine Verbindung | zwei Switches, doppelte Verbindungen mit Link Aggregation, Spanning Tree gegen Schleifen |
| Gateway | ein Router | zwei Router mit gemeinsamer virtueller IP (VRRP) |
| Internet | eine Leitung, ein Provider | zweite Anbindung mit anderer Technik (z. B. Glasfaser und 5G) und anderer Trasse, bei einem anderen Provider |
| Gebäude | ein Serverraum | zweiter Brandabschnitt oder zweiter Standort, redundante Klimatisierung |
| Organisation | eine Person, fehlende Dokumentation | Vertretung, Notfallhandbuch, dokumentierte Zugänge |
Bei Servern erhöhen außerdem ECC-Arbeitsspeicher (erkennt und korrigiert Bitfehler), im laufenden Betrieb tauschbare (Hot-Swap) Festplatten und Netzteile sowie ein Fernwartungszugang (z. B. IPMI) die Verfügbarkeit. Wichtig: Redundanz schützt vor dem Ausfall von Hardware, nicht vor gelöschten oder verschlüsselten Daten – sie ersetzt keine Datensicherung. Wie RAID funktioniert, erklärt der Artikel RAID.
Eine USV überbrückt nur einen Stromausfall. Fällt dagegen das einzige Netzteil eines Servers aus, hilft sie nicht – deshalb sind redundante Netzteile auch mit USV sinnvoll, idealerweise an zwei getrennten Stromkreisen bzw. zwei USV.
Failover-Cluster: Wenn ein Server ausfällt, übernimmt ein anderer
Ein Failover-Cluster besteht aus mindestens zwei Servern (Knoten, nodes), die denselben Dienst bereitstellen können. Fällt ein Knoten aus, übernimmt ein anderer automatisch (Failover); Nutzende merken davon im Idealfall nur eine kurze Unterbrechung.
Aktiv/Passiv: Ein Knoten arbeitet, der andere wartet im Bereitschaftsbetrieb (Standby).
Aktiv/Aktiv: Alle Knoten arbeiten und teilen sich die Last; fällt einer aus, tragen die übrigen seine Last mit.
Wie merkt ein Cluster, dass ein Knoten ausgefallen ist? Jeder Knoten sendet in kurzen Abständen ein Lebenszeichen, den Heartbeat, meist über ein eigenes Netz. Bleibt der Heartbeat aus, startet der Cluster den Failover. Voraussetzungen sind u. a. mindestens zwei Knoten mit gleicher Software und Konfiguration, ein gemeinsamer oder replizierter Speicher, damit der übernehmende Knoten dieselben Daten hat, eine zuverlässige Verbindung für den Heartbeat und eine Regel, die verhindert, dass nach einer Netztrennung beide Hälften glauben, sie seien allein übrig (Split Brain) – meist eine Mehrheitsentscheidung (Quorum).
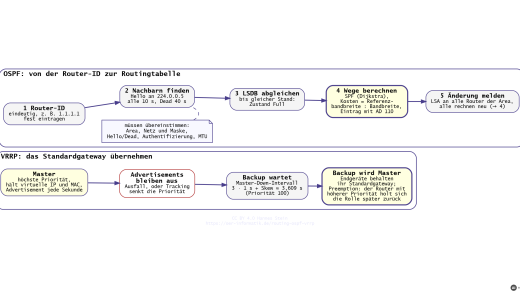
Das gleiche Prinzip gibt es für das Standard-Gateway: Mit einem First-Hop-Redundanzprotokoll wie VRRP teilen sich zwei Router eine virtuelle IP-Adresse, die die Endgeräte als Gateway eingetragen haben. Fällt der aktive Router aus, übernimmt der andere die virtuelle Adresse. Details: OSPF und Gateway-Redundanz in der Praxis.
Lastverteilung: Der Load Balancer
Ein Load Balancer nimmt alle Anfragen an einen Dienst entgegen und verteilt sie auf mehrere gleichartige Server. Das verbessert die Leistung (kein Server wird überlastet), die Skalierbarkeit (weitere Server lassen sich hinzufügen) und die Verfügbarkeit: Mit regelmäßigen Prüfungen (Health Checks) erkennt der Load Balancer, wenn ein Server nicht antwortet, und schickt ihm keine Anfragen mehr. Der Load Balancer selbst darf dabei kein SPoF sein – er wird deshalb meist doppelt betrieben.
| Verfahren | Prinzip | geeignet, wenn … |
|---|---|---|
| Round Robin | Anfragen der Reihe nach: Server 1, 2, 3, dann wieder 1 | alle Server gleich stark und Anfragen ähnlich aufwendig sind |
| gewichtetes Round Robin | stärkere Server erhalten anteilig mehr Anfragen | Server unterschiedlich leistungsfähig sind |
| Least Connections | der Load Balancer zählt die offenen Verbindungen je Server und wählt den am wenigsten belegten | Verbindungen unterschiedlich lange dauern |
| Least Response Time | neue Anfrage an den Server, der zuletzt am schnellsten geantwortet hat (oft kombiniert mit der Zahl aktiver Verbindungen) | die Leistung der Server schwankt, z. B. bei geteilten Cloud-Servern |
| Hash-Verfahren | aus einem Merkmal der Anfrage (Client-IP-Adresse, URL) wird ein Hashwert gebildet, der den Server festlegt (z. B. Rest der Division durch die Serveranzahl) | gleiche Anfragen immer beim selben Server landen sollen, etwa wegen eines Caches |
| Sitzungsbindung (Sticky Session) | der Load Balancer merkt sich in einem Cookie, welcher Server die Sitzung bedient, und schickt alle weiteren Anfragen des Browsers dorthin | Sitzungsdaten (Anmeldung, Warenkorb) nur auf einem Server liegen; fällt er aus, ist die Sitzung verloren |
Failover oder Load Balancing? Beim Failover springt ein Ersatzsystem erst ein, wenn das aktive ausfällt. Beim Load Balancing arbeiten alle Systeme gleichzeitig; ein Ausfall verringert nur die Kapazität.
Skalierung und Updates ohne Ausfall
Wächst die Last, kann ein System auf zwei Arten mitwachsen:
Vertikale Skalierung (scale up): Ein Server bekommt mehr Ressourcen – mehr CPU-Kerne, mehr Arbeitsspeicher, schnellere Speicher. Einfach, aber begrenzt, oft mit Neustart verbunden, und der Server bleibt ein SPoF.
Horizontale Skalierung (scale out): Es kommen weitere gleichartige Server hinzu, die sich die Last über einen Load Balancer teilen. Nahezu beliebig erweiterbar, in der Cloud auch automatisch nach Last – die Anwendung muss aber dafür gebaut sein (z. B. Sitzungsdaten zentral speichern).
Auch Updates verursachen Ausfälle. Beim Blue-Green-Deployment gibt es zwei gleiche Produktionsumgebungen: Eine („blau“) ist live, auf der anderen („grün“) wird die neue Version installiert und getestet. Ist alles in Ordnung, schaltet der Load Balancer auf die grüne Umgebung um. Treten Fehler auf, wird einfach zurückgeschaltet; die alte Umgebung dient bis dahin als Rückfallebene.
RTO und RPO: Wie schnell und mit welchem Datenstand?
Fällt ein System trotz aller Vorsorge aus, legen zwei Kennzahlen fest, was tolerierbar ist:
RTO (Recovery Time Objective): die maximal tolerierbare Zeit, bis ein System nach einem Ausfall wieder läuft – „Wie lange dürfen wir offline sein?“
RPO (Recovery Point Objective): der maximal tolerierbare Datenverlust, gemessen als Zeitspanne zwischen der letzten Sicherung und dem Ausfall – „Wie viele Daten dürfen wir verlieren?“
Aus dem RPO folgt das Sicherungsverfahren: Wird nur nachts gesichert, können bis zu 24 Stunden Daten verloren gehen. Ein RPO von 15 Minuten erfordert häufige Sicherungen der Transaktionsprotokolle oder eine laufende Replikation. Aus dem RTO folgt, wie schnell wiederhergestellt werden muss: Ein RTO von einer Stunde schafft man nicht mit dem Zurückspielen von Bändern, sondern nur mit Standby-Systemen oder Failover.
Leitfragen
- Wie berechnest Du die zulässige Ausfallzeit für eine vereinbarte Verfügbarkeit?
Ausfallzeit = (1 − Verfügbarkeit) · Gesamtzeit des Bezugszeitraums, z. B. (1 − 0,999) · 8.760 h = 8,76 h im Jahr. Achte auf den Bezugszeitraum (Jahr, Monat, Servicezeit) und rechne Dezimalstunden richtig in Minuten um. siehe Abschnitt „Verfügbarkeit und Ausfallzeit berechnen“
- Wie unterscheiden sich Verfügbarkeit und Zuverlässigkeit?
Verfügbarkeit ist der Anteil der Zeit, in der ein System nutzbar ist; Zuverlässigkeit beschreibt, wie selten es ausfällt. Ein System mit seltenen, aber langen Ausfällen ist zuverlässig, aber schlecht verfügbar. siehe Abschnitt „Verfügbarkeit, Zuverlässigkeit, Ausfallsicherheit“
- Wie berechnest Du die Gesamtverfügbarkeit von Komponenten in Reihe und parallel?
In Reihe werden die Verfügbarkeiten multipliziert (Ergebnis kleiner als die schlechteste Komponente). Parallel werden die Ausfallwahrscheinlichkeiten multipliziert und von 1 abgezogen (Ergebnis größer als die beste Komponente), sofern die Ausfälle unabhängig sind. siehe Abschnitt „Verfügbarkeit verketteter und redundanter Komponenten“
- Was ist ein Single Point of Failure, und wie beseitigst Du ihn?
Eine Komponente, deren Ausfall allein das System lahmlegt, z. B. ein einzelnes Netzteil, ein Switch, die einzige Internetleitung oder eine einzelne Person. Beseitigt wird er durch Redundanz: doppelte Komponenten, Cluster, zweite Anbindung mit anderer Technik und Trasse, zweiter Standort, Vertretungen. siehe Abschnitt „Single Points of Failure finden und beseitigen“
- Wie arbeitet ein Failover-Cluster, und welche Rolle spielt der Heartbeat?
Mehrere Knoten können denselben Dienst bereitstellen; fällt einer aus, übernimmt ein anderer automatisch. Jeder Knoten sendet regelmäßig einen Heartbeat; bleibt er aus, startet der Failover. Voraussetzungen sind u. a. gleiche Konfiguration, gemeinsamer oder replizierter Speicher und ein Quorum gegen Split Brain. siehe Abschnitt „Failover-Cluster“
- Welches Verteilverfahren passt, wenn Anfragen unterschiedlich lange dauern, und wann braucht eine Anwendung eine Sitzungsbindung?
Dauern Anfragen unterschiedlich lange, verteilt man nach der aktuellen Auslastung: Least Connections wählt den Server mit den wenigsten offenen Verbindungen, Least Response Time den, der gerade am schnellsten antwortet. Einfaches Round Robin würde lange und kurze Anfragen blind gleich verteilen. Eine Sitzungsbindung (per Cookie oder Hash) braucht eine Anwendung, die Sitzungsdaten nur im Speicher des jeweiligen Servers hält. Besser ist es, diese Daten zentral abzulegen, dann kann jeder Server jede Anfrage beantworten. siehe Abschnitt „Lastverteilung“
- Was bedeuten RTO und RPO, und was folgt daraus für die Datensicherung?
RTO ist die maximal tolerierbare Ausfalldauer bis zur Wiederherstellung, RPO der maximal tolerierbare Datenverlust als Zeitspanne seit der letzten Sicherung. Ein kleines RPO erfordert häufige Sicherungen oder Replikation, ein kleines RTO Standby-Systeme oder Failover. siehe Abschnitt „RTO und RPO“
- Was sagen MTBF, MTTF und MTTR aus?
MTTF ist die mittlere Betriebszeit bis zum Ausfall nicht reparierbarer Teile, MTBF die mittlere Zeit zwischen Ausfällen reparierbarer Systeme, MTTR die mittlere Wiederherstellungszeit. Es gilt V = MTBF : (MTBF + MTTR); die Werte sind Mittelwerte über viele Geräte, keine Garantie für ein einzelnes. siehe Abschnitt „MTBF, MTTF und MTTR“
Links und weitere Informationen
RAID: Festplatten zusammenschalten – Grundlage für redundanten Speicher
OSPF und Gateway-Redundanz in der Praxis – VRRP im Detail
Ticketsystem und IT-Service – Verfügbarkeit im Service Level Agreement
Virtualisierung – Hochverfügbarkeit virtueller Maschinen
zum Nachschlagen: IT-Schutzziele: die Verfügbarkeit von Systemen und Daten (Verfügbarkeitsklassen des BSI)
Hinweis zur Nachnutzung als Open Educational Resource (OER)
Dieser Artikel und seine Texte, Bilder, Grafiken, Code und sonstiger Inhalt sind - sofern nicht anders angegeben - lizenziert unter CC BY 4.0. Nennung gemäß TULLU-Regel bitte wie folgt: “Hochverfügbarkeit: Ausfallzeiten berechnen, Redundanz planen” von oer-informatik.de (H. Stein), Lizenz: CC BY 4.0. Der Artikel wurde unter https://oer-informatik.de/hochverfuegbarkeit veröffentlicht, die Quelltexte sind in weiterverarbeitbarer Form verfügbar im Repository unter https://gitlab.com/oer-informatik/it-sicherheit/verfuegbarkeit-notfall. Erstellt mit KI-Assistenz; von mir umfassend redaktionell überarbeitet, geprüft und freigegeben. Stand: 28.10.2026.
[Kommentare zum Artikel lesen, schreiben] / [Artikel teilen] / [gitlab-Issue zum Artikel schreiben]