Übungsaufgaben zu Datenaustauschformaten
https://bildung.social/@oerinformatik/
https://oer-informatik.de/datenaustauschformate-uebungsaufgaben
Datenaustauschformat, CSV, XML, JSON, Zeichenkodierung, UTF-8, UTF-16, Binärformat, Datentypen, Übungsaufgaben, Prüfungsvorbereitung
tl/dr; (Bearbeitungszeit insgesamt 66 min, mehrere Aufgaben): Drei Übungsaufgaben zu Datenaustauschformaten – vom unbekannten Dateiformat über Text- und Binärdateien, CSV-, XML- und JSON-Darstellungen eines Datensatzes, Fehler in CSV-Dateien und den Speicherbedarf von UTF-8 und UTF-16 bis zu Datentypen in JSON, eingebetteten Arrays und der begründeten Formatwahl. Alle Beispiellösungen sind ausgeblendet und mit Punkteverteilung versehen [AI-Assisted]. (Zuletzt geändert am 28.10.2026)
Diese Übungsaufgaben gehören zum Artikel Datenaustauschformate: CSV, XML und JSON vergleichen. Die Regeln für wohlgeformtes und gültiges XML übst Du in den Übungsaufgaben zu XML.
Hinweise zur Bearbeitung: Bis zur Teil-1-Prüfung der IT-Berufe solltest Du die Basiskompetenz beherrschen, also Aufgabe 1.1. Als FIDP, FIDV oder ISE musst Du zur Teil-2-Prüfung Aufgaben auf Kernkompetenz-Ebene lösen können, das sind Aufgabe 2.1 und Aufgabe 2.2. Bei „nennen“ genügen Stichworte, bei „beschreiben“, „erläutern“ und „begründen“ erwartet die Aufgabe ganze Sätze mit Bezug zur Situation. Schreib Deine Lösung zuerst vollständig auf, bevor Du die Beispiellösung aufklappst.
Aufgabe 1.1: Fahrplandaten für eine Mitfahr-App (Basiskompetenz)
(ca. 13 min Bearbeitungszeit)
Du arbeitest im Projektteam der Mitfahr-App „RatzFahrt“ des Ratz und Rübe Berufskollegs (RRB) in Bielefeld mit. Oksana Melnyk, Auszubildende der Fachinformatik für Anwendungsentwicklung, möchte zu jedem Haltepunkt der App auch die nächsten Bus- und Bahnabfahrten anzeigen. Der Verkehrsverbund stellt seine Fahrplandaten als Datei fahrplan_owl.zip im Format „GTFS“ zur Verfügung. Das Format kennt im Team niemand.
a) Nenne drei Möglichkeiten, wie Du Informationen über das unbekannte Dateiformat erhalten kannst. (3 Punkte)
Je Möglichkeit 1 Punkt, zum Beispiel:
Websuche nach „GTFS“ bzw. der Dateiendung,
Dokumentation oder Spezifikation des Formats lesen (Website des Verkehrsverbunds bzw. des Formats),
beim Verkehrsverbund nachfragen,
in Fachforen oder Online-Communitys fragen,
Fachliteratur oder Handbücher nutzen,
einen KI-Chatbot fragen und die Antwort an einer verlässlichen Quelle prüfen.
b) Im Team findet ihr heraus: Die ZIP-Datei enthält mehrere Dateien mit der Endung .txt. Thomas Becker fragt, ob man die Dateien nicht einfach im Editor öffnen könne. Erläutere den Unterschied zwischen einer Datei im Textformat (ASCII) und einer Datei im Binärformat. (4 Punkte)
Textformat: Die Datei enthält nur Zeichen einer Zeichenkodierung (z. B. ASCII oder UTF-8), gegliedert durch Zeilenumbrüche. Sie lässt sich mit jedem Texteditor öffnen, lesen und bearbeiten (2 Punkte).
Binärformat: Die Datei speichert die Daten im internen Format eines Programms (z. B. Zahlen als Gleitkommawerte, komprimierte Daten). Im Editor erscheint nur Zeichensalat; lesen und verarbeiten kann sie nur ein Programm, das das Format kennt (2 Punkte).
Die ZIP-Datei selbst ist binär (komprimiert); die darin enthaltenen .txt-Dateien sind Textdateien und lassen sich nach dem Entpacken im Editor öffnen.
c) Im Projektordner liegen weitere Dateien. Ordne jeder Beschreibung das passende Dateiformat zu: CSV, ISO, JPG, PDF, TIFF, ZIP. (3 Punkte)
| Nr. | Beschreibung | Format |
|---|---|---|
| 1 | Foto eines Haltepunkts, verlustbehaftet komprimiert | |
| 2 | Abbild der kompletten Installations-DVD der Monitorsoftware | |
| 3 | Haltepunktliste als Textdatei, Werte durch Trennzeichen getrennt | |
| 4 | unterschriebene Einwilligungserklärung, druckfertig und layouttreu | |
| 5 | eingescannter Lageplan, verlustfrei gespeichert | |
| 6 | mehrere Dateien komprimiert in einem Archiv |
Je richtige Zuordnung 0,5 Punkte: 1 JPG, 2 ISO, 3 CSV, 4 PDF, 5 TIFF, 6 ZIP.
d) Die Datei stops.txt beginnt so:
stop_id,stop_name,stop_lat,stop_lon
OWL-1001,"Gütersloh, Hauptbahnhof",51.907000,8.385000
OWL-2040,"Herford, Bahnhof",52.118000,8.663000
Nenne Format und Trennzeichen der Datei und erläutere, warum der Haltestellenname in Anführungszeichen steht. (2 Punkte)
Es ist eine CSV-Datei mit dem Komma als Trennzeichen und einer Kopfzeile (1 Punkt). Der Name enthält selbst ein Komma; ohne Anführungszeichen würde es als Trennzeichen gelesen, und die Zeile hätte ein Feld zu viel. Die Anführungszeichen kennzeichnen den Wert als ein Feld (1 Punkt).
e) Nenne eine Möglichkeit, wie die Haltestellendaten in die MariaDB-Datenbank der App gelangen können. (2 Punkte)
Eine Möglichkeit genügt (2 Punkte), zum Beispiel:
Importfunktion der Datenbank nutzen, z. B.
LOAD DATA INFILEmit Komma als Trennzeichen und"als Feldbegrenzer oder den CSV-Import eines Verwaltungswerkzeugs,ein kleines Skript (z. B. in Python) schreiben, das die Datei liest, die benötigten Spalten auswählt und die Datensätze einfügt,
ein vorhandenes Werkzeug bzw. einen Konverter für GTFS-Daten verwenden.
Dabei auf die Zeichenkodierung (UTF-8) achten, damit „Gütersloh“ richtig ankommt.
Aufgabe 2.1: Sessionplan für Infomonitore und Türschilder (Kernkompetenz)
(ca. 24 min Bearbeitungszeit)
Das Ratz und Rübe Berufskolleg (RRB) veranstaltet am 13.03.2027 das Barcamp „Lernen.Digital.Leben 2027“. Die Infomonitore und die E-Ink-Türschilder vor den Räumen sollen den Sessionplan anzeigen. Die Türschilder sind kleine Mikrocontroller (ESP32) mit Akku, die ihre Daten per Funk erhalten. Emre Aksoy, Leiter des Technikteams, soll die Daten aus der Orga-Datenbank exportieren. Ein Auszug:
| beginn | raum | titel | format | livestream |
|---|---|---|---|---|
| 10:00 | A.001 | KI-Assistenten im Unterricht – was geht, was nicht? | Vortrag | ja |
| 11:00 | C.110 | Reparieren statt wegwerfen: Laptops retten | Workshop | nein |
| 12:45 | B.201 | Barrierefreie Videos: Untertitel und Gebärdensprache | Workshop | nein |
a) Beschreibe die Datenformate CSV, XML und JSON und gib jeweils zwei charakteristische Merkmale an. (6 Punkte)
Je Format 2 Punkte (1 Punkt je Merkmal), zum Beispiel:
CSV (Comma-Separated Values): Textdatei, ein Datensatz je Zeile, Felder durch ein Trennzeichen (Komma, Semikolon) getrennt, meist mit Kopfzeile; flache Struktur ohne Verschachtelung und ohne Datentypen; sehr wenig Overhead.
XML (Extensible Markup Language): textbasiertes, hierarchisches Format; Elemente mit Start- und Endtag, die Text, Attribute oder weitere Elemente enthalten; genau ein Wurzelelement; prüfbar gegen DTD oder XSD; häufig bei SOAP-Webservices und E-Rechnungen.
JSON (JavaScript Object Notation): textbasiertes, hierarchisches Format; Objekte in geschweiften Klammern mit Schlüssel-Wert-Paaren, Arrays in eckigen Klammern; eigene Datentypen (String, Number, Boolean, null); kompakt; häufig bei REST-Schnittstellen.
b)
ba) Stelle die drei Sessions im CSV-Format dar. (4 Punkte)
bb) Stelle die drei Sessions im XML-Format dar. (7 Punkte)
ba) Je Zeile 0,75 Punkte (Kopfzeile und drei Datensätze), 1 Punkt für ein einheitliches Trennzeichen:
beginn;raum;titel;format;livestream
10:00;A.001;KI-Assistenten im Unterricht – was geht, was nicht?;Vortrag;ja
11:00;C.110;Reparieren statt wegwerfen: Laptops retten;Workshop;nein
12:45;B.201;Barrierefreie Videos: Untertitel und Gebärdensprache;Workshop;nein
Mit dem Komma als Trennzeichen muss der erste Titel in Anführungszeichen stehen, weil er selbst ein Komma enthält: 10:00,A.001,"KI-Assistenten im Unterricht – was geht, was nicht?",Vortrag,ja.
bb) 1 Punkt Prolog mit Kodierung, 2 Punkte Wurzelelement, 2 Punkte je Session ein Element, 2 Punkte Daten in Kindelementen (oder Attributen):
<?xml version="1.0" encoding="UTF-8"?>
<sessionplan>
  <session>
    <beginn>10:00</beginn>
    <raum>A.001</raum>
    <titel>KI-Assistenten im Unterricht – was geht, was nicht?</titel>
    <format>Vortrag</format>
    <livestream>ja</livestream>
  </session>
  <session>
    <beginn>11:00</beginn>
    <raum>C.110</raum>
    <titel>Reparieren statt wegwerfen: Laptops retten</titel>
    <format>Workshop</format>
    <livestream>nein</livestream>
  </session>
  <session>
    <beginn>12:45</beginn>
    <raum>B.201</raum>
    <titel>Barrierefreie Videos: Untertitel und Gebärdensprache</titel>
    <format>Workshop</format>
    <livestream>nein</livestream>
  </session>
</sessionplan>
Andere wohlgeformte Strukturen sind ebenfalls richtig, z. B. <session beginn="10:00" raum="A.001" format="Vortrag" livestream="ja">KI-Assistenten …</session>.
c) Emre entscheidet, dass die Türschilder ihre Daten im CSV-Format erhalten. Begründe diese Entscheidung anhand der Eigenschaften des Formats. (2 Punkte)
CSV hat sehr wenig Overhead: Es enthält außer den Werten nur Trennzeichen und Zeilenumbrüche. Dadurch sind die zu übertragenden Datenmengen klein, die Funkübertragung ist kurz, und der Mikrocontroller kann die Zeilen mit wenig Rechenaufwand und Speicher zerlegen – das schont den Akku (2 Punkte). Da die Sessiondaten flach sind (eine Zeile je Session), braucht es keine Verschachtelung.
d) Die Türschilder speichern die Titel als Text. Erläutere, wie sich der Speicherbedarf des Titels „Barrierefreie Videos: Untertitel und Gebärdensprache“ (52 Zeichen) ändert, wenn statt UTF-8 die Kodierung UTF-16 verwendet wird. Gib den Speicherbedarf in Byte für beide Kodierungen an. (3 Punkte)
Geg.: 52 Zeichen, davon 51 ASCII-Zeichen und ein Umlaut (ä)
Ges.: Speicherbedarf in UTF-8 und UTF-16
UTF-8: ASCII-Zeichen 1 Byte, ä 2 Byte: 51 \cdot 1\,\text{Byte} + 1 \cdot 2\,\text{Byte} = \underline{\underline{53\,\text{Byte}}} (1 Punkt)
UTF-16: jedes dieser Zeichen 2 Byte: 52 \cdot 2\,\text{Byte} = \underline{\underline{104\,\mathrm{Byte}}} (1 Punkt)
Der Speicherbedarf verdoppelt sich ungefähr, weil UTF-16 auch für die ASCII-Zeichen 2 Byte braucht; UTF-8 kommt bei überwiegend lateinischen Texten mit fast einem Byte je Zeichen aus (1 Punkt). In reinem ASCII ließe sich der Titel gar nicht speichern, weil ASCII kein „ä“ kennt.
e) Für den Check-in hat Mia Schröder die Anmeldungen exportiert und Emre die Datei anmeldungen.pdf geschickt. Der Inhalt sieht so aus:
vorname;nachname;ticketart;angemeldet_am
Ute;Zimmer;Lehrkraft;12.01.2027
Marco;Brenner,Gast;2027-01-14
Hannah;Klein;Schüler*in;14.01.2027
Fatma;Öztürk;Schüler*in;31.02.2027
Die Check-in-Software kann die Daten nicht einlesen. Erkläre vier Fehler. (4 Punkte)
Je erklärter Fehler 1 Punkt:
Dateityp: Die Daten liegen als PDF statt als CSV-Datei vor; ein PDF ist ein Druckformat und kann nicht als CSV eingelesen werden.
Trennzeichen: In der Zeile von Marco Brenner steht zwischen Nachname und Ticketart ein Komma statt eines Semikolons; die Zeile hat dadurch nur drei statt vier Felder.
Datumsformat: Das Datum ist uneinheitlich (
2027-01-14stattTT.MM.JJJJwie in den übrigen Zeilen).Ungültiger Wert: Den 31.02.2027 gibt es nicht.
Zeichenkodierung: „Öztürk“ zeigt, dass die Datei in UTF-8 gespeichert, aber als Windows-1252 gelesen wurde; richtig ist „Öztürk“. Die Kodierung muss vereinbart werden.
Aufgabe 2.2: Die Schloss-Schnittstelle eines Fahrrad-Onlineshops (Kernkompetenz)
(ca. 29 min Bearbeitungszeit)
Die CSB-Rad GmbH in Bielefeld verkauft Fahrräder mit gleichschließenden Schlössern: Rahmen- und Bügelschloss lassen sich mit demselben Schlüssel öffnen. Die Schlösser fertigt die Lipper SchließTec KG in Lemgo; Bestellungen und Rückmeldungen laufen über eine REST-Schnittstelle mit JSON-Dokumenten. Du unterstützt Geschäftsführer Cem Sarıkaya bei der Anbindung.
a) Nach einer Bestellung sendet Lipper SchließTec folgende Antwort:
{
  "auftragsnummer": "LST-2026-04417",
  "bestaetigt": true,
  "anzahlSchluessel": 3,
  "stueckpreisNetto": 24.9,
  "gewichteKg": [1.35, 0.42],
  "liefertermin": "2026-11-18",
  "hinweis": null,
  "positionen": [
    { "artikel": "Bügelschloss Urban 270", "menge": 1 },
    { "artikel": "Rahmenschloss Cargo", "menge": 1 }
  ]
}
Vervollständige die Tabelle anhand des JSON-Dokuments. Zur Auswahl stehen die Datentypen String, Boolean, UInteger, Double, Float-Array, Objekt-Array und null. (8 Punkte)
| Attribut | Datentyp | Inhalt |
|---|---|---|
| auftragsnummer | String | |
| Boolean | true | |
| anzahlSchluessel | ||
| stueckpreisNetto | 24.9 | |
| [1.35, 0.42] | ||
| liefertermin | ||
| hinweis | ||
| positionen |
Je richtige Zeile 1 Punkt:
| Attribut | Datentyp | Inhalt |
|---|---|---|
| auftragsnummer | String | LST-2026-04417 |
| bestaetigt | Boolean | true |
| anzahlSchluessel | UInteger | 3 |
| stueckpreisNetto | Double | 24.9 |
| gewichteKg | Float-Array | [1.35, 0.42] |
| liefertermin | String | 2026-11-18 |
| hinweis | null | null (kein Hinweis) |
| positionen | Objekt-Array | zwei Objekte mit artikel und menge |
Achtung: liefertermin ist ein String, denn JSON hat keinen Datumstyp; das Format (ISO 8601) muss vereinbart sein. Für stueckpreisNetto ist auch Float vertretbar; Geldbeträge werden im Programm oft als Dezimaltyp verarbeitet, um Rundungsfehler zu vermeiden.
b) Für die Schließanlage der Kundin Chiamaka Okafor-Schmidt sind in der Datenbank zwei Schlösser gespeichert:
| schloss_id | schliessanlage_id | art | modell |
|---|---|---|---|
| 1 | 1 | Bügelschloss | Urban 270 |
| 2 | 1 | Rahmenschloss | Cargo |
Zur Schließanlage 1 gehören der Code VS-7Q4K2M9 und 3 Schlüssel.
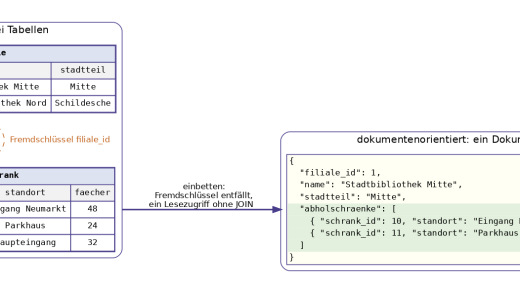
ba) Wandle die beiden Zeilen der Tabelle schloss in ein JSON-Array um. (4 Punkte)
bb) Auf die Schlösser wird fast immer zusammen mit ihrer Schließanlage zugegriffen, und eine Schließanlage hat nur wenige Schlösser. Erstelle ein JSON-Dokument für die Schließanlage 1, in das die Schlösser als Array eingebettet sind. (6 Punkte)
ba) 1 Punkt Array, je Objekt 1,5 Punkte (Schlüssel in doppelten Anführungszeichen, Zahlen ohne Anführungszeichen):
[
  { "schloss_id": 1, "schliessanlage_id": 1, "art": "Bügelschloss", "modell": "Urban 270" },
  { "schloss_id": 2, "schliessanlage_id": 1, "art": "Rahmenschloss", "modell": "Cargo" }
]
bb) 2 Punkte für das äußere Objekt mit den Daten der Schließanlage, 2 Punkte für das eingebettete Array, 2 Punkte für die Schloss-Objekte:
{
  "schliessanlage_id": 1,
  "code": "VS-7Q4K2M9",
  "anzahl_schluessel": 3,
  "schloesser": [
    { "schloss_id": 1, "art": "Bügelschloss", "modell": "Urban 270" },
    { "schloss_id": 2, "art": "Rahmenschloss", "modell": "Cargo" }
  ]
}
Der Fremdschlüssel schliessanlage_id in den Schloss-Objekten kann entfallen, weil sich die Zugehörigkeit aus der Verschachtelung ergibt; er darf aber auch stehen bleiben.
c) Der Zweckverband Radwege OWL möchte für seine Dienstfahrräder jeden Monat eine Übersicht der ausgegebenen Schlüssel erhalten, die er automatisch in sein System einlesen kann. Sein System versteht JSON, XML und DOCX. Entscheide Dich für ein Format und begründe Deine Entscheidung mit je einem Pro- und einem Kontra-Argument. (6 Punkte)
2 Punkte für eine geeignete Auswahl (JSON oder XML), je 2 Punkte für ein passendes Pro- und Kontra-Argument, zum Beispiel:
JSON – Pro: einfach und kompakt zu erzeugen, die Shop-Software nutzt JSON schon für die Schnittstelle zu Lipper SchließTec, eingebaute Datentypen. Kontra: kein Datumstyp, Formate (z. B. für Datum) müssen vereinbart werden; Prüfung über JSON Schema weniger verbreitet als XSD; keine Kommentare.
XML – Pro: hoher Grad an Standardisierung, Struktur und Datentypen lassen sich mit einem XML-Schema streng prüfen, bei Behörden weit verbreitet (z. B. XRechnung). Kontra: aufwendiger zu erzeugen, viel Overhead durch Start- und Endtags.
DOCX ist nicht geeignet: Es ist ein binäres Office-Format für Layout und Darstellung, kein Datenaustauschformat, und lässt sich nicht zuverlässig automatisch auslesen (keine Punkte für die Wahl von DOCX).
d) Cem fragt, warum Lipper SchließTec für die Schnittstelle JSON und nicht XML verwendet. Gib drei Vorteile von JSON gegenüber XML an. (6 Punkte)
Je Vorteil 2 Punkte, zum Beispiel:
JSON ist kürzer, weil Endtags fehlen; dadurch werden weniger Daten übertragen.
JSON ist schneller zu lesen und zu verarbeiten (einfachere Syntax, weniger Aufwand beim Parsen).
JSON hat eingebaute Arrays, z. B. für die Liste
positionen; in XML müssten Elemente wiederholt werden.JSON kennt Datentypen wie Number und Boolean (
"bestaetigt": true); in XML ist jeder Wert zunächst Text.JSON lässt sich in JavaScript direkt als Objekt verwenden und ist Standard bei REST-Schnittstellen.
e) Beschreibe den gemeinsamen Vorteil der Datenaustauschformate CSV, XML und JSON. (2 Punkte)
Alle drei sind offene, textbasierte Formate: Die Daten stehen im Klartext in der Datei, die Struktur der Daten (welche Felder in welcher Reihenfolge) können Sender und Empfänger selbst festlegen, und fast jedes Programm und jede Programmiersprache kann sie unabhängig von Hersteller und Betriebssystem lesen und schreiben (2 Punkte).
Links und weitere Informationen
Hinweis zur Nachnutzung als Open Educational Resource (OER)
Dieser Artikel und seine Texte, Bilder, Grafiken, Code und sonstiger Inhalt sind - sofern nicht anders angegeben - lizenziert unter CC BY 4.0. Nennung gemäß TULLU-Regel bitte wie folgt: “Übungsaufgaben zu Datenaustauschformaten” von oer-informatik.de (H. Stein), Lizenz: CC BY 4.0. Der Artikel wurde unter https://oer-informatik.de/datenaustauschformate-uebungsaufgaben veröffentlicht, die Quelltexte sind in weiterverarbeitbarer Form verfügbar im Repository unter https://gitlab.com/oer-informatik/datenformate/xml. Erstellt mit KI-Assistenz; von mir umfassend redaktionell überarbeitet, geprüft und freigegeben. Stand: 28.10.2026.
[Kommentare zum Artikel lesen, schreiben] / [Artikel teilen] / [gitlab-Issue zum Artikel schreiben]