Übungsaufgaben zu Repository-Integrationstests: passende Mitfahrgesuche finden
https://bildung.social/@oerinformatik/
https://oer-informatik.de/spring-boot-repository-integrationstest-uebungsaufgaben
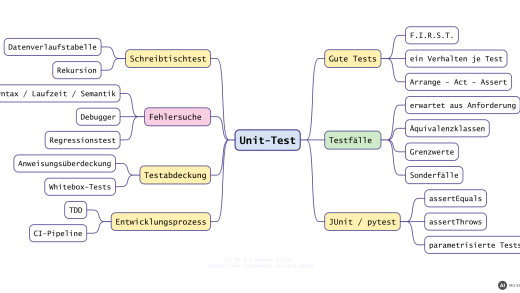
Integrationstest, DataJpaTest, Spring Data JPA, Abfragemethoden, JPQL, Query, TestEntityManager, Grenzwerte, Rollback, MariaDB, Übungsaufgaben
tl/dr; (ca. 33 min Lese- und Bearbeitungszeit): Übungen zu Abfragen und Integrationstests im Mitfahr-Backend: Du übersetzt Methodennamen in SQL, ordnest Aussagen zu
@DataJpaTestein, schreibst eine JPQL-Abfrage, die zu einer Abfahrtszeit die passenden Mitfahrgesuche findet, testest sie an den Grenzen des Zeitfensters und findest heraus, warum ein Test allein grün und in der Testsuite rot ist und warum ein anderer nur in der Pipeline mit MariaDB scheitert [AI-Assisted]. (Zuletzt geändert am 11.11.2026)
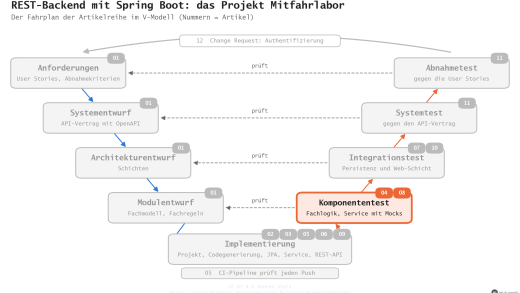
Dieser Artikel ist Teil einer Artikelreihe über ein REST-Backend mit Spring Boot: Überblick und Fahrplan / 01 Anforderungen und API-Vertrag / 02 Projekt anlegen / 03 Codegenerierung / 04 Fachlogik und Komponententest / 05 Build-Qualität und CI / 06 Persistenz mit JPA / 07 Repository-Integrationstest / Übungsaufgaben zu 07
Diese Übungsaufgaben gehören zum Artikel Abfragen schreiben und testen: Repository-Integrationstests mit @DataJpaTest und setzen den Übungsstrang zu den Mitfahrgesuchen fort. Ausgangspunkt ist das Projekt im Ordner src/07-repository-integrationstest des Repositorys, ergänzt um die Entity Gesuch (mit nutzer, haltepunkt, richtung, datum, zeitVon, zeitBis und status), die Aufzählung Gesuchstatus und das GesuchRepository aus den Übungen zu Artikel 06. Wenn ein Angebot neu eingestellt wird, soll das Backend später die Gesuche finden, zu denen es passt.

Hinweise zur Bearbeitung: Bis zur Teil-1-Prüfung der IT-Berufe solltest Du die Basiskompetenz beherrschen, also Aufgabe 1.1 und Aufgabe 1.2. Als FIA, FIDP oder FIDV musst Du zur Teil-2-Prüfung Aufgaben auf Kernkompetenz-Ebene lösen können, das sind Aufgabe 2.1 und Aufgabe 2.2. Von FIA wird zusätzlich erwartet, dass ihnen Aufgaben auf Profilkompetenz-Ebene (Aufgabe 3.1 und Aufgabe 3.2) keine Probleme bereiten. Notiere Deine Antworten zuerst vollständig, bevor Du die Beispiellösung aufklappst. Code und Tests kannst Du anschließend im Projekt aus dem Repository mit dem Build ausführen; andere fachlich richtige Lösungen sind ebenso richtig.
Du möchtest eigene Aufgaben zum Üben von einem KI-Sprachmodell generieren lassen?
Kopiere den Text in ein KI-Sprachmodell Deiner Wahl und passe Kompetenzstufe, Anzahl, Bearbeitungszeit und Szenario bei Bedarf an. Wie die Aufgaben aufgebaut sind, beschreibt der Artikel Wie sind die Aufgaben aufgebaut?. Prüfe die Ergebnisse mit dem Lehrartikel: KI-Sprachmodelle machen Fehler.
Erstelle neue Übungsaufgaben zum Thema „Repository-Integrationstests:
passende Mitfahrgesuche finden“.

Bauplan: Halte Dich an Aufbau, Kompetenzstufen, Operatoren,
Anforderungsbereiche, Punkte und Zeitschätzung, die im Artikel
https://oer-informatik.de/aufgaben-aufbau beschrieben sind.

Fachliche Grundlage:
- https://oer-informatik.de/spring-boot-repository-integrationstest
- https://oer-informatik.de/teststrategie
- https://oer-informatik.de/blackboxtests
- https://oer-informatik.de/sql-dml-selektion-projektion
- Stilbeispiel: https://oer-informatik.de/spring-boot-repository-integrationstest-uebungsaufgaben

Die Aufgaben sollen Inhalte zu diesen Schlagwörtern abdecken:
- Integrationstest
- DataJpaTest
- Spring Data JPA
- Abfragemethoden
- JPQL
- Query
- TestEntityManager
- Grenzwerte
- Rollback
- MariaDB

Kompetenzstufe: Basiskompetenz (alternativ: Kernkompetenz, Profilkompetenz, Expertise)
Anzahl: 1 Aufgabe mit Teilaufgaben
Bearbeitungszeit in Minuten ca.: <5 bis 30 min>
Szenario: eines der Szenarien aus dem Bauplan

Vorgehen:
1. Lies zuerst die verlinkten Artikel. Kannst Du keine Webseiten
   abrufen, sag mir das, statt zu raten.
2. Steht bei einer Angabe noch ein Platzhalter in <…>, frag mich
   zuerst danach. Richte Punkte und Zahl der Teilaufgaben nach der
   Bearbeitungszeit (ca. 0,9 min je Punkt).
3. Gib je Aufgabe Titel mit Kompetenzstufe, Ausgangssituation und
   Teilaufgaben mit Operator und Punktzahl aus, dazu die geschätzte
   Bearbeitungszeit.
4. Gib die Beispiellösungen mit Punkteverteilung erst aus, wenn ich
   danach frage.
Aufgabe 1.1: Methodennamen in SQL übersetzen (Basiskompetenz)
Im GesuchRepository stehen die folgenden Abfragemethoden:
List<Gesuch> findByNutzerIdOrderByDatumAscZeitVonAsc(Long nutzerId);

List<Gesuch> findByStatusAndHaltepunktIdAndRichtungAndDatum(Gesuchstatus status, Long haltepunktId,
        Fahrtrichtung richtung, LocalDate datum);

boolean existsByNutzerIdAndDatum(Long nutzerId, LocalDate datum);

List<Gesuch> findByStatusAndDatumBefore(Gesuchstatus status, LocalDate datum);

List<Gesuch> findByZeitAbLessThanEqual(LocalTime zeit);
Gib für die ersten vier Methoden die Bedingung (
where) und, falls vorhanden, die Sortierung (order by) der erzeugten SQL-Abfrage an. Verwende die Spaltennamen der Tabellegesuch. (4 Punkte)Die Anwendung startet mit der fünften Methode nicht. Erkläre, warum der Fehler erst beim Start und nicht schon beim Kompilieren auffällt. (1 Punkt)
- Je Methode 1 Punkt (Ausschnitte aus dem Log von Hibernate):
| Methode | erzeugte Bedingung und Sortierung |
|---|---|
findByNutzerIdOrderByDatumAscZeitVonAsc |
where nutzer_id=? order by datum, zeit_von |
findByStatusAndHaltepunktIdAndRichtungAndDatum |
where status=? and haltepunkt_id=? and richtung=? and datum=? |
existsByNutzerIdAndDatum |
where nutzer_id=? and datum=?, begrenzt auf eine Zeile (fetch first ? rows only); Ergebnis true, wenn es eine Zeile gibt |
findByStatusAndDatumBefore |
where status=? and datum<? |
- Für den Compiler ist
findByZeitAbLessThanEqualnur ein Methodenname in einem Interface. Erst Spring Data zerlegt den Namen beim Start und sucht das AttributzeitAb, das es inGesuchnicht gibt (No property 'zeitAb' found for type 'Gesuch') (1 Punkt).
Aufgabe 1.2: Aussagen zu @DataJpaTest beurteilen (Basiskompetenz)
Beurteile jede Aussage als richtig oder falsch und begründe Deine Entscheidung in einem Satz. (4 Punkte)
- Ein Test mit
@DataJpaTeststartet auch die Controller, damit man die Abfragen über HTTP aufrufen kann. - Ein Gesuch, das ein Test mit dem
TestEntityManagerspeichert, ist im nächsten Test nicht mehr in der Datenbank. - Der JaCoCo-Bericht zeigt nach den Tests, wie viel Prozent des
GesuchRepositoryabgedeckt sind. - Ein Repository-Test ist ein Integrationstest, weil er den eigenen Code zusammen mit Spring Data, Hibernate und einer Datenbank prüft.
Je Aussage mit Begründung 1 Punkt:
- Falsch.
@DataJpaTeststartet nur die Persistenzschicht (Entities, Repositories, Hibernate, Datenbank,TestEntityManager), keine Controller und keinen Webserver. - Richtig. Jeder Test läuft in einer Transaktion, die am Ende zurückgerollt wird; nur die Zähler für neue IDs laufen weiter.
- Falsch. Das Repository ist ein Interface ohne Anweisungen, die Implementierung erzeugt Spring Data beim Start; JaCoCo führt es deshalb gar nicht auf.
- Richtig. Geprüft wird das Zusammenspiel mehrerer Teile; ein Komponententest würde nur reinen Java-Code ohne Spring und Datenbank aufrufen.
Aufgabe 2.1: Passende Gesuche mit JPQL finden (Kernkompetenz)
Bietet jemand eine Fahrt an, sollen später alle offenen Gesuche angezeigt werden, die dazu passen: gleicher Haltepunkt, gleiche Richtung, gleiches Datum, und die Abfahrtszeit liegt im Zeitfenster des Gesuchs. Die Grenzen zählen mit: Ein Gesuch von 06:45 bis 07:15 Uhr passt zu einer Abfahrt um 06:45 Uhr und um 07:15 Uhr. Die Gesuche sollen nach dem Beginn des Zeitfensters sortiert sein.
Schreibe die Methode
findePassendeGesuche(haltepunktId, richtung, datum, abfahrt)imGesuchRepositorymit einer Abfrage in@Query. (5 Punkte)Die Abfrage ließe sich auch als Methodenname schreiben. Gib den Namen an und begründe, warum
@Queryhier trotzdem die bessere Wahl ist. (2 Punkte)
@Query("""
        select g from Gesuch g
        where g.status = de.dbh.mitfahrlabor.domain.Gesuchstatus.OFFEN
          and g.haltepunkt.id = :haltepunktId
          and g.richtung = :richtung
          and g.datum = :datum
          and g.zeitVon <= :abfahrt and g.zeitBis >= :abfahrt
        order by g.zeitVon
        """)
List<Gesuch> findePassendeGesuche(@Param("haltepunktId") Long haltepunktId,
        @Param("richtung") Fahrtrichtung richtung, @Param("datum") LocalDate datum,
        @Param("abfahrt") LocalTime abfahrt);
Punkte: JPQL mit Entity und Alias (1), Status OFFEN mit vollständigem Namen der Konstanten (1), Haltepunkt, Richtung und Datum über Attribute (g.haltepunkt.id, nicht haltepunkt_id) (1), Zeitfenster mit <= und >= einschließlich der Grenzen (1), benannte Parameter mit @Param und Sortierung (1). :abfahrt between g.zeitVon and g.zeitBis ist ebenso richtig.
findByStatusAndHaltepunktIdAndRichtungAndDatumAndZeitVonLessThanEqualAndZeitBisGreaterThanEqualOrderByZeitVonmit dem Status als zusätzlichem Parameter und der Abfahrtszeit zweimal (1 Punkt). Der Name ist länger als die Abfrage, kaum lesbar und fehleranfällig; die Abfahrt müsste doppelt übergeben werden, und der Status wäre ein Parameter, obwohl er immerOFFENist (1 Punkt).
Aufgabe 2.2: Das Zeitfenster an seinen Grenzen testen (Kernkompetenz)
Oksana Melnyk (Pseudonym Kaffeetasse) sucht für Montag, den 23.11.2026, eine Mitfahrgelegenheit zur Schule ab dem Hauptbahnhof Gütersloh (18,6 km) zwischen 06:45 und 07:15 Uhr. Daneben gibt es den Haltepunkt Marktplatz in Halle (Westf.) (15,2 km).
Schreibe die Testklasse GesuchRepositoryTest mit @DataJpaTest für die Methode aus Aufgabe 2.1. Lege die Testdaten selbst an, ohne data.sql. Prüfe die Grenzen des Zeitfensters (je ein Wert knapp außerhalb und genau auf jeder Grenze, dazu einer in der Mitte) und, dass ein anderer Haltepunkt und eine andere Richtung nicht passen. Importe musst Du nicht notieren. (8 Punkte)
@DataJpaTest(properties = "spring.sql.init.mode=never")
class GesuchRepositoryTest {

    private static final LocalDate MONTAG = LocalDate.of(2026, 11, 23);

    @Autowired
    private TestEntityManager entityManager;

    @Autowired
    private GesuchRepository gesuchRepository;

    private Haltepunkt guetersloh;
    private Haltepunkt halle;

    @BeforeEach
    void legeGesuchAn() {
        Nutzer oksana = entityManager.persist(new Nutzer("Kaffeetasse", "Oksana", "Melnyk",
                LocalDate.of(2003, 4, 28), null, false));
        guetersloh = entityManager.persist(new Haltepunkt("Hauptbahnhof", "Gütersloh", new BigDecimal("18.6")));
        halle = entityManager.persist(new Haltepunkt("Marktplatz", "Halle (Westf.)", new BigDecimal("15.2")));
        entityManager.persist(new Gesuch(oksana, guetersloh, Fahrtrichtung.ZUR_SCHULE, MONTAG,
                LocalTime.of(6, 45), LocalTime.of(7, 15)));
    }

    @ParameterizedTest
    @CsvSource({"06:44, 0", "06:45, 1", "07:00, 1", "07:15, 1", "07:16, 0"})
    void findetGesuchNurInnerhalbDesZeitfensters(LocalTime abfahrt, int erwarteteAnzahl) {
        assertThat(gesuchRepository.findePassendeGesuche(guetersloh.getId(), Fahrtrichtung.ZUR_SCHULE, MONTAG,
                abfahrt)).hasSize(erwarteteAnzahl);
    }

    @Test
    void andererHaltepunktOderAndereRichtungPasstNicht() {
        LocalTime abfahrt = LocalTime.of(7, 0);
        assertThat(gesuchRepository.findePassendeGesuche(halle.getId(), Fahrtrichtung.ZUR_SCHULE, MONTAG, abfahrt))
                .isEmpty();
        assertThat(gesuchRepository.findePassendeGesuche(guetersloh.getId(), Fahrtrichtung.NACH_HAUSE, MONTAG,
                abfahrt)).isEmpty();
    }
}
Punkte: @DataJpaTest mit abgeschalteter data.sql (1), TestEntityManager und Repository per @Autowired (1), Testdaten in @BeforeEach mit Nutzer, zwei Haltepunkten und dem Gesuch (2), Grenzwerte 06:44, 06:45, 07:15, 07:16 und ein Wert in der Mitte, etwa parametrisiert (2), Negativfälle für Haltepunkt und Richtung (1), IDs über getId() statt fester Zahlen (1). Die Grenzwerte decken genau die Fehler auf, die bei Zeitfenstern am häufigsten passieren: < statt <= oder vertauschte Attribute. Mit < statt <= in der Abfrage schlagen die Fälle 06:45 und 07:15 fehl.
Aufgabe 3.1: Allein grün, in der Testsuite rot (Profilkompetenz)
Ein Teammitglied ergänzt die Klasse NutzerRepositoryTest um diesen Test:
@Test
void ersterNutzerHatId1() {
    entityManager.persist(new Nutzer("Kaffeetasse", "Oksana", "Melnyk",
            LocalDate.of(2003, 4, 28), null, false));

    assertThat(nutzerRepository.findById(1L)).isPresent();
}
Startet es nur diesen Test, ist er grün. Im vollständigen Testlauf mit GesuchRepositoryTest schlägt er fehl:
NutzerRepositoryTest > ersterNutzerHatId1() FAILED
java.lang.AssertionError:
Expecting Optional to contain a value but it was empty.
Erkläre, warum der Test im vollständigen Lauf fehlschlägt, obwohl jeder Test mit einem Rollback endet. (3 Punkte)
Ändere den Test so, dass er unabhängig von der Reihenfolge der Tests dasselbe Ergebnis liefert. (2 Punkte)
Nenne eine allgemeine Regel für Repository-Tests, die sich daraus ableiten lässt. (1 Punkt)
Beide Testklassen haben dieselbe Konfiguration; Spring startet den Kontext und damit die H2-Testdatenbank nur einmal und nutzt sie für alle Tests des Laufs (1 Punkt). Der Rollback entfernt die gespeicherten Zeilen, setzt aber den Zähler der Identity-Spalte nicht zurück (1 Punkt). Hat
GesuchRepositoryTestvorher schon Nutzer angelegt, bekommt Oksana in diesem Test eine höhere ID; einen Nutzer mit der ID 1 gibt es nicht mehr (1 Punkt).Die ID des gespeicherten Objekts verwenden (2 Punkte):
@Test
void gespeicherterNutzerWirdGefunden() {
    Nutzer oksana = entityManager.persist(new Nutzer("Kaffeetasse", "Oksana", "Melnyk",
            LocalDate.of(2003, 4, 28), null, false));

    assertThat(nutzerRepository.findById(oksana.getId())).contains(oksana);
}- Ein Test darf nichts voraussetzen, was andere Tests oder die Reihenfolge der Tests bestimmen: keine festen IDs, keine Daten aus anderen Tests oder aus
data.sql; jeder Test legt an, was er braucht (1 Punkt).
Aufgabe 3.2: Grün mit H2, rot mit MariaDB (Profilkompetenz)
Für eine Anmeldung per Pseudonym bekommt das NutzerRepository die Methode Optional<Nutzer> findByPseudonym(String pseudonym). Der zugehörige Test ist mit H2 grün:
@Test
void pseudonymMussGenauStimmen() {
    entityManager.persist(new Nutzer("Kaffeetasse", "Oksana", "Melnyk",
            LocalDate.of(2003, 4, 28), null, false));

    assertThat(nutzerRepository.findByPseudonym("Kaffeetasse")).isPresent();
    assertThat(nutzerRepository.findByPseudonym("kaffeetasse")).isEmpty();
}
Mit dem Profil mariadb gegen MariaDB schlägt er fehl (gekürzt):
NutzerRepositoryTest > pseudonymMussGenauStimmen() FAILED
java.lang.AssertionError:
Expecting an empty Optional but was containing value: de.dbh.mitfahrlabor.domain.Nutzer@451506cf
    at de.dbh.mitfahrlabor.repository.NutzerRepositoryTest.pseudonymMussGenauStimmen(NutzerRepositoryTest.java:27)
Eine Abfrage der Datenbank ergibt: select default_collation_name from information_schema.schemata where schema_name='mitfahrlabor' → utf8mb4_general_ci.
Erkläre, warum dieselbe Abfrage auf beiden Datenbanken unterschiedliche Ergebnisse liefert. (2 Punkte)
Begründe, warum genau für solche Fälle der Job
test-mariadbin der Pipeline läuft. (1 Punkt)Schlage eine Lösung vor, die auf beiden Datenbanken gleich funktioniert, und begründe, welche fachliche Entscheidung vorher nötig ist. (3 Punkte)
Die Sortierfolge (Collation) bestimmt, wie eine Datenbank Texte vergleicht. Bei MariaDB endet die Standard-Sortierfolge auf
_ci(case insensitive):'kaffeetasse' = 'Kaffeetasse'ist dort wahr (1 Punkt). H2 vergleicht Texte standardmäßig mit Rücksicht auf Groß- und Kleinschreibung, deshalb findet die zweite Abfrage dort nichts (1 Punkt).Die Abfrage, der Code und die Tests sind unverändert, nur das Datenbanksystem verhält sich anders. Mit H2 allein wäre der Unterschied erst im Betrieb aufgefallen (1 Punkt).
Zuerst muss das Team entscheiden, ob Pseudonyme mit Rücksicht auf Groß- und Kleinschreibung unterschieden werden sollen (1 Punkt). Für eine Anmeldung ist es meist sinnvoll, sie nicht zu unterscheiden; dann wird die Abfrage ausdrücklich so geschrieben, dass beide Datenbanken gleich arbeiten, und der Test erwartet das:
Optional<Nutzer> findByPseudonymIgnoreCase(String pseudonym);Hibernate erzeugt daraus where upper(n1_0.pseudonym)=upper(?); der Test assertThat(nutzerRepository.findByPseudonymIgnoreCase("kaffeetasse")).isPresent() ist mit H2 und MariaDB grün (2 Punkte). Sollen Groß- und Kleinschreibung dagegen zählen, müsste die Spalte in MariaDB eine Sortierfolge ohne _ci bekommen, etwa über @Column(columnDefinition = …); das bindet die Entity an ein Datenbanksystem und ist deshalb die schlechtere Wahl. Die Eindeutigkeit von pseudonym sollte zur Entscheidung passen, sonst lassen sich auf H2 „Kaffeetasse“ und „kaffeetasse“ nebeneinander anlegen.
Links und weitere Informationen
zum Nachlesen: Abfragen schreiben und testen: Repository-Integrationstests mit @DataJpaTest
als Grundlage: Teststrategie, Blackbox-Tests und SQL: Selektion und Projektion
als Nachschlagewerk: Spring Data JPA – Abfragemethoden und Spring Boot – Testen von Spring-Boot-Anwendungen
Hinweis zur Nachnutzung als Open Educational Resource (OER)
Dieser Artikel und seine Texte, Bilder, Grafiken, Code und sonstiger Inhalt sind - sofern nicht anders angegeben - lizenziert unter CC BY 4.0. Nennung gemäß TULLU-Regel bitte wie folgt: “Übungsaufgaben zu Repository-Integrationstests: passende Mitfahrgesuche finden” von oer-informatik.de (H. Stein), Lizenz: CC BY 4.0. Der Artikel wurde unter https://oer-informatik.de/spring-boot-repository-integrationstest-uebungsaufgaben veröffentlicht, die Quelltexte sind in weiterverarbeitbarer Form verfügbar im Repository unter https://gitlab.com/oer-informatik/java-springboot/Backend. Erstellt mit KI-Assistenz; von mir umfassend redaktionell überarbeitet, geprüft und freigegeben. Stand: 11.11.2026.
[Kommentare zum Artikel lesen, schreiben] / [Artikel teilen] / [gitlab-Issue zum Artikel schreiben]