Daten speichern mit Spring Data JPA: Entities, Beziehungen, Repositories und H2
https://bildung.social/@oerinformatik/
https://oer-informatik.de/spring-boot-persistenz-jpa
JPA, Jakarta Persistence, Hibernate, Spring Data JPA, Entity, Repository, objektrelationale Abbildung, ORM, H2, MariaDB, data.sql, Spring Boot
tl/dr; (ca. 29 min Lesezeit): Bisher stehen die Haltepunkte fest im Code, und neue Angebote verschwinden beim Neustart. Jetzt bekommt das Mitfahr-Backend eine Datenbank: Aus dem Fachmodell werden JPA-Entities mit Beziehungen, Spring Data erzeugt den Zugriff aus einem leeren Interface, Hibernate legt die Tabellen an, und eine
data.sqlfüllt die H2-Datenbank beim Start mit den Daten des Szenarios. Wer Docker nutzt, startet dieselbe Anwendung mit MariaDB [AI-Assisted]. (Zuletzt geändert am 11.11.2026)
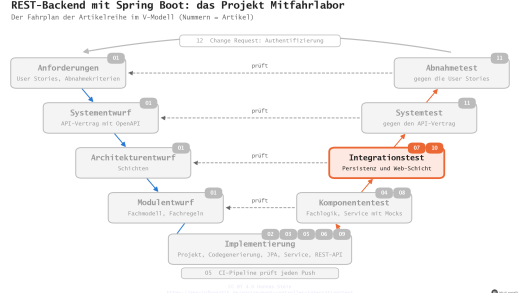
Dieser Artikel ist Teil einer Artikelreihe über ein REST-Backend mit Spring Boot: Überblick und Fahrplan / 01 Anforderungen und API-Vertrag / 02 Projekt anlegen / 03 Codegenerierung / 04 Fachlogik und Komponententest / 05 Build-Qualität und CI / 06 Persistenz mit JPA / Übungsaufgaben zu 06
Schon fit in diesem Thema? Nutze die Kann-Liste und die Leitfragen unter dem Artikel als Checkliste, ob Du die relevanten Kompetenzen bereits hast.
Dieser Artikel baut auf der Kann-Liste der Artikel Build-Qualität und CI, Relationenmodell und SQL-DDL auf.
Als JPA-Grundlagen kann ich nach Durchlesen des Artikels…
… erklären, was eine objektrelationale Abbildung (ORM) leistet und wie sich JPA, Hibernate und Spring Data JPA unterscheiden.
… Klasse, Objekt, Attribut und Objektreferenz den Begriffen Tabelle, Zeile, Spalte und Fremdschlüssel zuordnen.
… eine Klasse mit
@Entity,@Id,@GeneratedValueund@Columnzu einer Entity machen und begründen, warum sie einen parameterlosen Konstruktor braucht.… ein Repository als Interface von
JpaRepositoryableiten und dessen geerbte Methoden wiefindAll(),findById()undsave()nutzen.… die H2-Datenbank konfigurieren, Startdaten per
data.sqlladen und das erzeugte SQL im Log lesen.
Darüber hinaus kann ich als JPA-Expertenwissen…
… Beziehungen mit
@ManyToOne,@JoinColumnund@OneToMany(mappedBy = …)abbilden und die besitzende Seite einer Beziehung benennen.… begründen, warum Aufzählungen mit
EnumType.STRINGgespeichert werden und Fremdschlüssel standardmäßigLAZYgeladen werden.… Fehlermeldungen beim Start (fehlende Tabelle, doppelter Primärschlüssel, verletzter Fremdschlüssel) deuten.
… dieselbe Anwendung über ein Spring-Profil mit MariaDB in Docker statt mit H2 starten.
Bis jetzt hat das Mitfahrlabor kein Gedächtnis. Die sechs Haltepunkte stehen als Liste im Controller, und ein neues Angebot liegt nur in einer ArrayList: Nach jedem Neustart ist es weg. Für ein Backend, über das Fahrten verabredet werden, geht das nicht. Die Daten müssen in eine Datenbank.
Im V-Modell bleibt dieser Artikel auf der Ebene der Implementierung: Er setzt das Fachmodell aus Artikel 01 in Klassen um, die eine Datenbank speichern kann. Ob die Abfragen wirklich stimmen, prüfen erst die Integrationstests im nächsten Artikel.

Ausgangspunkt ist das Projekt aus Artikel 05. Das Ergebnis findest Du im Ordner src/06-persistenz-jpa des Repositorys. Wie Tabellen, Primär- und Fremdschlüssel zusammenhängen, erklären die Artikel Relationenmodell und SQL-DDL; hier geht es darum, wie Java-Objekte dort hineinkommen.
Vom Objekt zur Tabelle: Was JPA erledigt
Java denkt in Objekten, die sich gegenseitig referenzieren: Ein Angebot hat einen Haltepunkt. Eine relationale Datenbank denkt in Tabellen und Zeilen: Die Zeile in angebot enthält in der Spalte haltepunkt_id die Nummer einer Zeile in haltepunkt. Diese beiden Welten passen nicht von selbst zusammen. Man könnte jedes INSERT und jedes SELECT von Hand schreiben und die Ergebnisse Feld für Feld in Objekte kopieren; ein Programm, das diese Übersetzung übernimmt, heißt objektrelationaler Mapper (ORM, object-relational mapping).
| Java (Objektwelt) | Datenbank (relationale Welt) | Beispiel |
|---|---|---|
Klasse mit @Entity |
Tabelle | Haltepunkt → Tabelle haltepunkt |
| Objekt | Zeile | der Haltepunkt Busbahnhof Bad Salzuflen → Zeile mit id 4 |
| Attribut | Spalte | entfernungKm → Spalte entfernung_km |
Attribut mit @Id |
Primärschlüssel | id |
| Referenz auf ein anderes Objekt | Fremdschlüssel | Angebot.haltepunkt → Spalte angebot.haltepunkt_id |
Aufzählung (enum) |
Spalte mit festen Werten | Fahrtrichtung.ZUR_SCHULE → 'ZUR_SCHULE' |
Drei Bausteine teilen sich die Arbeit, und ihre Namen werden oft durcheinandergeworfen:
- Jakarta Persistence (JPA) ist eine Spezifikation: Sie legt Annotationen wie
@Entityund@Idund eine Schnittstelle zum Speichern und Laden (EntityManager) fest. Sie steht im Paketjakarta.persistenceund enthält selbst keinen ausführbaren Datenbankcode. - Hibernate ist die Implementierung, die Spring Boot mitbringt. Hibernate liest die Annotationen, erzeugt SQL, schickt es über JDBC an die Datenbank und baut aus den Ergebnissen wieder Objekte.
- Spring Data JPA sitzt darüber und erspart den Umgang mit dem
EntityManager: Man schreibt ein Interface, und Spring erzeugt beim Start eine Klasse mit Methoden wiefindAll()odersave().
Den Weg eines einzelnen Zugriffs zeigt die Grafik: Der Controller fragt das Repository nach dem Haltepunkt 4, Hibernate macht daraus ein select, der JDBC-Treiber spricht mit der Datenbank, und zurück kommt ein fertiges Haltepunkt-Objekt. Welche Datenbank dahinter steht, merkt der Controller nicht.

Abhängigkeiten ergänzen
Für die Datenbank braucht das Projekt vier neue Einträge, dieselben, die der Spring Initializr für Spring Boot 4.1 erzeugt, wenn man Spring Data JPA, H2 Database und MariaDB Driver auswählt:
spring-boot-starter-data-jpabringt JPA, Hibernate und Spring Data JPA.spring-boot-h2consolestellt die Weboberfläche der H2-Datenbank bereit. Seit Spring Boot 4 ist sie ein eigenes Modul; früher steckte sie im allgemeinen Autokonfigurations-Paket.h2undmariadb-java-clientsind die JDBC-Treiber. Sie werden nur zur Laufzeit gebraucht (runtimeOnlybzw.runtime), weil der eigene Code nie direkt auf sie zugreift.
dependencies {
    implementation("org.springframework.boot:spring-boot-starter-webmvc")
    implementation("org.springframework.boot:spring-boot-starter-validation")
    implementation("org.springframework.boot:spring-boot-starter-data-jpa")
    implementation("org.springframework.boot:spring-boot-h2console")
    runtimeOnly("com.h2database:h2")
    runtimeOnly("org.mariadb.jdbc:mariadb-java-client")
    testImplementation("org.springframework.boot:spring-boot-starter-webmvc-test")
    testRuntimeOnly("org.junit.platform:junit-platform-launcher")
}
Die Ergänzung steht in build.gradle.kts.
Die Versionen verwaltet Spring Boot. Im Projekt landen damit Hibernate 7.4, Spring Data JPA 4.1, H2 2.4 und der MariaDB-Treiber 3.5.
Die erste Entity: Haltepunkt
Eine Entity ist eine gewöhnliche Java-Klasse mit einigen Annotationen. Der Haltepunkt bekommt seinen Platz im Paket domain, neben den Fachregeln aus Artikel 04. Die Annotationen stammen aus jakarta.persistence, nicht aus Spring; das Paket bleibt damit frei von Spring-Code.
package de.dbh.mitfahrlabor.domain;

import java.math.BigDecimal;

import jakarta.persistence.Column;
import jakarta.persistence.Entity;
import jakarta.persistence.GeneratedValue;
import jakarta.persistence.GenerationType;
import jakarta.persistence.Id;

/** Öffentlicher Treffpunkt, an dem Fahrten beginnen oder enden. */
@Entity
public class Haltepunkt {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @Column(nullable = false, length = 80)
    private String name;

    @Column(nullable = false, length = 60)
    private String ort;

    @Column(nullable = false, precision = 5, scale = 1)
    private BigDecimal entfernungKm;

    /** Für JPA: Entities brauchen einen parameterlosen Konstruktor. */
    protected Haltepunkt() {
    }

    public Haltepunkt(String name, String ort, BigDecimal entfernungKm) {
        this.name = name;
        this.ort = ort;
        this.entfernungKm = entfernungKm;
    }

    public Long getId() {
        return id;
    }

    // weitere Getter für name, ort und entfernungKm
}
Was die einzelnen Teile bewirken:
@Entitymacht die Klasse zu einer Entity. Ohne weitere Angabe heißt die Tabelle wie die Klasse:haltepunkt.@Idkennzeichnet den Primärschlüssel.@GeneratedValue(strategy = GenerationType.IDENTITY)überlässt das Hochzählen der Datenbank (AUTO_INCREMENTbei MariaDB,generated by default as identitybei H2). Der Typ istLongstattlong, weil ein neues, noch nicht gespeichertes Objekt noch keine ID hat:nullstatt einer irreführenden 0.@Columnist freiwillig. Ohne die Annotation wird jedes Attribut zu einer Spalte, dienullerlauben darf.nullable = falseundlengthlanden später imcreate table. Für Beträge und Entfernungen gibtprecisiondie Gesamtzahl der Stellen undscaledie Nachkommastellen an; wie bei den Fachregeln aus Artikel 04 ist der TypBigDecimal, damit 18,6 km nicht als 18,600000000000001 gespeichert werden.- Spaltennamen erzeugt Spring Boot aus den Attributnamen: Aus
entfernungKmwirdentfernung_km. So passen die Tabellen zu den Konventionen der SQL-Artikel. - Der parameterlose Konstruktor ist Pflicht. Hibernate erzeugt beim Laden zuerst ein leeres Objekt und füllt dann die Attribute. Er darf
protectedsein, damit niemand im eigenen Code versehentlich einen Haltepunkt ohne Namen anlegt.
Ein record, wie ihn Artikel 02 für den ersten Controller genutzt hat, eignet sich nicht als Entity: Records haben nur final-Attribute und keinen parameterlosen Konstruktor. Setter fehlen bewusst: Die Daten eines Haltepunkts ändern sich über die API nicht. Hibernate setzt die Attribute beim Laden direkt, auch ohne Setter, weil @Id am Attribut steht (Feldzugriff).
Aufzählungen und Beziehungen: Angebot, Buchung, Nutzer
Das MVP aus Artikel 01 braucht vier Entities. Nutzer sind vereinfacht: ohne Schulkonto und Klasse, aber mit Geburtsdatum, Einwilligung der Eltern und Führerschein, denn diese drei Angaben brauchen die Fachregeln. Das Klassendiagramm zeigt die Entities und ihre Beziehungen:

Das Angebot zeigt alle neuen Bausteine auf einmal (Importe gekürzt):
@Entity
public class Angebot {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @ManyToOne(optional = false, fetch = FetchType.LAZY)
    @JoinColumn(name = "fahrer_id")
    private Nutzer fahrer;

    @ManyToOne(optional = false, fetch = FetchType.LAZY)
    private Haltepunkt haltepunkt;

    @Enumerated(EnumType.STRING)
    @Column(nullable = false, length = 12)
    private Fahrtrichtung richtung;

    @Column(nullable = false)
    private LocalDate datum;

    @Column(nullable = false)
    private LocalTime abfahrt;

    private int freiePlaetze;

    @Column(nullable = false, precision = 5, scale = 2)
    private BigDecimal kostenbeitragEur;

    @Enumerated(EnumType.STRING)
    @Column(nullable = false, length = 15)
    private Angebotsstatus status = Angebotsstatus.OFFEN;

    @OneToMany(mappedBy = "angebot")
    private List<Buchung> buchungen = new ArrayList<>();

    protected Angebot() {
    }

    // Konstruktor mit allen Pflichtangaben außer id und status, Getter
}
@ManyToOne beschreibt die häufigste Beziehung: Viele Angebote gehören zu einem Haltepunkt. In der Tabelle angebot entsteht dafür eine Fremdschlüsselspalte. Ihr Name setzt sich aus Attributname und _id zusammen (haltepunkt_id); mit @JoinColumn(name = "fahrer_id") wählt man einen anderen. optional = false macht die Spalte zur Pflichtspalte (not null).
fetch = FetchType.LAZY steuert, wann der Nutzer und der Haltepunkt geladen werden. Standard bei @ManyToOne ist EAGER: Hibernate lädt beide sofort mit, auch wenn niemand sie braucht. Mit LAZY steht an ihrer Stelle zunächst ein Platzhalter (Proxy), der erst beim ersten Zugriff auf ein Attribut nachlädt. Die ID kennt der Platzhalter schon; deshalb kostet angebot.getFahrer().getId() keine zusätzliche Abfrage.
@Enumerated(EnumType.STRING) speichert eine Aufzählung als Text ('ZUR_SCHULE'). Ohne die Annotation speichert JPA die Position in der Aufzählung (0, 1, …, EnumType.ORDINAL). Das ist kürzer, aber gefährlich: Schiebt jemand später einen Wert in die Mitte der Aufzählung, bedeuten alle gespeicherten Zahlen etwas anderes, ohne dass ein Fehler auftritt. Die Fahrtrichtung bekommt mit Fahrtrichtung einen eigenen Namen, weil der OpenAPI Generator schon eine Klasse Richtung erzeugt hat; der Angebotsstatus heißt aus demselben Grund Angebotsstatus statt AngebotStatus.
@OneToMany(mappedBy = "angebot") ist die Gegenrichtung: Ein Angebot kennt seine Buchungen. mappedBy sagt Hibernate, dass diese Liste keine eigene Spalte und keine eigene Tabelle bekommt; die Information steht schon im Attribut angebot der Klasse Buchung. Die Buchung ist die besitzende Seite der Beziehung, denn nur ihre Tabelle enthält den Fremdschlüssel. Fehlt mappedBy, legt Hibernate eine zusätzliche Verknüpfungstabelle an, die niemand braucht (das probierst Du in den Übungen aus).
Die Buchung bringt noch eine Regel aus dem Fachmodell mit: Jede Person darf je Angebot höchstens eine Buchung haben (Fachregel 5). Das lässt sich direkt als Eindeutigkeitsbedingung über zwei Spalten ausdrücken:
@Entity
@Table(uniqueConstraints = @UniqueConstraint(columnNames = {"angebot_id", "mitfahrer_id"}))
public class Buchung {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @ManyToOne(optional = false, fetch = FetchType.LAZY)
    private Angebot angebot;

    @ManyToOne(optional = false, fetch = FetchType.LAZY)
    @JoinColumn(name = "mitfahrer_id")
    private Nutzer mitfahrer;

    @Enumerated(EnumType.STRING)
    @Column(nullable = false, length = 12)
    private Buchungsstatus status = Buchungsstatus.ANGEFRAGT;

    @Column(nullable = false)
    private LocalDateTime angefragtAm;

    // Konstruktoren und Getter
}
Der Buchungsstatus ist die Aufzählung aus Artikel 04, samt der Methoden für die erlaubten Statuswechsel. Er wird damit ohne Änderung zum Spaltentyp. Fahrzeuge, Gesuche, Bewertungen und Klassen aus dem großen Szenario-Datenmodell gehören nicht zum MVP und fehlen deshalb.
Repositories mit Spring Data
Für den Zugriff auf die Tabellen genügt je Entity ein Interface im Paket repository. Es erbt von JpaRepository und nennt in spitzen Klammern die Entity und den Typ ihres Primärschlüssels:
package de.dbh.mitfahrlabor.repository;

import org.springframework.data.jpa.repository.JpaRepository;

import de.dbh.mitfahrlabor.domain.Haltepunkt;

public interface HaltepunktRepository extends JpaRepository<Haltepunkt, Long> {
}
Eine Klasse, die dieses Interface implementiert, schreibt niemand. Spring Data erzeugt sie beim Start und stellt sie als Bean bereit. Geerbt sind unter anderem diese Methoden:
| Methode | Rückgabe | erzeugtes SQL (sinngemäß) |
|---|---|---|
findAll() |
List<Haltepunkt> |
select … from haltepunkt |
findById(4L) |
Optional<Haltepunkt> |
select … from haltepunkt where id=? |
save(haltepunkt) |
gespeichertes Objekt mit ID | insert into haltepunkt … (neu) bzw. update haltepunkt … (vorhanden) |
count() |
long |
select count(*) from haltepunkt |
existsById(4L) |
boolean |
select … where id=? |
deleteById(4L) |
– | delete from haltepunkt where id=? |
findById liefert ein Optional, weil es den gesuchten Datensatz vielleicht nicht gibt. Damit erzwingt die Signatur, dass der aufrufende Code den Fall „nicht gefunden“ behandelt. Eigene Abfragen wie „alle offenen Angebote an einem Datum“ kommen im nächsten Artikel dazu, zusammen mit den Tests, die sie prüfen.
Die Datenbank konfigurieren
Spring Boot findet den H2-Treiber im Klassenpfad und startet ohne jede Angabe eine Datenbank im Arbeitsspeicher. Einige Einstellungen machen das Verhalten aber nachvollziehbar. Sie stehen in src/main/resources/application.properties:
spring.application.name=mitfahrlabor

# Datenbank: H2 im Arbeitsspeicher (Standard), Name fest statt zufällig
spring.datasource.url=jdbc:h2:mem:mitfahrlabor
# Hibernate legt die Tabellen aus den Entities an und löscht sie beim Beenden
spring.jpa.hibernate.ddl-auto=create-drop
# data.sql erst ausführen, nachdem Hibernate die Tabellen angelegt hat
spring.jpa.defer-datasource-initialization=true
# erzeugtes SQL im Log zeigen
spring.jpa.show-sql=true
# Datenbankzugriffe nur im Controller bzw. Service, nicht beim Schreiben der Antwort
spring.jpa.open-in-view=false
# Weboberfläche der H2-Datenbank unter http://localhost:8080/h2-console
spring.h2.console.enabled=true
Mit ddl-auto=create-drop erzeugt Hibernate die Tabellen beim Start aus den Entities. Dank show-sql steht das SQL im Log; so sieht man, was aus den Annotationen geworden ist (Ausgabe für zwei Tabellen):
Hibernate: create table angebot (abfahrt time(0) not null, datum date not null, freie_plaetze integer not null, kostenbeitrag_eur numeric(5,2) not null, fahrer_id bigint not null, haltepunkt_id bigint not null, id bigint generated by default as identity, richtung enum ('NACH_HAUSE','ZUR_SCHULE') not null, status enum ('ABGESAGT','DURCHGEFUEHRT','OFFEN','VOLL') not null, primary key (id))
Hibernate: create table haltepunkt (entfernung_km numeric(5,1) not null, id bigint generated by default as identity, ort varchar(60) not null, name varchar(80) not null, primary key (id))
Hibernate: alter table if exists angebot add constraint FK2moab5kmdx6g3ux2checn794 foreign key (fahrer_id) references nutzer
Hibernate: alter table if exists angebot add constraint FKk3qoa2aoi4k5ypw0u52f7pmme foreign key (haltepunkt_id) references haltepunkt
Man erkennt jede Annotation wieder: nullable = false wird zu not null, precision/scale zu numeric(5,2), EnumType.STRING bei H2 zu einem enum-Typ mit den erlaubten Werten, und jede @ManyToOne-Beziehung zu einem Fremdschlüssel. Die Namen der Constraints (FK2moab…) erzeugt Hibernate selbst. create-drop ist für die Entwicklung gedacht: Bei jedem Start entsteht eine frische Datenbank. Für eine Datenbank im Betrieb verwaltet man das Schema mit Migrationswerkzeugen wie Flyway oder Liquibase; die Einstellung heißt dann validate.
Mit open-in-view=false schaltet man eine Bequemlichkeit von Spring Boot ab, die standardmäßig an ist und beim Start eine Warnung erzeugt: Die Datenbankverbindung bliebe sonst bis zum Schreiben der HTTP-Antwort offen, und ein vergessener LAZY-Zugriff würde unbemerkt weitere Abfragen auslösen.
Startdaten mit data.sql
Eine leere Datenbank hilft beim Ausprobieren wenig. Liegt eine Datei data.sql in src/main/resources, führt Spring Boot sie beim Start aus. Sie enthält die Daten des Szenarios Mitfahrlabor, vereinfacht auf das MVP (Ausschnitt):
INSERT INTO haltepunkt (name, ort, entfernung_km) VALUES
('Hauptbahnhof, ZOB Steig 3', 'Gütersloh',        18.6),  -- 1
('Park & Ride am Bahnhof',    'Herford',          17.9),  -- 2
('Marktplatz',                'Halle (Westf.)',   15.2),  -- 3
('Busbahnhof',                'Bad Salzuflen',    19.4),  -- 4
('Kirchplatz',                'Werther (Westf.)', 13.1),  -- 5
('Bahnhof Brackwede',         'Bielefeld',         6.2);  -- 6

-- INSERT INTO nutzer ... (10 Nutzerinnen und Nutzer)

INSERT INTO angebot (fahrer_id, haltepunkt_id, richtung, datum, abfahrt, freie_plaetze, kostenbeitrag_eur, status) VALUES
(1, 1, 'ZUR_SCHULE', '2026-10-19', '07:00:00', 2, 1.80, 'OFFEN'),  -- 1
(1, 1, 'NACH_HAUSE', '2026-10-19', '14:20:00', 3, 1.80, 'OFFEN'),  -- 2
(6, 3, 'ZUR_SCHULE', '2026-10-19', '07:10:00', 0, 1.50, 'VOLL'),  -- 3
-- ... bis Angebot 7

-- INSERT INTO buchung ... (5 Buchungen)
Zwei Stolpersteine lassen sich an dieser Datei gut beobachten.
Erstens die Reihenfolge. Normalerweise führt Spring Boot data.sql vor Hibernate aus. Dann gibt es die Tabellen noch nicht, und der Start bricht ab (gekürzt):
Caused by: org.springframework.jdbc.datasource.init.ScriptStatementFailedException: Failed to execute SQL script statement #1 of file [.../build/resources/main/data.sql]: INSERT INTO haltepunkt (name, ort, entfernung_km) VALUES ('Hauptbahnhof, ZOB Steig 3', 'Gütersloh', 18.6), ...
Caused by: org.h2.jdbc.JdbcSQLSyntaxErrorException: Table "HALTEPUNKT" not found (this database is empty); SQL statement:
Die Einstellung spring.jpa.defer-datasource-initialization=true verschiebt das Skript hinter das Anlegen der Tabellen.
Zweitens die IDs. Naheliegend wäre, die IDs aus dem Szenario mit einzufügen (INSERT INTO angebot (id, …) VALUES (1, …)). Der Start klappt dann, aber das erste neue Angebot über die API scheitert mit dem Statuscode 500. Im Log steht der Grund:
WARN ... HHH000247: ErrorCode: 23505, SQLState: 23505
WARN ... Unique index or primary key violation: "PUBLIC.CONSTRAINT_F PRIMARY KEY ON PUBLIC.ANGEBOT(ID) ( /* key:1 */ ...
H2 zählt den Zähler für neue IDs nicht weiter, wenn man IDs von Hand vergibt; das erste neue Angebot bekommt deshalb wieder die 1. Am einfachsten lässt man die IDs in der data.sql weg. Die Datenbank nummeriert die Zeilen in ihrer Reihenfolge, die Kommentare am Zeilenende halten die Nummern für die Fremdschlüssel fest. Weil create-drop bei jedem Start leere Tabellen erzeugt, beginnt die Zählung immer bei 1.
Die Werte für Aufzählungen stehen in Großbuchstaben ('ZUR_SCHULE'), so wie EnumType.STRING sie schreibt. Im JSON der API heißt dieselbe Richtung weiterhin zur-schule; diese Übersetzung erledigt der Controller.
Controller auf die Datenbank umstellen
Jetzt kann der HaltepunktController seine feste Liste abgeben. Er bekommt das Repository über den Konstruktor: Spring sieht, dass der Konstruktor ein HaltepunktRepository verlangt, und übergibt die erzeugte Bean beim Start. Dieses Prinzip heißt Konstruktorinjektion; Artikel 08 erklärt es ausführlich.
@RestController
public class HaltepunktController implements HaltepunkteApi {

    private final HaltepunktRepository haltepunktRepository;

    public HaltepunktController(HaltepunktRepository haltepunktRepository) {
        this.haltepunktRepository = haltepunktRepository;
    }

    @Override
    public ResponseEntity<List<Haltepunkt>> listeHaltepunkte() {
        List<Haltepunkt> haltepunkte = haltepunktRepository.findAll().stream()
                .map(HaltepunktController::zuApi)
                .toList();
        return ResponseEntity.ok(haltepunkte);
    }

    @Override
    public ResponseEntity<Haltepunkt> holeHaltepunkt(Long haltepunktId) {
        return haltepunktRepository.findById(haltepunktId)
                .map(HaltepunktController::zuApi)
                .map(ResponseEntity::ok)
                .orElse(ResponseEntity.notFound().build());
    }

    /** Entity (Tabelle) in das Modell des API-Vertrags umwandeln; beide Klassen heißen Haltepunkt. */
    private static Haltepunkt zuApi(de.dbh.mitfahrlabor.domain.Haltepunkt h) {
        return new Haltepunkt(h.getId(), h.getName(), h.getOrt(), h.getEntfernungKm().doubleValue());
    }
}
Hier treffen zwei Klassen mit demselben Namen aufeinander: api.model.Haltepunkt ist das vom OpenAPI Generator erzeugte Modell des Vertrags (so sieht das JSON aus), domain.Haltepunkt ist die Entity (so liegt der Datensatz in der Tabelle). Importiert ist das Modell des Vertrags, die Entity steht mit vollem Paketnamen in der Umwandlungsmethode zuApi. Dass beide getrennt bleiben, ist gewollt: Eine Spalte kann hinzukommen, ohne dass sich der Vertrag ändert, und umgekehrt. Sobald es mehr Umwandlungen gibt, wandern sie in Artikel 09 in eigene Klassen.
Der AngebotController speichert neue Angebote nun mit save(). Vorher sucht er Fahrerin bzw. Fahrer und Haltepunkt; gibt es eine der IDs nicht, antwortet er mit 404, wie es der Vertrag für POST /angebote vorsieht:
@Override
public ResponseEntity<Angebot> legeAngebotAn(AngebotNeu neu) {
    Optional<Nutzer> fahrer = nutzerRepository.findById(neu.getFahrerId());
    Optional<Haltepunkt> haltepunkt = haltepunktRepository.findById(neu.getHaltepunktId());
    if (fahrer.isEmpty() || haltepunkt.isEmpty()) {
        return ResponseEntity.notFound().build();
    }
    var angebot = new de.dbh.mitfahrlabor.domain.Angebot(fahrer.get(), haltepunkt.get(),
            Fahrtrichtung.valueOf(neu.getRichtung().name()), neu.getDatum(),
            LocalTime.parse(neu.getAbfahrt()), neu.getFreiePlaetze(),
            BigDecimal.valueOf(neu.getKostenbeitragEur()));
    var gespeichert = angebotRepository.save(angebot);
    return ResponseEntity.created(URI.create("/v1/angebote/" + gespeichert.getId()))
            .body(zuApi(gespeichert));
}
Die Richtung lässt sich über den Namen der Konstanten übersetzen: Die erzeugte Aufzählung Richtung hat die Konstanten ZUR_SCHULE und NACH_HAUSE (mit dem JSON-Wert zur-schule bzw. nach-hause), die Entity-Aufzählung Fahrtrichtung dieselben Namen. save() gibt das gespeicherte Objekt zurück, jetzt mit der von der Datenbank vergebenen ID.
Gestartet wird wie gewohnt:
.\gradlew.bat bootRunMit den Anfragen aus haltepunkte.http und angebote.http lässt sich alles ausprobieren. Ein neues Angebot bekommt die ID 8, weil data.sql schon sieben Angebote angelegt hat:
HTTP/1.1 201
Location: /v1/angebote/8
Content-Type: application/json

{"fahrerId":1,"haltepunktId":1,"richtung":"zur-schule","datum":"2026-11-19","abfahrt":"07:00","freiePlaetze":2,"kostenbeitragEur":1.8,"id":8,"status":"offen"}
Im Log steht, welches SQL dafür ausgeführt wurde: zwei Abfragen für Fahrer und Haltepunkt, dann das insert. Die ID schreibt Hibernate als default, die Datenbank vergibt sie:
Hibernate: select n1_0.id,n1_0.einwilligung_eltern,n1_0.fuehrerschein,n1_0.geburtsdatum,n1_0.nachname,n1_0.pseudonym,n1_0.vorname from nutzer n1_0 where n1_0.id=?
Hibernate: select h1_0.id,h1_0.entfernung_km,h1_0.name,h1_0.ort from haltepunkt h1_0 where h1_0.id=?
Hibernate: insert into angebot (abfahrt,datum,fahrer_id,freie_plaetze,haltepunkt_id,kostenbeitrag_eur,richtung,status,id) values (?,?,?,?,?,?,?,?,default)
Ein GET /v1/angebote/8 erzeugt anschließend nur eine einzige Abfrage auf angebot, obwohl die Antwort fahrerId und haltepunktId enthält. Das ist die Wirkung von LAZY: Die beiden IDs stehen schon in den Platzhaltern, Nutzer und Haltepunkt werden gar nicht geladen. Mit fahrerId: 99 antwortet der Controller mit 404.
Ein Blick in die Datenbank: die H2-Konsole
Weil die H2-Datenbank nur im Arbeitsspeicher der laufenden Anwendung existiert, kann kein anderes Programm sie sehen. Dafür bringt H2 eine Weboberfläche mit, die der Eintrag spring.h2.console.enabled=true einschaltet. Beim Start meldet das Log:
H2 console available at '/h2-console'. Database available at 'jdbc:h2:mem:mitfahrlabor'Unter http://localhost:8080/h2-console trägst Du als JDBC-URL jdbc:h2:mem:mitfahrlabor ein, als Benutzernamen sa und lässt das Passwort leer; diese Zugangsdaten setzt Spring Boot für eingebettete Datenbanken. Dort kannst Du beliebiges SQL ausprobieren, etwa SELECT * FROM angebot WHERE status = 'OFFEN'. Den festen Namen mitfahrlabor in der URL braucht es genau dafür: Ohne die Einstellung vergibt Spring Boot bei jedem Start einen zufälligen Namen. Die Konsole ist nur für die Entwicklung gedacht und wird im Profil für MariaDB wieder ausgeschaltet.
H2 oder MariaDB mit Docker
H2 ist bequem: nichts zu installieren, bei jedem Start ein frischer Datenbestand. Im Betrieb würde das Mitfahrlabor aber eine echte Datenbank nutzen, an der Schule zum Beispiel MariaDB. Weil der Code nur JPA kennt, genügt zum Wechsel eine andere Konfiguration. Spring Boot nutzt dafür Profile: Eine Datei application-<profil>.properties ergänzt bzw. überschreibt die Einstellungen aus application.properties, sobald das Profil aktiv ist.
Für H2 ist nichts weiter zu tun. Die Datenbank startet mit der Anwendung, die Einstellungen stehen in application.properties (siehe oben), und beim Beenden ist alles wieder weg. Das ist der Standard für alle Artikel dieser Reihe.
Wenn Du mit dem Profil mariadb arbeitest, ändert sich am Verhalten nichts: Hibernate erzeugt die Tabellen nun im Dialekt von MariaDB (bigint not null auto_increment, engine=InnoDB), data.sql füllt sie, und die Endpunkte liefern dieselben Antworten. Ein Unterschied ist aber wichtig: Bei MariaDB übernimmt die Datenbank von Hand vergebene IDs in ihren Zähler, H2 tut das nicht. Ein Fehler wie der doppelte Primärschlüssel aus dem Abschnitt über data.sql tritt deshalb nur mit H2 auf. Solche Unterschiede sind der Grund, warum die Pipeline ab dem nächsten Artikel die Integrationstests auch gegen MariaDB ausführt.
Was die Datenbank (noch) nicht weiß
Die Tabellen sichern einiges ab: Pflichtspalten, gültige Fremdschlüssel, erlaubte Werte für Richtung und Status, höchstens eine Buchung je Person und Angebot. Die Fachregeln aus Artikel 04 kennt die Datenbank dagegen nicht. In der data.sql steht das Angebot 5 aus dem Szenario mit einem Kostenbeitrag von 2,50 Euro ab Bad Salzuflen (19,4 km); erlaubt wären nach der Kostenregel höchstens 1,94 Euro. data.sql und Datenbank nehmen das klaglos an, und auch der Controller prüft beim Speichern nichts. Dass jede Änderung durch die Fachregeln geht, ist die Aufgabe des Service in Artikel 08.
Auch die Tests haben sich kaum verändert: Der Smoke-Test contextLoads startet jetzt zwar die Datenbank mit und würde einen Fehler in den Entities oder in data.sql bemerken, aber ob findById das richtige Angebot findet, prüft niemand. Die Abdeckung im JaCoCo-Bericht ist entsprechend von 73 auf 44 Prozent der Anweisungen gesunken. ./gradlew check bzw. ./mvnw verify laufen weiterhin mit 41 grünen Tests, Checkstyle und Spotless haben an den neuen Klassen nichts auszusetzen.
Nächster Artikel
Im nächsten Artikel bekommen die Repositories eigene Abfragemethoden, etwa für die Suche nach offenen Angeboten an einem Haltepunkt, und mit @DataJpaTest die ersten Integrationstests. Die Pipeline startet dafür eine MariaDB-Datenbank als Dienst, damit die Tests auch gegen die Datenbank laufen, die später im Betrieb genutzt wird.
Leitfragen
- Wie unterscheiden sich JPA, Hibernate und Spring Data JPA?
JPA (Jakarta Persistence) ist eine Spezifikation mit Annotationen und der Schnittstelle EntityManager. Hibernate ist eine Implementierung dieser Spezifikation, die SQL erzeugt und Objekte aus Tabellenzeilen baut. Spring Data JPA erzeugt darüber Repositories aus Interfaces, sodass man den EntityManager nicht selbst benutzen muss. siehe Abschnitt „Vom Objekt zur Tabelle: Was JPA erledigt“
- Was braucht eine Klasse mindestens, um eine Entity zu sein, und warum eignet sich ein
recordnicht?
Die Annotation @Entity, ein Attribut mit @Id als Primärschlüssel und einen parameterlosen Konstruktor (mindestens protected). Hibernate erzeugt beim Laden zuerst ein leeres Objekt und setzt dann die Attribute. Ein record hat nur final-Attribute und keinen parameterlosen Konstruktor. siehe Abschnitt „Die erste Entity: Haltepunkt“
- Wie wird die Beziehung „ein Angebot hat einen Haltepunkt“ in Java und in der Datenbank abgebildet?
In Java als Attribut private Haltepunkt haltepunkt mit @ManyToOne, in der Datenbank als Fremdschlüsselspalte haltepunkt_id in der Tabelle angebot. Den Spaltennamen kann man mit @JoinColumn ändern; optional = false macht ihn zur Pflichtspalte. siehe Abschnitt „Aufzählungen und Beziehungen: Angebot, Buchung, Nutzer“
- Was bedeutet
mappedByin@OneToMany(mappedBy = "angebot"), und welche Seite besitzt die Beziehung?
mappedBy gibt an, dass die Liste der Buchungen keine eigene Spalte oder Tabelle bekommt, weil die Beziehung schon im Attribut angebot der Klasse Buchung abgebildet ist. Besitzende Seite ist die Buchung, denn ihre Tabelle enthält den Fremdschlüssel. Ohne mappedBy legt Hibernate eine zusätzliche Verknüpfungstabelle an. siehe Abschnitt „Aufzählungen und Beziehungen: Angebot, Buchung, Nutzer“
- Warum werden Aufzählungen mit
EnumType.STRINGgespeichert?
Ohne Angabe speichert JPA die Position in der Aufzählung (ORDINAL). Wird später ein Wert eingefügt oder die Reihenfolge geändert, bedeuten die gespeicherten Zahlen etwas anderes, ohne dass ein Fehler auftritt. Als Text bleibt der Wert eindeutig und in der Datenbank lesbar. siehe Abschnitt „Aufzählungen und Beziehungen: Angebot, Buchung, Nutzer“
- Welche Methoden bietet ein Repository, das von
JpaRepositoryerbt, und warum gibtfindByIdeinOptionalzurück?
Unter anderem findAll, findById, save, count, existsById und deleteById; die Implementierung erzeugt Spring Data beim Start. findById liefert ein Optional, weil es den gesuchten Datensatz vielleicht nicht gibt; der aufrufende Code muss den Fall „nicht gefunden“ behandeln, etwa mit einer 404-Antwort. siehe Abschnitt „Repositories mit Spring Data“
- Wozu dienen
ddl-auto=create-drop,defer-datasource-initializationunddata.sql, und was geht schief, wenn indata.sqlIDs von Hand vergeben werden?
Hibernate legt die Tabellen beim Start aus den Entities an und löscht sie am Ende; data.sql füllt sie mit Startdaten; defer-datasource-initialization sorgt dafür, dass das Skript erst nach dem Anlegen der Tabellen läuft. Vergibt man IDs von Hand, zählt H2 den Zähler nicht weiter, und das erste neue Objekt scheitert an einem doppelten Primärschlüssel. siehe Abschnitt „Die Datenbank konfigurieren“
- Wie startest Du das Backend mit MariaDB statt mit H2?
Mit docker compose up -d die MariaDB aus compose.yaml starten und die Anwendung mit dem Profil mariadb ausführen. Die Datei application-mariadb.properties ersetzt dann die Verbindungsdaten und schaltet data.sql mit spring.sql.init.mode=always auch für die externe Datenbank ein. siehe Abschnitt „H2 oder MariaDB mit Docker“
Links und weitere Informationen
zum Weiterlernen: Übungsaufgaben zur Persistenz mit JPA
als Grundlage: Relationenmodell, SQL-DDL: Tabellen anlegen, SQL-DDL: Constraints, Assoziationen im UML-Klassendiagramm
als Nachschlagewerk: Spring Data JPA – Referenzdokumentation, Spring Boot – SQL-Datenbanken, Spring Boot – Datenbank initialisieren, Hibernate ORM – Dokumentation, H2 Database, MariaDB-Image auf Docker Hub
Hinweis zur Nachnutzung als Open Educational Resource (OER)
Dieser Artikel und seine Texte, Bilder, Grafiken, Code und sonstiger Inhalt sind - sofern nicht anders angegeben - lizenziert unter CC BY 4.0. Nennung gemäß TULLU-Regel bitte wie folgt: “Daten speichern mit Spring Data JPA: Entities, Beziehungen, Repositories und H2” von oer-informatik.de (H. Stein), Lizenz: CC BY 4.0. Der Artikel wurde unter https://oer-informatik.de/spring-boot-persistenz-jpa veröffentlicht, die Quelltexte sind in weiterverarbeitbarer Form verfügbar im Repository unter https://gitlab.com/oer-informatik/java-springboot/Backend. Erstellt mit KI-Assistenz; von mir umfassend redaktionell überarbeitet, geprüft und freigegeben. Stand: 11.11.2026.
[Kommentare zum Artikel lesen, schreiben] / [Artikel teilen] / [gitlab-Issue zum Artikel schreiben]