Übungsaufgaben zur Persistenz mit JPA: Mitfahrgesuche in der Datenbank speichern
https://bildung.social/@oerinformatik/
https://oer-informatik.de/spring-boot-persistenz-jpa-uebungsaufgaben
JPA, Hibernate, Spring Data JPA, Entity, Repository, Fremdschlüssel, Beziehungen, mappedBy, EnumType, data.sql, H2, Übungsaufgaben
tl/dr; (ca. 37 min Lese- und Bearbeitungszeit): Übungen zur Persistenz im Mitfahr-Backend: Du ordnest Java- und Datenbankbegriffe zu, liest das von Hibernate erzeugte SQL für die Tabelle der Mitfahrgesuche, schreibst die Entity
Gesuch, ein Repository und die Startdaten indata.sql, deutest eine Fehlermeldung zum Fremdschlüssel, machst die Beziehung zwischen Nutzer und Gesuch in beide Richtungen navigierbar und zeigst, warumEnumType.ORDINALgespeicherte Daten unbemerkt verfälscht [AI-Assisted]. (Zuletzt geändert am 11.11.2026)
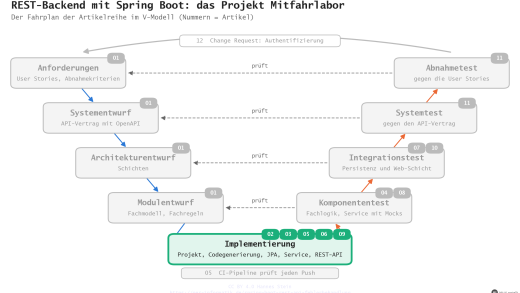
Dieser Artikel ist Teil einer Artikelreihe über ein REST-Backend mit Spring Boot: Überblick und Fahrplan / 01 Anforderungen und API-Vertrag / 02 Projekt anlegen / 03 Codegenerierung / 04 Fachlogik und Komponententest / 05 Build-Qualität und CI / 06 Persistenz mit JPA / Übungsaufgaben zu 06
Diese Übungsaufgaben gehören zum Artikel Daten speichern mit Spring Data JPA: Entities, Beziehungen, Repositories und H2 und setzen den Übungsstrang zu den Mitfahrgesuchen fort. Ausgangspunkt ist das Projekt im Ordner src/06-persistenz-jpa des Repositorys. Ein Gesuch beschreibt, dass jemand eine Mitfahrgelegenheit sucht: an einem Haltepunkt, in einer Richtung, an einem Datum und in einem Zeitfenster. Aus den Übungen zu Artikel 04 gibt es dafür schon die Aufzählung Gesuchstatus mit den Werten OFFEN, VERMITTELT, ZURUECKGEZOGEN und ABGELAUFEN.

Hinweise zur Bearbeitung: Bis zur Teil-1-Prüfung der IT-Berufe solltest Du die Basiskompetenz beherrschen, also Aufgabe 1.1 und Aufgabe 1.2. Als FIA, FIDP oder FIDV musst Du zur Teil-2-Prüfung Aufgaben auf Kernkompetenz-Ebene lösen können, das sind Aufgabe 2.1 und Aufgabe 2.2. Von FIA wird zusätzlich erwartet, dass ihnen Aufgaben auf Profilkompetenz-Ebene (Aufgabe 3.1 und Aufgabe 3.2) keine Probleme bereiten. Notiere Deine Antworten zuerst vollständig, bevor Du die Beispiellösung aufklappst. Code und Tests kannst Du anschließend im Projekt aus dem Repository mit dem Build ausführen; andere fachlich richtige Lösungen sind ebenso richtig.
Du möchtest eigene Aufgaben zum Üben von einem KI-Sprachmodell generieren lassen?
Kopiere den Text in ein KI-Sprachmodell Deiner Wahl und passe Kompetenzstufe, Anzahl, Bearbeitungszeit und Szenario bei Bedarf an. Wie die Aufgaben aufgebaut sind, beschreibt der Artikel Wie sind die Aufgaben aufgebaut?. Prüfe die Ergebnisse mit dem Lehrartikel: KI-Sprachmodelle machen Fehler.
Erstelle neue Übungsaufgaben zum Thema „Persistenz mit JPA:
Mitfahrgesuche in der Datenbank speichern“.

Bauplan: Halte Dich an Aufbau, Kompetenzstufen, Operatoren,
Anforderungsbereiche, Punkte und Zeitschätzung, die im Artikel
https://oer-informatik.de/aufgaben-aufbau beschrieben sind.

Fachliche Grundlage:
- https://oer-informatik.de/spring-boot-persistenz-jpa
- https://oer-informatik.de/relationenmodell
- https://oer-informatik.de/sql-ddl-constraint
- Stilbeispiel: https://oer-informatik.de/spring-boot-persistenz-jpa-uebungsaufgaben

Die Aufgaben sollen Inhalte zu diesen Schlagwörtern abdecken:
- JPA
- Hibernate
- Spring Data JPA
- Entity
- Repository
- Fremdschlüssel
- Beziehungen
- mappedBy
- EnumType
- data.sql
- H2

Kompetenzstufe: Basiskompetenz (alternativ: Kernkompetenz, Profilkompetenz, Expertise)
Anzahl: 1 Aufgabe mit Teilaufgaben
Bearbeitungszeit in Minuten ca.: <5 bis 30 min>
Szenario: eines der Szenarien aus dem Bauplan

Vorgehen:
1. Lies zuerst die verlinkten Artikel. Kannst Du keine Webseiten
   abrufen, sag mir das, statt zu raten.
2. Steht bei einer Angabe noch ein Platzhalter in <…>, frag mich
   zuerst danach. Richte Punkte und Zahl der Teilaufgaben nach der
   Bearbeitungszeit (ca. 0,9 min je Punkt).
3. Gib je Aufgabe Titel mit Kompetenzstufe, Ausgangssituation und
   Teilaufgaben mit Operator und Punktzahl aus, dazu die geschätzte
   Bearbeitungszeit.
4. Gib die Beispiellösungen mit Punkteverteilung erst aus, wenn ich
   danach frage.
Aufgabe 1.1: Begriffe aus Java und Datenbank zuordnen (Basiskompetenz)
- Ordne jedem Java-Element aus der geplanten Entity
Gesuchdas entsprechende Element der Datenbank zu: Tabelle, Zeile, Spalte, Primärschlüssel, Fremdschlüssel oder Spalte mit festen Werten. (3 Punkte)
- die Klasse
Gesuchmit@Entity - das Attribut
idmit@Id - das Attribut
datum - das Attribut
nutzervom TypNutzermit@ManyToOne - das Objekt für das Gesuch von Oksana am 23.11.2026, 06:45 bis 07:15 Uhr
- das Attribut
statusvom TypGesuchstatusmit@Enumerated(EnumType.STRING)
- Im Team fallen die Begriffe JPA, Hibernate und Spring Data JPA. Beschreibe für jeden Begriff in einem Satz, welche Aufgabe er im Mitfahrlabor übernimmt. (3 Punkte)
- Je zwei richtige Zuordnungen 1 Punkt:
| Nr. | Element der Datenbank |
|---|---|
| 1 | Tabelle gesuch |
| 2 | Primärschlüssel id |
| 3 | Spalte datum |
| 4 | Fremdschlüssel nutzer_id (verweist auf nutzer.id) |
| 5 | Zeile der Tabelle gesuch |
| 6 | Spalte mit festen Werten ('OFFEN', 'VERMITTELT', …) |
- Je Begriff 1 Punkt:
- JPA (Jakarta Persistence): Spezifikation, die Annotationen wie
@Entity,@Idund@ManyToOnesowie denEntityManagerfestlegt; sie enthält selbst keinen Datenbankcode. - Hibernate: Implementierung von JPA, die aus den Annotationen die Tabellen anlegt, SQL erzeugt und Tabellenzeilen in Objekte umwandelt.
- Spring Data JPA: erzeugt aus einem Interface wie
GesuchRepositorybeim Start eine Klasse mit Methoden wiefindAll(),findById()undsave().
Aufgabe 1.2: Das erzeugte SQL lesen (Basiskompetenz)
Ein Teammitglied hat die Entity Gesuch bereits geschrieben. Beim Start erscheint im Log (Constraint-Namen von Hibernate):
Hibernate: create table gesuch (datum date not null, zeit_bis time(0) not null, zeit_von time(0) not null, haltepunkt_id bigint not null, id bigint generated by default as identity, nutzer_id bigint not null, richtung enum ('NACH_HAUSE','ZUR_SCHULE') not null, status enum ('ABGELAUFEN','OFFEN','VERMITTELT','ZURUECKGEZOGEN') not null, primary key (id))
Hibernate: alter table if exists gesuch add constraint FKcsyofpgdfqirm7lcs7gm4ji7g foreign key (haltepunkt_id) references haltepunkt
Hibernate: alter table if exists gesuch add constraint FKgicepmixog23tgm2s5c1etmfg foreign key (nutzer_id) references nutzer
Nenne den Primärschlüssel der Tabelle und beide Fremdschlüssel mit der Tabelle, auf die sie verweisen. Gib an, wer die Werte des Primärschlüssels vergibt. (3 Punkte)
Gib an, welche Spalten
nullenthalten dürfen und welche Werte in der Spaltestatuserlaubt sind. (2 Punkte)Die Spalte
statusist alsenum (...)angelegt. Nenne die Annotation, die dazu geführt hat, und gib an, was ohne sie in der Spalte stünde. (1 Punkt)
Primärschlüssel ist
id(primary key (id)); die Werte vergibt die Datenbank (generated by default as identity, in der Entity@GeneratedValue(strategy = GenerationType.IDENTITY)) (1 Punkt). Fremdschlüssel sindhaltepunkt_id→ Tabellehaltepunktundnutzer_id→ Tabellenutzer(je 1 Punkt).Keine Spalte darf
nullenthalten, alle tragennot null(1 Punkt). Instatussind nur'ABGELAUFEN','OFFEN','VERMITTELT'und'ZURUECKGEZOGEN'erlaubt (1 Punkt).@Enumerated(EnumType.STRING); ohne die Annotation speichert JPA die Position in der Aufzählung als Zahl (EnumType.ORDINAL) (1 Punkt).
Aufgabe 2.1: Die Entity Gesuch schreiben (Kernkompetenz)
Schreibe die Klasse Gesuch im Paket de.dbh.mitfahrlabor.domain so, dass Hibernate daraus genau die Tabelle aus Aufgabe 1.2 erzeugt. Ein neues Gesuch hat den Status OFFEN. Neben den Annotationen gehören ein Konstruktor für JPA, ein Konstruktor mit allen fachlichen Angaben und die Getter für id, nutzer und status dazu; weitere Getter darfst Du weglassen. Importe musst Du nicht notieren. (8 Punkte)
@Entity
public class Gesuch {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @ManyToOne(optional = false, fetch = FetchType.LAZY)
    private Nutzer nutzer;

    @ManyToOne(optional = false, fetch = FetchType.LAZY)
    private Haltepunkt haltepunkt;

    @Enumerated(EnumType.STRING)
    @Column(nullable = false, length = 12)
    private Fahrtrichtung richtung;

    @Column(nullable = false)
    private LocalDate datum;

    @Column(nullable = false)
    private LocalTime zeitVon;

    @Column(nullable = false)
    private LocalTime zeitBis;

    @Enumerated(EnumType.STRING)
    @Column(nullable = false, length = 15)
    private Gesuchstatus status = Gesuchstatus.OFFEN;

    protected Gesuch() {
    }

    public Gesuch(Nutzer nutzer, Haltepunkt haltepunkt, Fahrtrichtung richtung, LocalDate datum,
            LocalTime zeitVon, LocalTime zeitBis) {
        this.nutzer = nutzer;
        this.haltepunkt = haltepunkt;
        this.richtung = richtung;
        this.datum = datum;
        this.zeitVon = zeitVon;
        this.zeitBis = zeitBis;
    }

    public Long getId() {
        return id;
    }

    public Nutzer getNutzer() {
        return nutzer;
    }

    public Gesuchstatus getStatus() {
        return status;
    }
}
Punkte: @Entity und @Id mit @GeneratedValue(IDENTITY) (1), zwei @ManyToOne-Beziehungen mit optional = false (2), beide Aufzählungen mit EnumType.STRING (1), Pflichtspalten mit nullable = false (1), Startwert OFFEN (1), parameterloser protected-Konstruktor (1), fachlicher Konstruktor und Getter (1). Die Spaltennamen zeit_von, nutzer_id usw. ergeben sich aus den Attributnamen, @JoinColumn ist hier nicht nötig. fetch = FetchType.LAZY und die Längenangaben ändern die Tabelle aus Aufgabe 1.2 nicht und sind deshalb keine Pflicht.
Aufgabe 2.2: Repository und Startdaten für Gesuche (Kernkompetenz)
Schreibe das Interface
GesuchRepository, mit dem der Controller später Gesuche laden und speichern kann. (2 Punkte)Oksana Melnyk (Nutzer 3) sucht für Montag, den 23.11.2026, drei Mitfahrgelegenheiten: zur Schule ab dem Hauptbahnhof Gütersloh (Haltepunkt 1) zwischen 06:45 und 07:15 Uhr, zur Schule ab dem Marktplatz in Halle (Westf.) (Haltepunkt 3) zwischen 07:00 und 07:20 Uhr und nach Hause zum Hauptbahnhof Gütersloh zwischen 15:00 und 16:00 Uhr. Ergänze
data.sqlum die drei offenen Gesuche. (4 Punkte)Nach einer Änderung an
data.sqlstartet die Anwendung nicht mehr. Im Log steht (gekürzt):
Caused by: org.h2.jdbc.JdbcSQLIntegrityConstraintViolationException: Referential integrity constraint violation: "FKGICEPMIXOG23TGM2S5C1ETMFG: PUBLIC.GESUCH FOREIGN KEY(NUTZER_ID) REFERENCES PUBLIC.NUTZER(ID) (CAST(13 AS BIGINT))"; SQL statement:Erkläre die Ursache und beschreibe, wie Du den Fehler behebst. (2 Punkte)
- Ableitung von
JpaRepositorymit Entity und Typ des Primärschlüssels (2 Punkte):
package de.dbh.mitfahrlabor.repository;

import org.springframework.data.jpa.repository.JpaRepository;

import de.dbh.mitfahrlabor.domain.Gesuch;

public interface GesuchRepository extends JpaRepository<Gesuch, Long> {
}- Je Zeile 1 Punkt, 1 Punkt für Spaltenliste ohne
idund Werte der Aufzählungen in Großbuchstaben. Die Zeilen stehen hinter den INSERTs fürnutzerundhaltepunkt:
INSERT INTO gesuch (nutzer_id, haltepunkt_id, richtung, datum, zeit_von, zeit_bis, status) VALUES
(3, 1, 'ZUR_SCHULE', '2026-11-23', '06:45:00', '07:15:00', 'OFFEN'),  -- 1
(3, 3, 'ZUR_SCHULE', '2026-11-23', '07:00:00', '07:20:00', 'OFFEN'),  -- 2
(3, 1, 'NACH_HAUSE', '2026-11-23', '15:00:00', '16:00:00', 'OFFEN'); -- 3- Ein Gesuch verweist in
nutzer_idauf den Nutzer 13, den es in der Tabellenutzernicht gibt; die Datenbank weist die Zeile wegen des Fremdschlüssels ab (1 Punkt). Behebung: die richtige Nutzer-ID eintragen (hier vermutlich ein Tippfehler für 3) bzw. den fehlenden Nutzer vorher anlegen; gleiches gilt, wenn die INSERTs fürgesuchvor denen fürnutzerstehen (1 Punkt).
Aufgabe 3.1: Gesuche einer Person in beide Richtungen navigieren (Profilkompetenz)
Für eine spätere Übersicht „Meine Gesuche“ soll ein Nutzer seine Gesuche kennen. Ein Teammitglied ergänzt in Nutzer:
@OneToMany
private List<Gesuch> gesuche = new ArrayList<>();
Beim nächsten Start enthält das Log zusätzlich:
Hibernate: create table nutzer_gesuche (gesuche_id bigint not null unique, nutzer_id bigint not null)
Hibernate: alter table if exists nutzer_gesuche add constraint FKjqacp0w2uagji73vlh7qqnmdp foreign key (gesuche_id) references gesuch
Hibernate: alter table if exists nutzer_gesuche add constraint FK345qdn0kl0xxa8y5i0gy4w91k foreign key (nutzer_id) references nutzer
Erkläre, warum Hibernate eine zusätzliche Tabelle anlegt, und beschreibe, welches Problem entsteht, wenn sie bleibt. (3 Punkte)
Korrigiere die Annotation und begründe, welche der beiden Klassen die Beziehung besitzt. (2 Punkte)
Im
NutzerRepositorywird ein Nutzer geladen und danachgetGesuche()aufgerufen. Erläutere, wann Hibernate die Gesuche aus der Datenbank liest. (2 Punkte)
Ohne
mappedByhält HibernateNutzer.gesucheundGesuch.nutzerfür zwei unabhängige Beziehungen (1 Punkt). Für eine@OneToManyohnemappedBylegt Hibernate standardmäßig eine Verknüpfungstabelle an (1 Punkt). Dieselbe Information steht dann an zwei Stellen: ingesuch.nutzer_idund innutzer_gesuche. Wird ein Gesuch nur übernew Gesuch(...)mitsave()gespeichert, bleibt die Verknüpfungstabelle leer, undgetGesuche()liefert später eine leere Liste (1 Punkt).Korrektur (1 Punkt):
@OneToMany(mappedBy = "nutzer")
private List<Gesuch> gesuche = new ArrayList<>();
mappedBy nennt das Attribut der Gegenseite. Die Beziehung besitzt Gesuch, weil nur seine Tabelle den Fremdschlüssel nutzer_id enthält; die Liste in Nutzer wird daraus nur gelesen (1 Punkt). Danach entsteht keine Tabelle nutzer_gesuche mehr.
@OneToManylädt standardmäßigLAZY: Beim Laden des Nutzers enthält das Attribut nur einen Platzhalter; dasselect … from gesuch where nutzer_id=?läuft erst beim ersten Zugriff auf die Liste, etwa beim Durchlaufen (1 Punkt). Dafür muss die Sitzung mit der Datenbank noch offen sein; mitspring.jpa.open-in-view=falseaußerhalb einer Transaktion endet der Zugriff mit einerLazyInitializationException. Transaktionen folgen in Artikel 08 (1 Punkt).
Aufgabe 3.2: Gesuchstatus als Zahl gespeichert (Profilkompetenz)
In einem anderen Team speichert die Entity Gesuch ihren Status mit @Enumerated(EnumType.ORDINAL). Hibernate legt dafür die Spalte status tinyint not null check ((status between 0 and 3)) an. In data.sql stehen die drei Gesuche aus Aufgabe 2.2 mit den Statuswerten 0, 1 und 2. Ein kleiner Test gibt alle Gesuche aus:
@SpringBootTest
class OrdinalTest {
    @Autowired
    GesuchRepository repo;

    @Test
    void zeige() {
        repo.findAll().forEach(g -> System.out.println("GESUCH " + g.getId() + " " + g.getStatus()));
    }
}
Er liefert zunächst:
GESUCH 1 OFFEN
GESUCH 2 VERMITTELT
GESUCH 3 ZURUECKGEZOGEN
Später ergänzt jemand einen Status für Gesuche, die eine Weile nicht angezeigt werden sollen, und schreibt ihn hinter OFFEN: OFFEN, PAUSIERT, VERMITTELT, ZURUECKGEZOGEN, ABGELAUFEN. Ohne weitere Änderung liefert derselbe Test:
GESUCH 1 OFFEN
GESUCH 2 PAUSIERT
GESUCH 3 VERMITTELT
Erkläre die veränderte Ausgabe. (3 Punkte)
Begründe, warum weder Hibernate noch die Datenbank einen Fehler melden. (1 Punkt)
Schlage zwei Maßnahmen vor, die das Problem vermeiden oder beheben, und bewerte sie kurz. (2 Punkte)
Mit
ORDINALsteht in der Tabelle nur die Position des Werts in der Aufzählung, gezählt ab 0 (1 Punkt). Durch das Einfügen vonPAUSIERTan Position 1 rücken alle folgenden Werte eine Stelle nach hinten (1 Punkt). Die gespeicherte 1 bedeutete vorherVERMITTELTund wird jetzt alsPAUSIERTgelesen, die 2 alsVERMITTELTstattZURUECKGEZOGEN(1 Punkt).Alle gespeicherten Zahlen liegen weiterhin im gültigen Bereich (die Prüfung lautet jetzt
between 0 and 4), und jede Zahl lässt sich einem Wert zuordnen. Formal ist alles richtig, nur die Bedeutung hat sich verschoben (1 Punkt).Je Maßnahme mit Bewertung 1 Punkt, zum Beispiel:
EnumType.STRINGverwenden: Der Name des Werts steht in der Tabelle, die Reihenfolge der Aufzählung spielt keine Rolle mehr; kostet etwas Speicher, ist dafür lesbar. Umbenennen eines Werts bleibt heikel.- Neue Werte nur am Ende der Aufzählung ergänzen: verhindert das Verschieben, verlässt sich aber auf eine Regel, die niemand prüft.
- Vorhandene Daten beim Umbau per SQL umschlüsseln (Migration, z. B. mit Flyway): nötig, wenn schon Daten im Betrieb gespeichert sind; aufwendig und fehleranfällig.
Links und weitere Informationen
zum Nachlesen: Daten speichern mit Spring Data JPA: Entities, Beziehungen, Repositories und H2
als Grundlage: Relationenmodell und SQL-DDL: Constraints
als Nachschlagewerk: Spring Data JPA – Referenzdokumentation und Hibernate ORM – Dokumentation
Hinweis zur Nachnutzung als Open Educational Resource (OER)
Dieser Artikel und seine Texte, Bilder, Grafiken, Code und sonstiger Inhalt sind - sofern nicht anders angegeben - lizenziert unter CC BY 4.0. Nennung gemäß TULLU-Regel bitte wie folgt: “Übungsaufgaben zur Persistenz mit JPA: Mitfahrgesuche in der Datenbank speichern” von oer-informatik.de (H. Stein), Lizenz: CC BY 4.0. Der Artikel wurde unter https://oer-informatik.de/spring-boot-persistenz-jpa-uebungsaufgaben veröffentlicht, die Quelltexte sind in weiterverarbeitbarer Form verfügbar im Repository unter https://gitlab.com/oer-informatik/java-springboot/Backend. Erstellt mit KI-Assistenz; von mir umfassend redaktionell überarbeitet, geprüft und freigegeben. Stand: 11.11.2026.
[Kommentare zum Artikel lesen, schreiben] / [Artikel teilen] / [gitlab-Issue zum Artikel schreiben]