NoSQL und Dokumentendatenbanken: Daten als JSON speichern
https://bildung.social/@oerinformatik/
https://oer-informatik.de/nosql-json
NoSQL, JSON, Dokumentendatenbank, MongoDB, Zeitreihendatenbank, Big Data, XML, CSV, CAP-Theorem, BASE, ACID, Skalierung
tl/dr; (ca. 31 min Lesezeit): Nicht alle Daten passen gut in Tabellen. Der Artikel zeigt zuerst, was ein Datenbanksystem einer Tabellenkalkulation voraushat. NoSQL-Datenbanken speichern Daten als Schlüssel-Wert-Paare, Dokumente, Spaltenfamilien, Graphen oder Zeitreihen; Zeitreihendatenbanken sind auf Messwerte spezialisiert. Der Artikel erklärt die JSON-Notation mit ihren Datentypen und typischen Fehlern, vergleicht JSON mit XML und CSV, zeigt, wie aus Tabellenzeilen Dokumente werden und wann man Daten einbettet oder referenziert, stellt BASE dem ACID-Prinzip gegenüber, erklärt Big Data mit den drei V und gibt eine Entscheidungshilfe: relationale oder dokumentenorientierte Datenbank [AI-Assisted]? (Zuletzt geändert am 27.10.2026)
Dieser Artikel baut auf der Kann-Liste des Artikels Das Relationenmodell auf.
Schon fit in diesem Thema? Nutze die Kann-Liste und die Leitfragen unter dem Artikel als Checkliste, ob Du die relevanten Kompetenzen bereits hast.
Als NoSQL-Grundlagen kann ich nach Durchlesen des Artikels…
… Vorteile eines Datenbankmanagementsystems gegenüber einer Tabellenkalkulation beschreiben.
… erklären, was NoSQL bedeutet, und die vier Arten Schlüssel-Wert-, Dokument-, Spaltenfamilien- und Graphdatenbank mit je einem Einsatzbeispiel nennen.
… den wesentlichen Unterschied zwischen SQL- und NoSQL-Datenbanken erläutern.
… Vorteile von Zeitreihendatenbanken für Messwerte beschreiben und begründen, warum eine relationale Datenbank für fortlaufende Messwerte wenig geeignet ist.
… den Begriff Big Data mit Volume, Velocity und Variety erläutern.
… relationale und dokumentenorientierte Datenbanken anhand von Kriterien wie Datenmodell, Schema, Abfragesprache, Skalierung und Transaktionen unterscheiden.
… die Fachbegriffe Datenbank, Tabelle, Datensatz und Spalte den Begriffen Database, Collection, Document und Field zuordnen.
… ein JSON-Dokument mit Objekten, Arrays und den sechs Datentypen fehlerfrei notieren, Fehler in JSON finden und Datentypen bestimmen.
… Datensätze aus Tabellen in JSON umwandeln und eine 1:n-Beziehung als eingebettetes Array darstellen.
… für einen Anwendungsfall eine relationale oder eine dokumentenorientierte Datenbank vorschlagen und mit Argumenten begründen.
… Merkmale und Vorteile der Austauschformate JSON, XML und CSV nennen und vergleichen.
Darüber hinaus kann ich als NoSQL-Expertenwissen…
… begründen, wann ich Daten einbette und wann ich sie referenziere.
… das CAP-Theorem und das BASE-Prinzip erläutern und beurteilen, wann kurzzeitig inkonsistente Daten tragbar sind.
… begründet beurteilen, ob ER-Modell und relationales Datenmodell für einen Big-Data-Anwendungsfall geeignet sind.
… einfache Abfragen einer Dokumentendatenbank (MongoDB) lesen und ihr Ergebnis bestimmen.
… Risiken eines flexiblen Schemas für die Datenqualität erkennen und Gegenmaßnahmen nennen.
Relationale Datenbanken sind seit Jahrzehnten der Standard: Tabellen mit festen Spalten, Schlüssel und Fremdschlüssel, Abfragen mit SQL, Transaktionen nach dem ACID-Prinzip. Für Bestellungen, Buchungen und Rechnungen ist das genau richtig. Aber was ist mit einem Produktkatalog, in dem ein E-Bike ganz andere Merkmale hat als ein Fahrradschloss? Mit Millionen von Sensormesswerten pro Tag? Mit den Daten einer App, die jede Woche neue Felder bekommt? Hier spielen NoSQL-Datenbanken ihre Stärken aus. Und weil die bekannteste Gruppe, die Dokumentendatenbanken, ihre Daten als JSON speichert, lernst Du in diesem Artikel auch die JSON-Notation gründlich kennen.
Das Beispiel: der Medienbestand einer Stadtbibliothek
Eine Stadtbibliothek verleiht Bücher, Filme und Brettspiele. Jede Medienart hat eigene Merkmale: Bücher haben eine ISBN und eine Seitenzahl, Filme eine Laufzeit und eine Altersfreigabe, Brettspiele eine Spielerzahl und eine Spieldauer. Im relationalen Modell gibt es dafür drei unbefriedigende Lösungen:
eine breite Tabelle
mediummit allen Spalten für alle Medienarten – bei einem Buch bleibenlaufzeit_min,fsk,spieler_minundspieler_maxleer (NULL),je Medienart eine eigene Tabelle – jede neue Medienart (Hörbuch, Tonie-Figur, Nähmaschine) erfordert eine Änderung des Datenbankschemas und des Programmcodes,
eine Merkmalstabelle
merkmal(medium_id, name, wert)– flexibel, aber alle Werte sind Text, und für jede Anzeige braucht man einen JOIN.
Ein Buch mit allen seinen Angaben ist eigentlich ein zusammengehöriges Ding. Genau so speichert es eine Dokumentendatenbank:
{
  "_id": 4711,
  "art": "Buch",
  "titel": "Sternenstaub über Sennestadt",
  "isbn": "978-3-16-148410-0",
  "seiten": 192,
  "autorinnen": ["Mara Lindqvist"],
  "schlagworte": ["Jugendbuch", "Umwelt"],
  "ausleihbar": true
}
Das Brettspiel steht in derselben Sammlung, hat aber andere Felder – und das ist erlaubt:
{
  "_id": 5120,
  "art": "Brettspiel",
  "titel": "Hafenkräne",
  "spieler": { "min": 3, "max": 4 },
  "spieldauer_min": 75,
  "ausleihbar": false
}
Warum überhaupt ein Datenbanksystem?
Viele Datenbestände beginnen als Tabellenkalkulation: eine Liste der Geräte, der Wartungen, der Kund*innen. Das geht gut, solange eine Person mit wenigen Hundert Zeilen arbeitet. Wächst der Bestand, wird die Datei langsam, mehrere Personen überschreiben sich gegenseitig, und niemand weiß mehr, welche Kopie aktuell ist. Ein Datenbankmanagementsystem (DBMS) – ob relational wie MariaDB oder NoSQL wie MongoDB – löst diese Probleme:
| Vorteil des DBMS | Beschreibung |
|---|---|
| Mehrbenutzerzugriff | Viele Personen und Programme arbeiten gleichzeitig mit denselben Daten; das DBMS sperrt und synchronisiert, sodass keine Änderung verloren geht. |
| Zugriffsschutz | Benutzerkonten mit Authentifizierung und fein abgestuften Rechten (z. B. nur lesen, nur bestimmte Tabellen), siehe SQL-DCL. |
| Datenintegrität | Datentypen, Pflichtfelder, eindeutige Schlüssel und Fremdschlüssel verhindern falsche oder widersprüchliche Einträge. |
| Transaktionen | Zusammengehörige Änderungen werden ganz oder gar nicht ausgeführt (ACID). |
| Leistung bei großen Datenmengen | Indizes und ein Abfrageoptimierer finden Daten auch in Millionen Datensätzen schnell; die Daten müssen nicht komplett in den Arbeitsspeicher geladen werden. |
| Abfragesprache und Schnittstellen | Auswertungen mit SQL bzw. einer Abfrage-API; Anwendungen greifen über das Netz zu. |
| Datensicherung und Wiederherstellung | Sicherungen im laufenden Betrieb, Wiederherstellung bis zu einem Zeitpunkt, Replikation. |
| Geringe Redundanz | Jede Information steht (bei normalisierten Tabellen) nur einmal; Änderungen wirken überall. |
Die Tabellenkalkulation bleibt ein gutes Werkzeug zum Auswerten und Darstellen – die Daten kommen dann aus der Datenbank (z. B. als CSV-Export).
Was bedeutet NoSQL?
NoSQL wird heute meist als „Not only SQL“ gelesen: Gemeint sind Datenbanksysteme, die ihre Daten nicht im relationalen Modell (Tabellen mit festen Spalten und Fremdschlüsseln) ablegen. „Nicht nur“ deshalb, weil viele dieser Systeme durchaus eine SQL-ähnliche Abfragesprache anbieten und umgekehrt relationale Systeme wie MariaDB, MySQL oder PostgreSQL inzwischen JSON-Spalten verarbeiten können. NoSQL ist also kein Gegensatz zu SQL, sondern eine Ergänzung.
Die NoSQL-Systeme werden nach ihrem Datenmodell in vier große Gruppen eingeteilt:
| Art | Datenmodell | typischer Einsatz | Beispiele |
|---|---|---|---|
| Schlüssel-Wert-Datenbank (key-value store) | Zu einem eindeutigen Schlüssel gehört ein Wert, dessen Inhalt die Datenbank nicht interpretiert. | Zwischenspeicher (Cache), Sitzungsdaten angemeldeter Nutzer*innen, Warenkörbe, Zähler | Redis, Valkey, Amazon DynamoDB |
| Dokumentendatenbank (document store) | Dokumente mit verschachtelten Feldern (meist JSON bzw. das binäre BSON), gruppiert in Sammlungen; Abfragen über die Felder möglich. | Produktkataloge, Inhalte von Webseiten und Apps, Profile, Formulardaten mit wechselnden Feldern | MongoDB, CouchDB, Couchbase |
| Spaltenfamilien-Datenbank (wide column store) | Zeilen mit einem Schlüssel und beliebig vielen, zu Familien gruppierten Spalten; auf viele Server verteilt. | sehr große Datenmengen mit vielen Schreibzugriffen, z. B. Messwerte, Protokolle, Klickdaten | Apache Cassandra, HBase |
| Graphdatenbank (graph database) | Knoten und Kanten (Beziehungen) mit Eigenschaften. | stark vernetzte Daten: Wegenetze, Empfehlungen („wer X kauft, kauft auch Y“), Abhängigkeiten, Betrugserkennung | Neo4j, Memgraph |
Daneben gibt es Zeitreihendatenbanken (siehe unten), Suchmaschinen-Indizes, Vektordatenbanken (für die Ähnlichkeitssuche, z. B. bei KI-Anwendungen), Objektdatenbanken (speichern Objekte einer Programmiersprache direkt), ältere hierarchische und netzwerkartige Datenbanken sowie Systeme, die mehrere Modelle gleichzeitig unterstützen (multi-model).
Der wesentliche Unterschied in einem Satz: SQL-Datenbanken speichern Daten relational in Tabellen mit festem Schema und logischen Verknüpfungen und werden einheitlich mit SQL abgefragt; NoSQL-Datenbanken speichern Daten nicht relational in anderen Formaten (Dokumente, Schlüssel-Wert-Paare, Graphen …), meist mit flexiblem Schema und herstellerspezifischen Abfrage-APIs. SQL-Datenbanken spielen ihre Stärken bei stark verknüpften Daten und Transaktionen aus, NoSQL-Datenbanken bei wechselnden oder unstrukturierten Daten und sehr großen, verteilten Datenmengen.
Zeitreihendatenbanken für Messwerte
Sensoren liefern im Sekunden- oder Minutentakt Messwerte: Temperatur, Luftfeuchte, CO₂, Stromverbrauch, Position. Jeder Datensatz besteht im Kern aus einem Zeitstempel, einem Messwert und wenigen Metainformationen (Tags), z. B. Sensor und Raum:
klima,raum=A104,sensor=klima-a104 co2=812,temp=21.4 1793091600(Beispiel im Line Protocol von InfluxDB: Messung, Tags, Felder, Zeitstempel – hier in Sekunden; ohne Angabe der Genauigkeit erwartet InfluxDB Nanosekunden.)
Eine Zeitreihendatenbank (time series database, z. B. InfluxDB, TimescaleDB, Prometheus) ist für genau diese Daten optimiert. Vorteile gegenüber anderen Datenmodellen:
Schnelles Schreiben: Neue Werte werden fast immer am Ende angehängt; das System ist auf sehr viele Schreibvorgänge pro Sekunde ausgelegt.
Zeitbezogene Abfragen sind eingebaut: Mittelwert, Minimum, Maximum je Zeitfenster („Durchschnitt der letzten Stunde je Raum“), Lücken füllen, Trends.
Aufbewahrungsregeln: Alte Rohdaten werden automatisch gelöscht oder zu Stunden- oder Tageswerten verdichtet (Downsampling).
Starke Kompression: Aufeinanderfolgende Zeitstempel und ähnliche Werte lassen sich sehr gut komprimieren.
Einfache Skalierung auf große Datenmengen, oft verteilt auf mehrere Server.
Und eine relationale Datenbank? Sie kann Messwerte in einer Tabelle messwert(zeit, sensor_id, wert) speichern. Fortlaufende Messwerte stehen aber untereinander in keiner Beziehung, sie folgen nur zeitlich aufeinander. Fremdschlüssel, JOINs, Normalisierung und Transaktionen über mehrere Tabellen werden kaum gebraucht, kosten aber Ressourcen; bei sehr vielen Werten wachsen Tabelle und Indizes schnell, und das Löschen alter Daten wird aufwendig. Für Stammdaten der Sensoren (Standort, Typ, Grenzwerte) ist die relationale Datenbank dagegen gut geeignet – häufig werden beide kombiniert.
In Aufgaben und in der Praxis begegnen Dir am häufigsten die Dokumentendatenbanken – um sie geht es im Rest des Artikels.
JSON: das Datenformat der Dokumentendatenbanken
Die JavaScript Object Notation (JSON) ist ein textbasiertes Format zum Speichern und Austauschen strukturierter Daten. Sie stammt aus JavaScript, ist aber völlig unabhängig von einer Programmiersprache und heute das Standardformat von Web-APIs. Festgelegt ist sie in RFC 8259 (IETF, Internetstandard STD 90) und gleichlautend in ECMA-404. Dateien haben die Endung .json, der Medientyp bei der Übertragung ist application/json.
Die Bausteine
JSON kennt genau zwei Strukturen:
Ein Objekt steht in geschweiften Klammern
{ }und enthält beliebig viele Schlüssel-Wert-Paare (name/value pairs), getrennt durch Kommas. Schlüssel und Wert werden durch einen Doppelpunkt getrennt. Der Schlüssel ist immer eine Zeichenkette in doppelten Anführungszeichen.Ein Array steht in eckigen Klammern
[ ]und enthält eine geordnete Liste von Werten, getrennt durch Kommas.
Ein Wert kann wieder ein Objekt oder ein Array sein. Dadurch lassen sich Daten beliebig tief verschachteln – JSON ist ein hierarchisches Format.
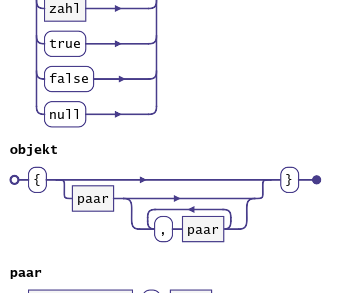
Das Syntaxdiagramm zeigt diese Regeln auf einen Blick: Ein Wert ist ein Objekt, ein Array, eine Zeichenkette, eine Zahl oder eines der Literale true, false und null; Objekte bestehen aus Paaren zeichenkette : wert, Arrays aus Werten, jeweils durch Kommas getrennt. Wie Du solche Diagramme liest, erklärt der Artikel EBNF und Syntaxdiagramme.

Die sechs Datentypen
| JSON-Datentyp | Schreibweise | Beispiel | typischer Datentyp im Programm |
|---|---|---|---|
| Zeichenkette (string) | in doppelten Anführungszeichen, Sonderzeichen mit \ maskiert |
"Bielefeld", "Zeile 1\nZeile 2" |
String |
| Zahl (number) | ohne Anführungszeichen, Dezimalpunkt, optional Exponent | 42, -3.5, 1.2e3 |
int, long, double, BigDecimal |
| Wahrheitswert (boolean) | klein geschrieben, ohne Anführungszeichen | true, false |
boolean |
| Nullwert | klein geschrieben | null |
null / None |
| Objekt (object) | { "schluessel": wert, … } |
{ "min": 3, "max": 4 } |
Objekt einer Klasse, Map, dict |
| Array (array) | [ wert, wert, … ] |
["Jugendbuch", "Umwelt"] |
Array, List |
JSON unterscheidet bei Zahlen nicht zwischen Ganzzahl und Kommazahl. Welcher Datentyp im Programm passt, entscheidest Du anhand der Bedeutung: Die Seitenzahl 192 wird ein int, ein Messwert wie 21.5 ein double, ein Array aus Kommazahlen ein double[] bzw. float[]. Geldbeträge liest man besser als exakte Dezimalzahl (BigDecimal) ein.
Ein ganzes Beispiel mit allen Datentypen:
{
  "station": "Infoterminal Foyer",
  "id": 17,
  "aktiv": true,
  "temperaturen": [21.5, 22.0, 23.25],
  "standort": { "gebaeude": "A", "etage": 0 },
  "wartung": null
}
Typische Fehler in JSON
JSON ist streng. Programme, die JSON einlesen (Parser), brechen bei jedem dieser Fehler ab:
| Fehler | falsch | richtig |
|---|---|---|
| Schlüssel ohne Anführungszeichen | { titel: "Momo" } |
{ "titel": "Momo" } |
| einfache Anführungszeichen | { 'titel': 'Momo' } |
{ "titel": "Momo" } |
| Komma nach dem letzten Element (trailing comma) | [1, 2, 3,] |
[1, 2, 3] |
| Dezimalkomma statt Dezimalpunkt | { "preis": 12,99 } |
{ "preis": 12.99 } |
| Kommentar | { "id": 1 // Artikel } |
Kommentare sind nicht erlaubt – Erläuterungen ggf. als eigenes Feld |
| großgeschriebene Literale | True, NULL |
true, null |
| fehlendes Komma zwischen Paaren | { "a": 1 "b": 2 } |
{ "a": 1, "b": 2 } |
Zwei weitere Punkte führen nicht zu einem Syntaxfehler, aber zu Ärger:
Doppelte Schlüssel in einem Objekt (
{ "id": 1, "id": 2 }) sind laut RFC 8259 nicht verboten, aber das Verhalten ist nicht festgelegt – manche Parser nehmen den ersten, manche den letzten Wert. Schlüssel sollten deshalb eindeutig sein.JSON hat keinen Datentyp für Datum und Uhrzeit. Üblich ist ein String im Format ISO 8601, z. B.
"2026-10-19T07:15:00+02:00". Wer stattdessen"19.10.26"oder"01-APR-23 12.41.08 PM"schreibt, zwingt jedes empfangende Programm, dieses Format zu kennen.
Manche Werkzeuge erlauben Erweiterungen wie Kommentare (JSON5, JSONC). Diese Dateien sind dann aber kein gültiges JSON mehr. Steht in einer Aufgabe oder Lösung eine Beschriftung wie // sensoren über einem Array, dient sie nur der Orientierung und gehört nicht zum JSON.
JSON prüfen
Ob ein Text gültiges JSON ist, prüfst Du mit jedem JSON-Parser, z. B. in der Kommandozeile mit python -m json.tool datei.json oder jq . datei.json, in der Entwicklungsumgebung oder mit einem Online-Validator (keine vertraulichen Daten hochladen!). Ob ein Dokument auch inhaltlich die erwarteten Felder und Datentypen hat, beschreibt man mit JSON Schema – vergleichbar mit einer XSD für XML.
JSON, XML und CSV im Vergleich
Wenn Daten zwischen Programmen ausgetauscht werden – Export aus einer Datenbank, Import in eine Cloud-Anwendung, Antwort einer Web-API –, kommen meist JSON, XML oder CSV zum Einsatz. Sie haben einen gemeinsamen Vorteil: Es sind offene, textbasierte Formate, die nicht an einen Hersteller, ein Betriebssystem oder eine Programmiersprache gebunden sind. Jedes System kann sie erzeugen und einlesen, Menschen können sie mit einem einfachen Texteditor lesen. Deshalb eignen sie sich für den Datenaustausch zwischen beliebigen Anwendungen.
<medium id="4711" art="Buch">
  <titel>Sternenstaub über Sennestadt</titel>
  <seiten>192</seiten>
  <autorin>Mara Lindqvist</autorin>
</medium>
id;art;titel;seiten;autorin
4711;Buch;Sternenstaub über Sennestadt;192;Mara Lindqvist| Merkmal | JSON | XML | CSV |
|---|---|---|---|
| Struktur | hierarchisch: Objekte und Arrays | hierarchisch: Baum aus Elementen mit Start- und Endtag, dazu Attribute | flach: Zeilen und Spalten, Trennzeichen (Komma, Semikolon) |
| Datentypen | string, number, boolean, null, object, array | im Dokument nur Text; Datentypen erst über ein Schema (XSD) | nur Text |
| Listen | eigenes Sprachmittel Array [ ] |
wiederholte Elemente | eine Zeile je Datensatz |
| Umfang (Overhead) | gering | groß (jeder Wert zwischen Start- und Endtag) | sehr gering |
| Prüfung der Struktur | JSON Schema | DTD, XSD, Schematron; sehr ausgereift | kaum standardisiert |
| Zusatzfunktionen | – | Namensräume, Kommentare, Transformation (XSLT), Abfragen (XPath) | – |
| typischer Einsatz | REST-APIs, Konfigurationsdateien, Dokumentendatenbanken | SOAP-Webservices, E-Rechnung, Office-Dateiformate, Branchenstandards | Export/Import von Tabellen, Tabellenkalkulation, Messwertreihen |
Vorteile von JSON gegenüber XML: kürzer und schneller zu lesen und zu verarbeiten, keine Endtags, eingebaute Arrays und Datentypen, in JavaScript direkt als Objekt nutzbar, von fast allen Web-APIs unterstützt. Vorteile von XML: sehr hoher Grad an Standardisierung, mächtige Werkzeuge für Validierung und Transformation, Namensräume zum Mischen mehrerer Vokabulare – deshalb setzen Behörden und Branchenstandards (z. B. XRechnung) auf XML.
CSV ist unschlagbar einfach und kompakt und wird von jeder Tabellenkalkulation geöffnet, kann aber keine verschachtelten Daten abbilden, kennt keine Datentypen und ist nicht einheitlich festgelegt (Trennzeichen, Dezimaltrennzeichen, Zeichenkodierung, Anführungszeichen). JSON ist die bessere Wahl, wenn Daten verschachtelt sind oder an eine API übergeben werden.
Begriffe: von der Tabelle zum Dokument
Eine Dokumentendatenbank ist ähnlich gegliedert wie eine relationale Datenbank – die Begriffe heißen nur anders:
| relationale Datenbank | dokumentenorientierte Datenbank (z. B. MongoDB) |
|---|---|
| Datenbank (database) | Datenbank (database) |
| Tabelle (table) | Sammlung (collection) |
| Datensatz, Zeile, Tupel (record, row) | Dokument (document) |
| Spalte, Attribut (column) | Feld (field) |
| Primärschlüssel | Feld _id (wird automatisch vergeben, falls es fehlt) |
| Fremdschlüssel und JOIN | eingebettetes Dokument oder Referenz ($lookup) |
Tabellenschema (CREATE TABLE) |
kein festes Schema nötig; optional Schemavalidierung |
Der wichtigste Unterschied steckt in der letzten Zeile: Alle Zeilen einer Tabelle haben dieselben Spalten. Die Dokumente einer Collection dürfen unterschiedliche Felder haben (schemafrei bzw. flexibles Schema). MongoDB speichert die Dokumente intern im binären Format BSON (Binary JSON), das zusätzliche Datentypen wie Datum, Ganzzahl, Dezimalzahl und ObjectId kennt. Nach außen arbeitest Du mit JSON-ähnlicher Notation.
Von Tabellen zu Dokumenten
Angenommen, die Bibliothek hat ihre Filialen und die dort aufgestellten Abholschränke bisher relational gespeichert:
| filiale_id | name | stadtteil |
|---|---|---|
| 1 | Stadtbibliothek Mitte | Mitte |
| 2 | Stadtteilbibliothek Nord | Schildesche |
| schrank_id | filiale_id | standort | faecher |
|---|---|---|---|
| 10 | 1 | Eingang Neumarkt | 48 |
| 11 | 1 | Parkhaus | 24 |
| 12 | 2 | Haupteingang | 32 |
Schritt 1: Tabellen in JSON umwandeln
Die einfachste Umwandlung bildet die Tabellen 1:1 ab:
jede Tabelle wird ein Array (bzw. eine Collection),
jede Zeile wird ein Objekt (Dokument),
jede Spalte wird ein Feld – der Spaltenname ist der Schlüssel, der Inhalt der Wert,
Zahlen stehen ohne, Texte mit Anführungszeichen,
NULLwirdnull,der Fremdschlüssel bleibt ein ganz normales Feld.
[
  { "filiale_id": 1, "name": "Stadtbibliothek Mitte", "stadtteil": "Mitte" },
  { "filiale_id": 2, "name": "Stadtteilbibliothek Nord", "stadtteil": "Schildesche" }
]
[
{ "schrank_id": 10, "filiale_id": 1, "standort": "Eingang Neumarkt", "faecher": 48 },
{ "schrank_id": 11, "filiale_id": 1, "standort": "Parkhaus", "faecher": 24 },
{ "schrank_id": 12, "filiale_id": 2, "standort": "Haupteingang", "faecher": 32 }
]Damit hast Du zwar JSON, aber noch keine Stärke der Dokumentendatenbank genutzt: Die Daten einer Filiale sind weiterhin auf zwei Collections verteilt.
Schritt 2: einbetten
Die Bibliotheks-App zeigt die Abholschränke immer zusammen mit der Filiale an, und jede Filiale hat nur wenige Schränke. Dann gehören die Schränke in das Filialdokument – als Array von eingebetteten Dokumenten (embedded documents):
[
  {
    "filiale_id": 1,
    "name": "Stadtbibliothek Mitte",
    "stadtteil": "Mitte",
    "abholschraenke": [
      { "schrank_id": 10, "standort": "Eingang Neumarkt", "faecher": 48 },
      { "schrank_id": 11, "standort": "Parkhaus", "faecher": 24 }
    ]
  },
  {
    "filiale_id": 2,
    "name": "Stadtteilbibliothek Nord",
    "stadtteil": "Schildesche",
    "abholschraenke": [
      { "schrank_id": 12, "standort": "Haupteingang", "faecher": 32 }
    ]
  }
]
Beachte: Der Fremdschlüssel filiale_id entfällt in den eingebetteten Schränken, denn die Zugehörigkeit ergibt sich aus der Verschachtelung. Die schrank_id darf bleiben, wenn Schränke einzeln angesprochen werden sollen. Jetzt liefert ein einziger Lesezugriff alles, was die App braucht – ohne JOIN.
Einbetten oder referenzieren?
| einbetten, wenn … | referenzieren (ID speichern), wenn … |
|---|---|
| die Daten fast immer gemeinsam gelesen werden, | die Daten oft einzeln gelesen oder geändert werden, |
| die Anzahl der Unterelemente klein und begrenzt ist, | die Anzahl unbegrenzt wachsen kann (z. B. alle Ausleihen eines Mediums seit Jahren), |
| die Unterelemente zu genau einem Elterndokument gehören (1:1, 1:n), | dieselben Daten von vielen Dokumenten gebraucht werden (n:m, z. B. eine Autorin mit vielen Büchern), |
| sich die eingebetteten Daten selten ändern. | Änderungen sonst in vielen Kopien nachgezogen werden müssten (Redundanz, Änderungsanomalie). |
Eine harte Grenze gibt es zusätzlich: Ein MongoDB-Dokument darf höchstens 16 MB groß sein. Wer alle Ausleihen eines beliebten Buches einbettet, stößt irgendwann daran.
Eingebettete Daten sind bewusst redundant: Würde man den Namen der Autorin in jedes Buchdokument kopieren, müsste man eine Namensänderung in allen Büchern nachziehen. Dokumentendatenbanken nehmen diese Redundanz in Kauf, um schneller lesen zu können – die Normalisierung relationaler Datenbanken verfolgt das umgekehrte Ziel (siehe Normalisierung).
Mit Dokumenten arbeiten (MongoDB)
In MongoDB greifst Du nicht mit SQL zu, sondern über eine Programmierschnittstelle (API) mit Methoden wie find(), insertOne() oder updateOne() – aus der MongoDB-Shell mongosh oder aus Java, Python, JavaScript & Co. Die Filter sind selbst JSON-Dokumente:
// alle ausleihbaren Bücher mit mehr als 300 Seiten, nur Titel und Seiten anzeigen
db.medien.find(
  { art: "Buch", ausleihbar: true, seiten: { $gt: 300 } },
  { titel: 1, seiten: 1 }
)

// Brettspiele ab 2 Spieler*innen: Punktnotation für eingebettete Felder
db.medien.find({ "spieler.min": { $lte: 2 } })

// Filter auf ein Array: findet alle Dokumente, deren Array "schlagworte" den Wert enthält
db.medien.find({ schlagworte: "Umwelt" })

// neues Dokument einfügen
db.medien.insertOne({ art: "Hörbuch", titel: "Momo", laufzeit_min: 412 })

// Feld ändern ($set) und Element an ein Array anhängen ($push)
db.medien.updateOne({ _id: 4711 }, { $set: { ausleihbar: false }, $push: { schlagworte: "Klassiker" } })
Zum Vergleich die erste Abfrage in SQL: SELECT titel, seiten FROM medium WHERE art = 'Buch' AND ausleihbar = TRUE AND seiten > 300; – anders als hier liefert MongoDB bei der Projektion { titel: 1, seiten: 1 } zusätzlich das Feld _id mit, solange es nicht mit _id: 0 ausgeblendet wird. Felder, die in einem Dokument fehlen, erfüllen eine Bedingung wie seiten > 300 einfach nicht – das Dokument erscheint nicht im Ergebnis.
Auch relationale Systeme können inzwischen mit JSON umgehen: MariaDB kennt den Datentyp JSON (intern LONGTEXT mit Prüfung JSON_VALID) und Funktionen wie JSON_VALUE(spalte, '$.spieler.min') oder JSON_ARRAYAGG(). Für einzelne flexible Merkmale in einer sonst relationalen Datenbank ist das oft der pragmatische Weg.
Flexibles Schema: Chance und Risiko
Das flexible Schema ist der größte Vorteil von Dokumentendatenbanken: Ein neues Feld (z. B. barrierefrei bei den Abholschränken) kann sofort gespeichert werden, ohne ALTER TABLE, ohne Migration und ohne Ausfallzeit. Das beschleunigt die Entwicklung, besonders in frühen Projektphasen und bei Daten, deren Struktur sich häufig ändert.
Die Kehrseite: Wenn die Datenbank nichts prüft, prüft niemand. Typische Datenqualitätsprobleme sind
uneinheitliche Feldnamen (
seiten,Seiten,seitenzahl),wechselnde Datentypen (
"seiten": "192"als Text in einem,192als Zahl im anderen Dokument),fehlende Pflichtfelder (ein Medium ohne
titel).
Gegenmaßnahmen: eine klare Datenmodellierung trotz Schemafreiheit (dokumentierte Felder), Prüfung im Programm vor dem Speichern, und die Schemavalidierung der Datenbank (in MongoDB per $jsonSchema), die Dokumente mit falschen Typen oder fehlenden Pflichtfeldern zurückweist.
Verteilte Datenbanken: ACID, CAP und BASE
Relationale Datenbanken garantieren für Transaktionen die ACID-Eigenschaften (Atomicity, Consistency, Isolation, Durability) – ausführlich erklärt im Artikel Datenbankkonzepte. Auf einem Server ist das gut machbar. Viele NoSQL-Systeme sind aber dafür gebaut, Daten auf viele Server zu verteilen (Replikation für Ausfallsicherheit, Sharding für große Datenmengen).
Skalierung: nach oben oder in die Breite
Vertikale Skalierung (scale up): ein größerer Server mit mehr CPU, RAM und schnelleren SSDs. Einfach, aber teuer und irgendwann am Ende.
Horizontale Skalierung (scale out): mehr Server, die sich die Daten und die Last teilen. Theoretisch fast unbegrenzt, aber die Server müssen sich über die Daten abstimmen.
Relationale Datenbanken skalieren klassisch vertikal; viele NoSQL-Datenbanken sind von Anfang an für die horizontale Skalierung ausgelegt.
Das CAP-Theorem
Ein verteiltes System soll drei Dinge leisten:
Consistency (Konsistenz): Alle Knoten liefern zur gleichen Zeit denselben, aktuellen Stand.
Availability (Verfügbarkeit): Jede Anfrage bekommt eine Antwort.
Partition tolerance (Partitionstoleranz): Das System arbeitet weiter, auch wenn die Netzwerkverbindung zwischen Knoten unterbrochen ist.
Das CAP-Theorem (Eric Brewer, 2000) besagt: Bei einer Netzwerkstörung (P) muss sich ein verteiltes System entscheiden, ob es konsistent bleibt (und dann Anfragen ablehnt) oder verfügbar bleibt (und dann eventuell veraltete Daten liefert). Beides zugleich geht nicht. Deshalb ist es schwer, in verteilten Datenbanken alle ACID-Eigenschaften einzuhalten und gleichzeitig eine hohe Verfügbarkeit zu erreichen.
BASE statt ACID
Viele NoSQL-Systeme entscheiden sich für Verfügbarkeit und arbeiten nach dem BASE-Prinzip:
Basically Available: Das System antwortet grundsätzlich immer, auch bei Teilausfällen.
Soft State: Der Zustand kann sich ändern, ohne dass gerade jemand schreibt, weil Änderungen noch zwischen den Knoten verteilt werden.
Eventually Consistent: Wenn keine neuen Änderungen kommen, sind nach kurzer Zeit alle Kopien wieder gleich (letztendliche Konsistenz).
Ob das tragbar ist, hängt von den Daten ab: Wenn eine Anzeige einige Sekunden lang einen alten Stand zeigt, ist das meist unkritisch. Wenn dagegen zwei Personen gleichzeitig den letzten freien Platz buchen oder ein Kontostand doppelt abgebucht wird, braucht man strenge Konsistenz.
Die Grenzen verschwimmen übrigens: MongoDB unterstützt seit Version 4.0 Transaktionen über mehrere Dokumente mit ACID-Garantien (zunächst in Replica Sets, seit Version 4.2 auch in verteilten Sharded Clusters), und es gibt verteilte SQL-Datenbanken. Die Faustregel „relational = ACID, NoSQL = BASE“ beschreibt die ursprüngliche Ausrichtung, nicht jedes heutige Produkt.
Big Data: wenn klassische Modelle an Grenzen stoßen
Big Data bezeichnet Datenmengen, die so groß, so schnell entstehend oder so vielfältig sind, dass klassische Datenbanken und Auswertungsverfahren sie kaum noch verarbeiten können. Beschrieben wird Big Data mit den drei V:
Volume (Menge): Datenmengen im Bereich von Tera- bis Petabyte, z. B. die Positionsdaten Tausender Fahrzeuge über Jahre.
Velocity (Geschwindigkeit): Die Daten entstehen sehr schnell und sollen oft in Echtzeit verarbeitet werden, z. B. viele Sensorwerte pro Sekunde.
Variety (Vielfalt): strukturierte (Tabellen), halbstrukturierte (JSON, Protokolle) und unstrukturierte Daten (Bilder, Videos, Texte, Audio) gemischt.
Oft kommen Veracity (Verlässlichkeit, Datenqualität) und Value (der Nutzen, der sich aus den Daten ziehen lässt) hinzu. Mehr zu Big Data im Zusammenspiel mit Edge- und Cloud-Computing steht im Artikel Edge, Fog und Cloud.
Eignen sich ER-Modell und relationales Datenmodell für Big Data? In der klassischen Form nur eingeschränkt: Das ER-Modell setzt voraus, dass die Struktur der Daten vorab bekannt und fest ist – unstrukturierte oder sich ständig ändernde Daten passen nicht in ein festes Tabellenschema. Relationale Datenbanken skalieren vor allem vertikal und kommen bei sehr hohen Schreibraten an Grenzen. Für Big Data werden deshalb meist NoSQL-Datenbanken (Spaltenfamilien, Dokumente, Zeitreihen), verteilte Dateisysteme und Data Lakes eingesetzt. Für die gut strukturierten Teile (Kundendaten, Verträge, verdichtete Kennzahlen im Data Warehouse) bleibt das relationale Modell sinnvoll; es gibt auch verteilte SQL-Datenbanken. Eine gute Antwort entscheidet sich also klar und begründet mit der Art der Daten.
Relational oder dokumentenorientiert? Eine Entscheidungshilfe
| Kriterium | relationale Datenbank (SQL) | dokumentenorientierte Datenbank (NoSQL) |
|---|---|---|
| Datenmodell | Tabellen mit Zeilen und Spalten, Beziehungen über Fremdschlüssel | Dokumente (JSON/BSON) in Collections, verschachtelt |
| Schema | fest, vorab definiert (statisch) | flexibel, je Dokument verschieden (dynamisch) |
| Abfragesprache | standardisiertes SQL | herstellerspezifische API bzw. Abfragesprache |
| Beziehungen | JOIN über beliebig viele Tabellen | Einbetten; Referenzen möglich, aber aufwendiger |
| Redundanz | gering (Normalisierung) | bewusst höher (eingebettete Kopien) |
| Skalierung | vor allem vertikal (scale up) | vor allem horizontal (scale out) |
| Transaktionen und Konsistenz | ACID, referentielle Integrität durch das DBMS | ursprünglich BASE; Konsistenz oft Aufgabe der Anwendung |
| Stärken | strukturierte Daten, viele Beziehungen, Transaktionen, Auswertungen | wechselnde Strukturen, zusammengehörige Daten lesen, große Datenmengen, schnelle Weiterentwicklung |
Für eine relationale Datenbank sprechen z. B.: Die Daten sind klar strukturiert und stark miteinander verknüpft; Geld, Bestände oder Plätze werden gebucht (Transaktionssicherheit, ACID); die referentielle Integrität soll das DBMS sicherstellen; vielfältige Auswertungen mit SQL sind nötig; das Team kennt SQL.
Für eine dokumentenorientierte Datenbank sprechen z. B.: Die Datensätze haben unterschiedliche oder sich häufig ändernde Felder; zusammengehörige Daten werden fast immer gemeinsam gelesen; die Datenmenge oder die Zahl der Zugriffe ist sehr groß und soll auf viele Server verteilt werden; die Daten kommen ohnehin als JSON (z. B. aus einer REST-API) und sollen so weiterverarbeitet werden.
In der Praxis kombinieren viele Systeme beide Welten (polyglotte Persistenz): Bestellungen und Rechnungen in MariaDB, der Produktkatalog in einer Dokumentendatenbank, Sitzungsdaten in Redis.
Wenn Du in einer Aufgabe eine Variante vorschlagen sollst, gilt: Entscheide Dich klar für eine Variante und begründe mit Argumenten, die zum Anwendungsfall passen. „NoSQL ist moderner“ ist kein Argument, „Die Räume haben je nach Typ unterschiedliche Ausstattungsmerkmale, die sich ohne Schemaänderung speichern lassen“ schon.
Typische Missverständnisse
„NoSQL heißt: kein SQL.“ – Gemeint ist „nicht nur SQL“ bzw. „nicht relational“. Viele Systeme haben SQL-ähnliche Abfragesprachen.
„Schemafrei heißt: Ich muss nichts modellieren.“ – Gerade die Frage „einbetten oder referenzieren?“ verlangt eine sorgfältige Modellierung, die sich an den Zugriffen der Anwendung orientiert.
„NoSQL ist immer schneller.“ – Schneller ist das Lesen zusammengehöriger Daten in einem Dokument. Auswertungen über viele Dokumente oder viele Beziehungen sind in einer relationalen Datenbank oft einfacher und schneller.
„JSON darf Kommentare enthalten.“ – Nein, Kommentare sind nicht Teil des Standards.
„Zahlen in Anführungszeichen sind auch Zahlen.“ –
"192"ist ein String. Sortieren und Rechnen funktionieren dann nicht wie erwartet.
Leitfragen
- Was bedeutet NoSQL, und welche vier Arten von NoSQL-Datenbanken gibt es? Nenne für jede ein Einsatzbeispiel.
NoSQL wird meist als „Not only SQL“ gelesen und meint Datenbanksysteme, die ihre Daten nicht im relationalen Modell ablegen. Es gibt Schlüssel-Wert-Datenbanken (z. B. Cache oder Sitzungsdaten), Dokumentendatenbanken (Produktkataloge, Profile), Spaltenfamilien-Datenbanken (große Mengen an Messwerten oder Protokollen) und Graphdatenbanken (Wegenetze, Empfehlungen); siehe Abschnitt „Was bedeutet NoSQL?“.
- Welche relationalen Fachbegriffe entsprechen Collection, Document und Field?
Eine Collection (Sammlung) entspricht einer Tabelle, ein Document (Dokument) einem Datensatz bzw. einer Zeile und ein Field (Feld) einer Spalte bzw. einem Attribut. Das Feld _id übernimmt die Rolle des Primärschlüssels; siehe Abschnitt „Begriffe: von der Tabelle zum Dokument“.
- Welche sechs Datentypen kennt JSON, und welche Syntaxregeln werden am häufigsten verletzt?
JSON kennt Zeichenkette, Zahl, Wahrheitswert, Nullwert, Objekt und Array. Am häufigsten verletzt werden die Regeln, dass Schlüssel und Strings in doppelten Anführungszeichen stehen, dass nach dem letzten Element kein Komma folgt, dass Zahlen einen Dezimalpunkt haben, dass Kommentare verboten sind und dass true, false und null klein geschrieben werden; siehe Abschnitt „Die sechs Datentypen“ und Abschnitt „Typische Fehler in JSON“.
- Wie wandelst Du zwei über einen Fremdschlüssel verbundene Tabellen in JSON um, und wie bettest Du die Kind-Datensätze in das Elterndokument ein? Wann solltest Du lieber referenzieren?
Zuerst wird jede Tabelle ein Array, jede Zeile ein Objekt und jede Spalte ein Feld; der Fremdschlüssel bleibt ein normales Feld. Beim Einbetten nimmst Du die Kind-Datensätze als Array in das Elterndokument auf und lässt den Fremdschlüssel weg, weil sich die Zugehörigkeit aus der Verschachtelung ergibt. Referenzieren ist besser, wenn die Daten oft einzeln gelesen oder geändert werden, unbegrenzt wachsen können oder von vielen Dokumenten gebraucht werden (n:m); siehe Abschnitt „Schritt 1: Tabellen in JSON umwandeln“, Abschnitt „Schritt 2: einbetten“ und Abschnitt „Einbetten oder referenzieren?“.
- Was ist der gemeinsame Vorteil von JSON, XML und CSV? Nenne je zwei Merkmale von JSON und XML.
Alle drei sind offene, textbasierte Formate, die an keinen Hersteller, kein Betriebssystem und keine Programmiersprache gebunden sind und sich deshalb für den Datenaustausch eignen. JSON ist hierarchisch, kompakt und hat eingebaute Arrays und Datentypen; XML ist ein Baum aus Elementen mit Start- und Endtags, sehr stark standardisiert und bietet Validierung (XSD), Namensräume und Transformation (XSLT); siehe Abschnitt „JSON, XML und CSV im Vergleich“.
- Nenne Kriterien, in denen sich relationale und dokumentenorientierte Datenbanken unterscheiden, und gib die jeweilige Ausprägung an.
Datenmodell (Tabellen mit Fremdschlüsseln vs. verschachtelte Dokumente in Collections), Schema (fest vs. flexibel), Abfragesprache (standardisiertes SQL vs. herstellerspezifische API), Beziehungen (JOIN vs. Einbetten), Redundanz (gering durch Normalisierung vs. bewusst höher), Skalierung (vor allem vertikal vs. vor allem horizontal) sowie Transaktionen (ACID vs. ursprünglich BASE); siehe Abschnitt „Relational oder dokumentenorientiert? Eine Entscheidungshilfe“.
- Warum ist es schwer, in einer verteilten Datenbank ACID und hohe Verfügbarkeit zugleich zu erreichen, und was bedeutet BASE?
Nach dem CAP-Theorem muss sich ein verteiltes System bei einer Netzwerkstörung entscheiden, ob es konsistent bleibt und Anfragen ablehnt oder verfügbar bleibt und eventuell veraltete Daten liefert. Viele NoSQL-Systeme wählen die Verfügbarkeit und arbeiten nach BASE: Basically Available, Soft State und Eventually Consistent, d. h. nach kurzer Zeit sind alle Kopien wieder gleich; siehe Abschnitt „Das CAP-Theorem“ und Abschnitt „BASE statt ACID“.
- Für welche Daten einer Anwendung würdest Du eine relationale, für welche eine dokumentenorientierte Datenbank vorschlagen – und mit welchen Argumenten?
Relational speicherst Du klar strukturierte, stark verknüpfte Daten und alles, was gebucht wird (Geld, Bestände, Plätze), weil dort ACID, referentielle Integrität und SQL-Auswertungen zählen. Dokumentenorientiert eignen sich Daten mit wechselnden Feldern, die meist zusammen gelesen werden, sehr große Datenmengen oder Daten, die ohnehin als JSON ankommen, etwa ein Produktkatalog. Entscheide Dich klar und begründe mit Argumenten aus dem Anwendungsfall; siehe Abschnitt „Relational oder dokumentenorientiert? Eine Entscheidungshilfe“.
- Welche Vorteile hat ein DBMS gegenüber einer Tabellenkalkulation, und welche Vorteile bietet eine Zeitreihendatenbank für Messwerte?
Ein DBMS erlaubt gleichzeitigen Mehrbenutzerzugriff, schützt die Daten mit Benutzerkonten und Rechten, sichert die Integrität durch Datentypen und Schlüssel, bietet Transaktionen, ist auch bei großen Datenmengen schnell und lässt sich im Betrieb sichern. Eine Zeitreihendatenbank schreibt fortlaufende Messwerte (Zeitstempel, Wert, Tags) sehr schnell, bietet eingebaute Zeitfunktionen (Mittelwert je Zeitfenster), löscht oder verdichtet alte Daten automatisch und komprimiert stark; siehe Abschnitt „Warum überhaupt ein Datenbanksystem?“ und Abschnitt „Zeitreihendatenbanken für Messwerte“.
- Was bedeutet Big Data, und passt dafür das relationale Modell?
Big Data sind Datenmengen, die durch Volume (Menge), Velocity (Geschwindigkeit) und Variety (Vielfalt) klassische Datenbanken überfordern. ER-Modell und relationales Modell setzen eine feste, vorab bekannte Struktur voraus und skalieren vor allem vertikal; für unstrukturierte, schnell entstehende Daten sind NoSQL-Datenbanken und verteilte Speicher besser geeignet, für strukturierte Teile bleibt das relationale Modell sinnvoll; siehe Abschnitt „Big Data“.
Links und weitere Informationen
Voraussetzungen auf oer-informatik.de: Das Relationenmodell, Normalisierung, Datenbankkonzepte: Transaktionen und ACID
Verwandte Beiträge: REST-Grundlagen (JSON als Austauschformat von Web-APIs), Einstieg in XML, Edge, Fog und Cloud: Big Data und Predictive Maintenance, MQTT (Sensordaten übertragen)
Übungen: Übungsaufgaben zu NoSQL, Dokumentendatenbanken und JSON
Standard: RFC 8259: The JavaScript Object Notation (JSON) Data Interchange Format und ECMA-404
für den Einstieg: json.org – Syntaxdiagramme auf Deutsch
zum Nachschlagen: MongoDB-Handbuch (englisch): Dokumente, Datenmodellierung, Abfragen und MongoDB: Limits and Thresholds
zum Nachschlagen (MariaDB): MariaDB: JSON-Funktionen
zum Vertiefen: JSON Schema
Hinweis zur Nachnutzung als Open Educational Resource (OER)
Dieser Artikel und seine Texte, Bilder, Grafiken, Code und sonstiger Inhalt sind - sofern nicht anders angegeben - lizenziert unter CC BY 4.0. Nennung gemäß TULLU-Regel bitte wie folgt: “NoSQL und Dokumentendatenbanken: Daten als JSON speichern” von oer-informatik.de (H. Stein), Lizenz: CC BY 4.0. Der Artikel wurde unter https://oer-informatik.de/nosql-json veröffentlicht, die Quelltexte sind in weiterverarbeitbarer Form verfügbar im Repository unter https://gitlab.com/oer-informatik/db-design/datenbankentwurf. Erstellt mit KI-Assistenz; von mir umfassend redaktionell überarbeitet, geprüft und freigegeben. Stand: 27.10.2026.
[Kommentare zum Artikel lesen, schreiben] / [Artikel teilen] / [gitlab-Issue zum Artikel schreiben]